コインを何度も投げると、表の出る割合は 1 / 2 1/2 1/2 1000 1000 1000
確率変数列の「収束」には少なくとも 4 通りある。強い順に 概収束 (ほとんどすべての実験記録で値が収束すること)→ 確率収束 → 分布収束 、および L p L^p L p
大数の法則 は「標本平均 X ˉ n \bar{X}_n X ˉ n μ \mu μ n n n 中心極限定理 は、大数の法則で消えた誤差 X ˉ n − μ \bar{X}_n - \mu X ˉ n − μ n \sqrt{n} n 正規分布 N ( 0 , σ 2 ) N(0,\sigma^2) N ( 0 , σ 2 ) 証明の道具は特性関数 (分布を調べるための道具となる関数で、第 5 節で定義します)とレヴィの連続性定理です。φ ( t ) = 1 − t 2 / 2 + o ( t 2 ) \varphi(t) = 1 - t^2/2 + o(t^2) φ ( t ) = 1 − t 2 /2 + o ( t 2 ) ( 1 + c n / n ) n → e c (1 + c_n/n)^n \to e^{c} ( 1 + c n / n ) n → e c
応用面での結論は「精度は標本数の平方根でしか上がらない」ことです。誤差を 10 10 10 1 1 1 100 100 100 1 / n 1/\sqrt{n} 1/ n
確率変数 : 試行の結果に実数を対応させる可測関数のこと。→ 確率変数 期待値 : 確率変数の値を確率で重みづけして平均したもの(ルベーグ積分で定義されます)。→ 期待値 分散 : 平均からのずれの 2 乗の期待値で、散らばりの大きさを表す量。→ 分散 可測関数 : 確率や積分を考えられるように、値の範囲で決まる集合が可測になる関数。→ 可測関数 分布関数 : 確率変数が x x x x x x 分布関数 正規分布 : 平均のまわりに左右対称な釣り鐘の形に広がる分布。→ 正規分布 コインを 10 10 10 7 7 7 10,000 10{,}000 10 , 000 7,000 7{,}000 7 , 000 確率空間とコルモゴロフの公理 は「確率とは全測度 1 1 1
この橋渡しを最初に定理として証明したのがヤコブ・ベルヌーイで、遺著『推測法』(1713) に収められた結果は今日ベルヌーイの大数の法則 と呼ばれます。彼は「これは素人でも本能的に知っていることだが、科学的に証明しなければならない」と書き、20 20 20 n n n
一方、大数の法則は誤差の大きさ を教えてくれません。X ˉ n → μ \bar{X}_n \to \mu X ˉ n → μ n = 10,000 n = 10{,}000 n = 10 , 000 n n n 元の分布の形によらず、和の分布は正規分布に収束する 。サイコロでも、指数分布でも、値が 0 0 0 1 1 1
この記事では、まず収束概念を整理し(第 3 節)、大数の法則を弱・強の両方で証明し(第 4 節)、特性関数を使って中心極限定理を証明します(第 5 節)。最後に、これらが統計的推定と機械学習でどう使われるかを具体的な数値とともに見ます(第 6 節)。
以下、確率空間 ( Ω , F , P ) (\Omega, \mathcal{F}, P) ( Ω , F , P ) 可測関数 X : Ω → R X : \Omega \to \mathbb{R} X : Ω → R E [ X ] = ∫ Ω X d P E[X] = \int_\Omega X \, dP E [ X ] = ∫ Ω X d P 確率変数と期待値 、とくに定義 4.1[確率変数と期待値] を参照)。N = { 1 , 2 , … } \mathbb{N} = \{1, 2, \ldots\} N = { 1 , 2 , … }
記号を確認しておきます。X 1 , X 2 , … X_1, X_2, \ldots X 1 , X 2 , … 独立同分布 (independent and identically distributed, i.i.d.) であるとは、互いに独立(定義 2.3[確率変数と期待値] )で、かつすべて同じ分布に従うことをいいます。このとき
S n = ∑ i = 1 n X i , X ˉ n = S n n S_n = \sum_{i=1}^{n} X_i, \qquad \bar{X}_n = \frac{S_n}{n} S n = i = 1 ∑ n X i , X ˉ n = n S n をそれぞれ部分和 、標本平均 と書きます。μ = E [ X 1 ] \mu = E[X_1] μ = E [ X 1 ] σ 2 = Var ( X 1 ) = E [ ( X 1 − μ ) 2 ] \sigma^2 = \operatorname{Var}(X_1) = E[(X_1-\mu)^2] σ 2 = Var ( X 1 ) = E [( X 1 − μ ) 2 ] 分散 は加法的(命題 5.3[確率変数と期待値] )なので
Var ( S n ) = n σ 2 , Var ( X ˉ n ) = σ 2 n \operatorname{Var}(S_n) = n\sigma^2, \qquad \operatorname{Var}(\bar{X}_n) = \frac{\sigma^2}{n} Var ( S n ) = n σ 2 , Var ( X ˉ n ) = n σ 2 です。この Var ( X ˉ n ) = σ 2 / n \operatorname{Var}(\bar{X}_n) = \sigma^2/n Var ( X ˉ n ) = σ 2 / n σ / n \sigma/\sqrt{n} σ / n 誤差は n n n n \sqrt{n} n ということです。
「ほとんど確実に」(almost surely, a.s.) とは、確率 1 1 1 A ( ω ) A(\omega) A ( ω ) P ( { ω : A ( ω ) が成り立つ } ) = 1 P(\{\omega : A(\omega) \text{ が成り立つ}\}) = 1 P ({ ω : A ( ω ) が成り立つ }) = 1
数列の収束は一通りですが、確率変数列は Ω \Omega Ω 関数列と一様収束 )。確率論ではさらに「分布だけが近づく」という弱い概念が加わります。
定義 3.1 (概収束 ) ↗
確率変数列 ( X n ) n ∈ N (X_n)_{n \in \mathbb{N}} ( X n ) n ∈ N X X X ( Ω , F , P ) (\Omega, \mathcal{F}, P) ( Ω , F , P )
P ( { ω ∈ Ω : lim n → ∞ X n ( ω ) = X ( ω ) } ) = 1 P\left(\left\{\omega \in \Omega : \lim_{n \to \infty} X_n(\omega) = X(\omega)\right\}\right) = 1 P ( { ω ∈ Ω : n → ∞ lim X n ( ω ) = X ( ω ) } ) = 1 が成り立つとき、X n X_n X n X X X 概収束する といい、X n → a.s. X X_n \xrightarrow{\text{a.s.}} X X n a.s. X
概収束は「各 ω \omega ω X n ( ω ) X_n(\omega) X n ( ω ) 1 1 1 ω \omega ω
定義 3.2 (確率収束 ) ↗
( X n ) (X_n) ( X n ) X X X ε > 0 \varepsilon > 0 ε > 0
lim n → ∞ P ( ∣ X n − X ∣ > ε ) = 0 \lim_{n \to \infty} P(|X_n - X| > \varepsilon) = 0 n → ∞ lim P ( ∣ X n − X ∣ > ε ) = 0 が成り立つとき、X n X_n X n X X X 確率収束する といい、X n → P X X_n \xrightarrow{P} X X n P X
確率収束は「各 n n n X n X_n X n X X X ε \varepsilon ε n n n ω \omega ω
定義 3.3 (L p L^p L p ↗
p ≥ 1 p \ge 1 p ≥ 1 E [ ∣ X n ∣ p ] < ∞ E[|X_n|^p] < \infty E [ ∣ X n ∣ p ] < ∞ E [ ∣ X ∣ p ] < ∞ E[|X|^p] < \infty E [ ∣ X ∣ p ] < ∞
lim n → ∞ E [ ∣ X n − X ∣ p ] = 0 \lim_{n \to \infty} E\left[|X_n - X|^p\right] = 0 n → ∞ lim E [ ∣ X n − X ∣ p ] = 0 が成り立つとき、X n X_n X n X X X L p L^p L p p = 2 p=2 p = 2 平均二乗収束 )といい、X n → L p X X_n \xrightarrow{L^p} X X n L p X
L p L^p L p L p L^p L p L^p空間と関数解析への導入 の定義 3.1[L^p 空間と関数解析への導入] )。誤差を「平均的な大きさ」で測る立場です。
定義 3.4 (分布収束(弱収束) ) ↗
X n X_n X n F n ( x ) = P ( X n ≤ x ) F_n(x) = P(X_n \le x) F n ( x ) = P ( X n ≤ x ) X X X F ( x ) = P ( X ≤ x ) F(x) = P(X \le x) F ( x ) = P ( X ≤ x ) F F F x x x
lim n → ∞ F n ( x ) = F ( x ) \lim_{n \to \infty} F_n(x) = F(x) n → ∞ lim F n ( x ) = F ( x ) が成り立つとき、X n X_n X n X X X 分布収束する といい、X n → d X X_n \xrightarrow{d} X X n d X X n X_n X n
分布収束だけは、確率変数そのものではなく分布 の収束です。したがって X n X_n X n X X X F F F X n ≡ 1 / n X_n \equiv 1/n X n ≡ 1/ n X ≡ 0 X \equiv 0 X ≡ 0 F n ( 0 ) = P ( 1 / n ≤ 0 ) = 0 F_n(0) = P(1/n \le 0) = 0 F n ( 0 ) = P ( 1/ n ≤ 0 ) = 0 F ( 0 ) = 1 F(0) = 1 F ( 0 ) = 1 x = 0 x=0 x = 0 0 0 0 1 1 1
四つの収束概念の含意関係。逆向きの矢印は一般には成立しない 命題 3.5 (マルコフ・チェビシェフの不等式 ) ✓
Y Y Y a > 0 a > 0 a > 0
P ( Y ≥ a ) ≤ E [ Y ] a P(Y \ge a) \le \frac{E[Y]}{a} P ( Y ≥ a ) ≤ a E [ Y ] が成り立つ(マルコフの不等式)。特に E [ X 2 ] < ∞ E[X^2] < \infty E [ X 2 ] < ∞ X X X ε > 0 \varepsilon > 0 ε > 0 μ = E [ X ] \mu = E[X] μ = E [ X ]
P ( ∣ X − μ ∣ ≥ ε ) ≤ Var ( X ) ε 2 P(|X - \mu| \ge \varepsilon) \le \frac{\operatorname{Var}(X)}{\varepsilon^2} P ( ∣ X − μ ∣ ≥ ε ) ≤ ε 2 Var ( X ) が成り立つ(チェビシェフの不等式)。
証明(命題 3.5) Y ≥ 0 Y \ge 0 Y ≥ 0 A = { Y ≥ a } A = \{Y \ge a\} A = { Y ≥ a } 1 A \mathbf{1}_A 1 A Y ≥ Y 1 A ≥ a 1 A Y \ge Y\mathbf{1}_A \ge a \mathbf{1}_A Y ≥ Y 1 A ≥ a 1 A ω ∈ A \omega \in A ω ∈ A Y ( ω ) ≥ a Y(\omega) \ge a Y ( ω ) ≥ a ω ∉ A \omega \notin A ω ∈ / A 0 0 0 Y ( ω ) ≥ 0 Y(\omega) \ge 0 Y ( ω ) ≥ 0
E [ Y ] ≥ E [ a 1 A ] = a P ( A ) = a P ( Y ≥ a ) E[Y] \ge E[a \mathbf{1}_A] = a\,P(A) = a\,P(Y \ge a) E [ Y ] ≥ E [ a 1 A ] = a P ( A ) = a P ( Y ≥ a ) となり、a > 0 a > 0 a > 0
チェビシェフの不等式は、Y = ( X − μ ) 2 ≥ 0 Y = (X-\mu)^2 \ge 0 Y = ( X − μ ) 2 ≥ 0 a = ε 2 > 0 a = \varepsilon^2 > 0 a = ε 2 > 0 { ∣ X − μ ∣ ≥ ε } = { ( X − μ ) 2 ≥ ε 2 } \{|X-\mu| \ge \varepsilon\} = \{(X-\mu)^2 \ge \varepsilon^2\} { ∣ X − μ ∣ ≥ ε } = {( X − μ ) 2 ≥ ε 2 }
P ( ∣ X − μ ∣ ≥ ε ) = P ( ( X − μ ) 2 ≥ ε 2 ) ≤ E [ ( X − μ ) 2 ] ε 2 = Var ( X ) ε 2 P(|X-\mu| \ge \varepsilon) = P\left((X-\mu)^2 \ge \varepsilon^2\right) \le \frac{E[(X-\mu)^2]}{\varepsilon^2} = \frac{\operatorname{Var}(X)}{\varepsilon^2} P ( ∣ X − μ ∣ ≥ ε ) = P ( ( X − μ ) 2 ≥ ε 2 ) ≤ ε 2 E [( X − μ ) 2 ] = ε 2 Var ( X ) です。
∎ 定理 3.6 (収束概念の含意 ) ✓
同じ確率空間上の確率変数列 ( X n ) (X_n) ( X n ) X X X
X n → a.s. X X_n \xrightarrow{\text{a.s.}} X X n a.s. X X n → P X X_n \xrightarrow{P} X X n P X ある p ≥ 1 p \ge 1 p ≥ 1 X n → L p X X_n \xrightarrow{L^p} X X n L p X X n → P X X_n \xrightarrow{P} X X n P X
X n → P X X_n \xrightarrow{P} X X n P X X n → d X X_n \xrightarrow{d} X X n d X c c c X n → d c X_n \xrightarrow{d} c X n d c X n → P c X_n \xrightarrow{P} c X n P c 1〜3 の逆はいずれも一般には成り立たない(4 は、極限が定数のときに限った 3 の逆である)。
以下の証明のうち (1) は、集合 B n B_n B n n n n X m X_m X m X X X ε \varepsilon ε n n n B n B_n B n 0 0 0 B n B_n B n 0 0 0
証明(定理 3.6) (1) ε > 0 \varepsilon > 0 ε > 0 A n = { ∣ X n − X ∣ > ε } A_n = \{|X_n - X| > \varepsilon\} A n = { ∣ X n − X ∣ > ε } B n = ⋃ m ≥ n A m B_n = \bigcup_{m \ge n} A_m B n = ⋃ m ≥ n A m B n B_n B n n n n ω ∈ ⋂ n B n \omega \in \bigcap_{n} B_n ω ∈ ⋂ n B n ∣ X m ( ω ) − X ( ω ) ∣ > ε |X_m(\omega) - X(\omega)| > \varepsilon ∣ X m ( ω ) − X ( ω ) ∣ > ε m m m X n ( ω ) → X ( ω ) X_n(\omega) \to X(\omega) X n ( ω ) → X ( ω ) P ( ⋂ n B n ) = 0 P(\bigcap_n B_n) = 0 P ( ⋂ n B n ) = 0 定理 4.3[確率空間とコルモゴロフの公理] 。P ( B 1 ) ≤ 1 < ∞ P(B_1) \le 1 < \infty P ( B 1 ) ≤ 1 < ∞ P ( B n ) → P ( ⋂ n B n ) = 0 P(B_n) \to P(\bigcap_n B_n) = 0 P ( B n ) → P ( ⋂ n B n ) = 0 P ( A n ) ≤ P ( B n ) → 0 P(A_n) \le P(B_n) \to 0 P ( A n ) ≤ P ( B n ) → 0
(2) Y = ∣ X n − X ∣ p ≥ 0 Y = |X_n - X|^p \ge 0 Y = ∣ X n − X ∣ p ≥ 0 a = ε p > 0 a = \varepsilon^p > 0 a = ε p > 0 命題 3.5 のマルコフの不等式を使うと
P ( ∣ X n − X ∣ ≥ ε ) = P ( ∣ X n − X ∣ p ≥ ε p ) ≤ E [ ∣ X n − X ∣ p ] ε p P(|X_n - X| \ge \varepsilon) = P(|X_n-X|^p \ge \varepsilon^p) \le \frac{E[|X_n - X|^p]}{\varepsilon^p} P ( ∣ X n − X ∣ ≥ ε ) = P ( ∣ X n − X ∣ p ≥ ε p ) ≤ ε p E [ ∣ X n − X ∣ p ] となり、右辺は仮定より 0 0 0
(3) x x x F F F ε > 0 \varepsilon > 0 ε > 0
{ X ≤ x − ε } ⊂ { X n ≤ x } ∪ { ∣ X n − X ∣ > ε } \{X \le x - \varepsilon\} \subset \{X_n \le x\} \cup \{|X_n - X| > \varepsilon\} { X ≤ x − ε } ⊂ { X n ≤ x } ∪ { ∣ X n − X ∣ > ε } が成り立ちます(左辺の ω \omega ω X n ( ω ) > x X_n(\omega) > x X n ( ω ) > x X n ( ω ) − X ( ω ) > ε X_n(\omega) - X(\omega) > \varepsilon X n ( ω ) − X ( ω ) > ε
F ( x − ε ) ≤ F n ( x ) + P ( ∣ X n − X ∣ > ε ) . F(x-\varepsilon) \le F_n(x) + P(|X_n - X| > \varepsilon). F ( x − ε ) ≤ F n ( x ) + P ( ∣ X n − X ∣ > ε ) . 同様に { X n ≤ x } ⊂ { X ≤ x + ε } ∪ { ∣ X n − X ∣ > ε } \{X_n \le x\} \subset \{X \le x+\varepsilon\} \cup \{|X_n - X| > \varepsilon\} { X n ≤ x } ⊂ { X ≤ x + ε } ∪ { ∣ X n − X ∣ > ε }
F n ( x ) ≤ F ( x + ε ) + P ( ∣ X n − X ∣ > ε ) . F_n(x) \le F(x+\varepsilon) + P(|X_n - X| > \varepsilon). F n ( x ) ≤ F ( x + ε ) + P ( ∣ X n − X ∣ > ε ) . n → ∞ n \to \infty n → ∞ P ( ∣ X n − X ∣ > ε ) → 0 P(|X_n-X| > \varepsilon) \to 0 P ( ∣ X n − X ∣ > ε ) → 0
F ( x − ε ) ≤ lim inf n F n ( x ) ≤ lim sup n F n ( x ) ≤ F ( x + ε ) . F(x-\varepsilon) \le \liminf_n F_n(x) \le \limsup_n F_n(x) \le F(x+\varepsilon). F ( x − ε ) ≤ n lim inf F n ( x ) ≤ n lim sup F n ( x ) ≤ F ( x + ε ) . x x x F F F ε ↓ 0 \varepsilon \downarrow 0 ε ↓ 0 F ( x ) F(x) F ( x ) F n ( x ) → F ( x ) F_n(x) \to F(x) F n ( x ) → F ( x )
(4) 極限が定数 c c c F ( x ) = 1 [ c , ∞ ) ( x ) F(x) = \mathbf{1}_{[c,\infty)}(x) F ( x ) = 1 [ c , ∞ ) ( x ) x ≠ c x \ne c x = c ε > 0 \varepsilon > 0 ε > 0
P ( ∣ X n − c ∣ > ε ) ≤ P ( X n ≤ c − ε ) + P ( X n > c + ε ) = F n ( c − ε ) + 1 − F n ( c + ε ) . P(|X_n - c| > \varepsilon) \le P(X_n \le c - \varepsilon) + P(X_n > c+\varepsilon) = F_n(c-\varepsilon) + 1 - F_n(c+\varepsilon). P ( ∣ X n − c ∣ > ε ) ≤ P ( X n ≤ c − ε ) + P ( X n > c + ε ) = F n ( c − ε ) + 1 − F n ( c + ε ) . c ± ε c \pm \varepsilon c ± ε F F F F n ( c − ε ) → F ( c − ε ) = 0 F_n(c-\varepsilon) \to F(c-\varepsilon) = 0 F n ( c − ε ) → F ( c − ε ) = 0 F n ( c + ε ) → F ( c + ε ) = 1 F_n(c+\varepsilon) \to F(c+\varepsilon) = 1 F n ( c + ε ) → F ( c + ε ) = 1 0 0 0
逆が成り立たないこと。 いずれも Ω = [ 0 , 1 ] \Omega=[0,1] Ω = [ 0 , 1 ]
(1) の逆: n = 2 k + j n=2^k+j n = 2 k + j k ≥ 0 k\ge0 k ≥ 0 0 ≤ j < 2 k 0\le j<2^k 0 ≤ j < 2 k X n = 1 [ j 2 − k , ( j + 1 ) 2 − k ) X_n=\mathbf 1_{[j2^{-k},(j+1)2^{-k})} X n = 1 [ j 2 − k , ( j + 1 ) 2 − k ) 0 < ε < 1 0<\varepsilon<1 0 < ε < 1 P ( ∣ X n ∣ > ε ) = 2 − k → 0 P(|X_n|>\varepsilon)=2^{-k}\to0 P ( ∣ X n ∣ > ε ) = 2 − k → 0 X n → P 0 X_n\xrightarrow{P}0 X n P 0 ω ∈ [ 0 , 1 ) \omega\in[0,1) ω ∈ [ 0 , 1 ) k ≥ 1 k\ge1 k ≥ 1 ω \omega ω 2 − k 2^{-k} 2 − k X n ( ω ) = 1 X_n(\omega)=1 X n ( ω ) = 1 n n n X n ( ω ) = 0 X_n(\omega)=0 X n ( ω ) = 0 n n n X n ( ω ) X_n(\omega) X n ( ω ) X n X_n X n X X X
(2) の逆: X n = n 1 ( 0 , 1 / n ) X_n=n\mathbf 1_{(0,1/n)} X n = n 1 ( 0 , 1/ n ) ε > 0 \varepsilon>0 ε > 0 P ( ∣ X n ∣ > ε ) ≤ 1 / n → 0 P(|X_n|>\varepsilon)\le1/n\to0 P ( ∣ X n ∣ > ε ) ≤ 1/ n → 0 X n → P 0 X_n\xrightarrow{P}0 X n P 0 X X X L p L^p L p X n → P X X_n\xrightarrow{P}X X n P X P ( ∣ X ∣ > 2 ε ) ≤ P ( ∣ X n − X ∣ > ε ) + P ( ∣ X n ∣ > ε ) → 0 P(|X|>2\varepsilon)\le P(|X_n-X|>\varepsilon)+P(|X_n|>\varepsilon)\to0 P ( ∣ X ∣ > 2 ε ) ≤ P ( ∣ X n − X ∣ > ε ) + P ( ∣ X n ∣ > ε ) → 0 X = 0 X=0 X = 0 E [ ∣ X n ∣ p ] = n p ⋅ 1 n = n p − 1 ≥ 1 E[|X_n|^p]=n^{p}\cdot\frac1n=n^{p-1}\ge1 E [ ∣ X n ∣ p ] = n p ⋅ n 1 = n p − 1 ≥ 1 0 0 0
(3) の逆: X ( ω ) = ω X(\omega)=\omega X ( ω ) = ω X n = 1 − X X_n=1-X X n = 1 − X 1 − X 1-X 1 − X [ 0 , 1 ] [0,1] [ 0 , 1 ] F n = F F_n=F F n = F X n → d X X_n\xrightarrow{d}X X n d X P ( ∣ X n − X ∣ > 1 2 ) = P ( ∣ 1 − 2 X ∣ > 1 2 ) = 1 2 P(|X_n-X|>\tfrac12)=P(|1-2X|>\tfrac12)=\tfrac12 P ( ∣ X n − X ∣ > 2 1 ) = P ( ∣1 − 2 X ∣ > 2 1 ) = 2 1
∎ 逆が成り立たないことの詳しい観察は例 3.7 、例 3.8 、および下の注意にあります。
例 3.7 (確率収束するが概収束しない列(タイプライター列) )
Ω = [ 0 , 1 ] \Omega = [0,1] Ω = [ 0 , 1 ] n ≥ 1 n \ge 1 n ≥ 1 n = 2 k + j n = 2^k + j n = 2 k + j k ≥ 0 k \ge 0 k ≥ 0 0 ≤ j < 2 k 0 \le j < 2^k 0 ≤ j < 2 k
X n ( ω ) = 1 [ j 2 − k , ( j + 1 ) 2 − k ) ( ω ) X_n(\omega) = \mathbf{1}_{[\,j2^{-k},\,(j+1)2^{-k}\,)}(\omega) X n ( ω ) = 1 [ j 2 − k , ( j + 1 ) 2 − k ) ( ω ) と定めます。これは幅 2 − k 2^{-k} 2 − k [ 0 , 1 ] [0,1] [ 0 , 1 ]
確率収束: 0 < ε < 1 0 < \varepsilon < 1 0 < ε < 1 P ( ∣ X n − 0 ∣ > ε ) = P ( X n = 1 ) = 2 − k P(|X_n - 0| > \varepsilon) = P(X_n = 1) = 2^{-k} P ( ∣ X n − 0∣ > ε ) = P ( X n = 1 ) = 2 − k n → ∞ n \to \infty n → ∞ k → ∞ k \to \infty k → ∞ 0 0 0 X n → P 0 X_n \xrightarrow{P} 0 X n P 0
概収束しないこと: どの ω ∈ [ 0 , 1 ) \omega \in [0,1) ω ∈ [ 0 , 1 ) k k k j j j ω ∈ [ j 2 − k , ( j + 1 ) 2 − k ) \omega \in [j2^{-k}, (j+1)2^{-k}) ω ∈ [ j 2 − k , ( j + 1 ) 2 − k ) X n ( ω ) = 1 X_n(\omega) = 1 X n ( ω ) = 1 n n n X n ( ω ) = 0 X_n(\omega) = 0 X n ( ω ) = 0 n n n k ≥ 1 k \ge 1 k ≥ 1 ω ∈ [ 0 , 1 ) \omega \in [0,1) ω ∈ [ 0 , 1 ) X n ( ω ) X_n(\omega) X n ( ω ) lim sup = 1 \limsup = 1 lim sup = 1 lim inf = 0 \liminf = 0 lim inf = 0 ω = 1 \omega = 1 ω = 1 ω \omega ω { 1 } \{1\} { 1 } 1 1 1 0 0 0
例 3.8 (概収束するが L 1 L^1 L 1 )
同じく Ω = [ 0 , 1 ] \Omega = [0,1] Ω = [ 0 , 1 ] X n = n ⋅ 1 ( 0 , 1 / n ) X_n = n \cdot \mathbf{1}_{(0,1/n)} X n = n ⋅ 1 ( 0 , 1/ n )
概収束: ω ∈ ( 0 , 1 ] \omega \in (0,1] ω ∈ ( 0 , 1 ] n > 1 / ω n > 1/\omega n > 1/ ω n n n ω ∉ ( 0 , 1 / n ) \omega \notin (0,1/n) ω ∈ / ( 0 , 1/ n ) X n ( ω ) = 0 X_n(\omega) = 0 X n ( ω ) = 0 X n ( ω ) → 0 X_n(\omega) \to 0 X n ( ω ) → 0 ( 0 , 1 ] (0,1] ( 0 , 1 ] P ( ( 0 , 1 ] ) = 1 P((0,1]) = 1 P (( 0 , 1 ]) = 1 X n → a.s. 0 X_n \xrightarrow{\text{a.s.}} 0 X n a.s. 0
L 1 L^1 L 1 E [ ∣ X n − 0 ∣ ] = n ⋅ P ( ( 0 , 1 / n ) ) = n ⋅ 1 n = 1 E[|X_n - 0|] = n \cdot P((0,1/n)) = n \cdot \frac{1}{n} = 1 E [ ∣ X n − 0∣ ] = n ⋅ P (( 0 , 1/ n )) = n ⋅ n 1 = 1 0 0 0 n n n 1 / n 1/n 1/ n L 1 L^1 L 1 優収束定理(定理 7.3)[ルベーグ積分の定義と収束定理] も参照)。
定理 4.1 (大数の弱法則 ) ✓
X 1 , X 2 , … X_1, X_2, \ldots X 1 , X 2 , … E [ ∣ X 1 ∣ ] < ∞ E[|X_1|] < \infty E [ ∣ X 1 ∣ ] < ∞ μ = E [ X 1 ] \mu = E[X_1] μ = E [ X 1 ] X ˉ n = n − 1 ∑ i = 1 n X i \bar{X}_n = n^{-1}\sum_{i=1}^n X_i X ˉ n = n − 1 ∑ i = 1 n X i μ \mu μ ε > 0 \varepsilon > 0 ε > 0
lim n → ∞ P ( ∣ X ˉ n − μ ∣ > ε ) = 0. \lim_{n\to\infty} P\left(\left|\bar{X}_n - \mu\right| > \varepsilon\right) = 0 . n → ∞ lim P ( X ˉ n − μ > ε ) = 0. 証明(定理 4.1) 一般の場合は、後で(この定理を使わずに)証明する定理 4.5 により X ˉ n → μ \bar{X}_n \to \mu X ˉ n → μ 定理 3.6 (1) により確率収束するので従います。以下では、追加仮定 σ 2 = Var ( X 1 ) < ∞ \sigma^2 = \operatorname{Var}(X_1) < \infty σ 2 = Var ( X 1 ) < ∞
期待値の線形性より E [ X ˉ n ] = 1 n ∑ i = 1 n E [ X i ] = 1 n ⋅ n μ = μ E[\bar{X}_n] = \frac{1}{n}\sum_{i=1}^n E[X_i] = \frac{1}{n} \cdot n\mu = \mu E [ X ˉ n ] = n 1 ∑ i = 1 n E [ X i ] = n 1 ⋅ n μ = μ Var ( c Y ) = c 2 Var ( Y ) \operatorname{Var}(cY) = c^2\operatorname{Var}(Y) Var ( c Y ) = c 2 Var ( Y )
Var ( X ˉ n ) = 1 n 2 Var ( ∑ i = 1 n X i ) = 1 n 2 ∑ i = 1 n Var ( X i ) = n σ 2 n 2 = σ 2 n . \operatorname{Var}(\bar{X}_n) = \frac{1}{n^2}\operatorname{Var}\left(\sum_{i=1}^n X_i\right) = \frac{1}{n^2}\sum_{i=1}^n \operatorname{Var}(X_i) = \frac{n\sigma^2}{n^2} = \frac{\sigma^2}{n}. Var ( X ˉ n ) = n 2 1 Var ( i = 1 ∑ n X i ) = n 2 1 i = 1 ∑ n Var ( X i ) = n 2 n σ 2 = n σ 2 . 命題 3.5 のチェビシェフの不等式を X = X ˉ n X = \bar{X}_n X = X ˉ n ε > 0 \varepsilon > 0 ε > 0
P ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ Var ( X ˉ n ) ε 2 = σ 2 n ε 2 → n → ∞ 0 P\left(|\bar{X}_n - \mu| \ge \varepsilon\right) \le \frac{\operatorname{Var}(\bar{X}_n)}{\varepsilon^2} = \frac{\sigma^2}{n\varepsilon^2} \xrightarrow[n\to\infty]{} 0 P ( ∣ X ˉ n − μ ∣ ≥ ε ) ≤ ε 2 Var ( X ˉ n ) = n ε 2 σ 2 n → ∞ 0 となります。P ( ∣ X ˉ n − μ ∣ > ε ) ≤ P ( ∣ X ˉ n − μ ∣ ≥ ε ) P(|\bar{X}_n - \mu| > \varepsilon) \le P(|\bar{X}_n-\mu| \ge \varepsilon) P ( ∣ X ˉ n − μ ∣ > ε ) ≤ P ( ∣ X ˉ n − μ ∣ ≥ ε )
∎ 証明が示しているのは、弱法則の本質が Var ( X ˉ n ) = σ 2 / n → 0 \operatorname{Var}(\bar{X}_n) = \sigma^2/n \to 0 Var ( X ˉ n ) = σ 2 / n → 0
例 4.2 (コイン投げの数値評価 )
公平なコインを n n n 1 1 1 0 0 0 X i X_i X i μ = 1 / 2 \mu = 1/2 μ = 1/2 σ 2 = 1 / 4 \sigma^2 = 1/4 σ 2 = 1/4 n = 10,000 n = 10{,}000 n = 10 , 000 ε = 0.01 \varepsilon = 0.01 ε = 0.01
P ( ∣ X ˉ 10000 − 1 2 ∣ ≥ 0.01 ) ≤ 1 / 4 10 4 × 10 − 4 = 0.25 1 = 0.25. P\left(\left|\bar{X}_{10000} - \tfrac12\right| \ge 0.01\right) \le \frac{1/4}{10^4 \times 10^{-4}} = \frac{0.25}{1} = 0.25 . P ( X ˉ 10000 − 2 1 ≥ 0.01 ) ≤ 1 0 4 × 1 0 − 4 1/4 = 1 0.25 = 0.25. 「4 4 4 1 1 1 定理 5.6 を使うと、この確率が実際にはおよそ 0.046 0.046 0.046 例 5.7 )。チェビシェフは安全側に大きく外していますが、その代わり有限の n n n
例 4.3 (期待値がないと大数の法則は破綻する )
X i X_i X i f ( x ) = 1 π ( 1 + x 2 ) f(x) = \frac{1}{\pi(1+x^2)} f ( x ) = π ( 1 + x 2 ) 1 ∫ ∣ x ∣ f ( x ) d x = ∞ \int |x| f(x)\,dx = \infty ∫ ∣ x ∣ f ( x ) d x = ∞ E [ ∣ X 1 ∣ ] E[|X_1|] E [ ∣ X 1 ∣ ] 例 4.8[確率変数と期待値] )、定理 4.1 の仮定を満たしません。実際、コーシー分布の特性関数は φ ( t ) = e − ∣ t ∣ \varphi(t) = e^{-|t|} φ ( t ) = e − ∣ t ∣
φ X ˉ n ( t ) = [ φ ( t n ) ] n = ( e − ∣ t ∣ / n ) n = e − ∣ t ∣ \varphi_{\bar{X}_n}(t) = \left[\varphi\!\left(\frac{t}{n}\right)\right]^n = \left(e^{-|t|/n}\right)^n = e^{-|t|} φ X ˉ n ( t ) = [ φ ( n t ) ] n = ( e − ∣ t ∣/ n ) n = e − ∣ t ∣ となり、X ˉ n \bar{X}_n X ˉ n n n n 1 1 1 100 100 100
弱法則は各 n n n X ˉ n \bar{X}_n X ˉ n μ \mu μ 例 3.7 のような振る舞いです)。「一本の実験を無限に続けたら、その軌道は収束するのか」に答えるのが強法則です。まず道具を用意します(ボレル・カンテリの補題(補題 6.5)[確率空間とコルモゴロフの公理] の再掲です)。
補題 4.4 (ボレル・カンテリの補題(第一) ) ✓
事象列 ( A n ) n ∈ N (A_n)_{n\in\mathbb{N}} ( A n ) n ∈ N ∑ n = 1 ∞ P ( A n ) < ∞ \sum_{n=1}^{\infty} P(A_n) < \infty ∑ n = 1 ∞ P ( A n ) < ∞
P ( lim sup n → ∞ A n ) = P ( ⋂ n = 1 ∞ ⋃ m ≥ n A m ) = 0 P\left(\limsup_{n\to\infty} A_n\right) = P\left(\bigcap_{n=1}^{\infty}\bigcup_{m \ge n} A_m\right) = 0 P ( n → ∞ lim sup A n ) = P ( n = 1 ⋂ ∞ m ≥ n ⋃ A m ) = 0 である。すなわち、確率 1 1 1 A n A_n A n n n n
証明(補題 4.4) B n = ⋃ m ≥ n A m B_n = \bigcup_{m \ge n} A_m B n = ⋃ m ≥ n A m
P ( B n ) ≤ ∑ m = n ∞ P ( A m ) P(B_n) \le \sum_{m=n}^{\infty} P(A_m) P ( B n ) ≤ m = n ∑ ∞ P ( A m ) です。右辺は収束級数 ∑ m P ( A m ) < ∞ \sum_m P(A_m) < \infty ∑ m P ( A m ) < ∞ n n n n → ∞ n \to \infty n → ∞ 0 0 0 lim sup n A n = ⋂ n B n ⊂ B n \limsup_n A_n = \bigcap_n B_n \subset B_n lim sup n A n = ⋂ n B n ⊂ B n n n n P ( lim sup n A n ) ≤ P ( B n ) → 0 P(\limsup_n A_n) \le P(B_n) \to 0 P ( lim sup n A n ) ≤ P ( B n ) → 0 P ( lim sup n A n ) = 0 P(\limsup_n A_n) = 0 P ( lim sup n A n ) = 0
∎ 定理 4.5 (大数の強法則(コルモゴロフ) ) ✓
X 1 , X 2 , … X_1, X_2, \ldots X 1 , X 2 , … E [ ∣ X 1 ∣ ] < ∞ E[|X_1|] < \infty E [ ∣ X 1 ∣ ] < ∞ μ = E [ X 1 ] \mu = E[X_1] μ = E [ X 1 ]
P ( lim n → ∞ X ˉ n = μ ) = 1 , P\left(\lim_{n\to\infty} \bar{X}_n = \mu\right) = 1, P ( n → ∞ lim X ˉ n = μ ) = 1 , すなわち X ˉ n → a.s. μ \bar{X}_n \xrightarrow{\text{a.s.}} \mu X ˉ n a.s. μ E [ ∣ X 1 ∣ ] = ∞ E[|X_1|] = \infty E [ ∣ X 1 ∣ ] = ∞ lim sup n ∣ X ˉ n ∣ = ∞ \limsup_n |\bar{X}_n| = \infty lim sup n ∣ X ˉ n ∣ = ∞ 1 1 1
証明の方針を先に述べます。後で示す 4 次モーメント版(命題 4.7 )は、確率の和が ∑ n − 2 \sum n^{-2} ∑ n − 2 n n n α n \alpha^n α n
証明(定理 4.5) エテマディ (1981) の議論に従います。使う道具は、非負確率変数 Z Z Z
∑ k ≥ 1 P ( Z > k ) ≤ E [ Z ] ≤ 1 + ∑ k ≥ 1 P ( Z ≥ k ) ( † ) \sum_{k\ge1}P(Z>k)\le E[Z]\le1+\sum_{k\ge1}P(Z\ge k) \tag{$\dagger$} k ≥ 1 ∑ P ( Z > k ) ≤ E [ Z ] ≤ 1 + k ≥ 1 ∑ P ( Z ≥ k ) ( † ) だけです。これは E [ Z ] = ∫ 0 ∞ P ( Z > t ) d t E[Z]=\int_0^\infty P(Z>t)\,dt E [ Z ] = ∫ 0 ∞ P ( Z > t ) d t 定理 3.3[直積測度と Fubini–Tonelli の定理] を 1 { t < Z } \mathbf 1_{\{t<Z\}} 1 { t < Z } [ k − 1 , k ) [k-1,k) [ k − 1 , k ) P ( Z ≥ k ) ≤ P ( Z > t ) ≤ P ( Z > k − 1 ) P(Z\ge k)\le P(Z>t)\le P(Z>k-1) P ( Z ≥ k ) ≤ P ( Z > t ) ≤ P ( Z > k − 1 )
ステップ 0:非負への帰着。 X i = X i + − X i − X_i=X_i^+-X_i^- X i = X i + − X i − ( X i + ) (X_i^+) ( X i + ) ( X i − ) (X_i^-) ( X i − ) X i ≥ 0 X_i\ge0 X i ≥ 0
ステップ 1:切断。 Y k : = X k 1 { X k ≤ k } Y_k:=X_k\mathbf 1_{\{X_k\le k\}} Y k := X k 1 { X k ≤ k } T n : = ∑ k = 1 n Y k T_n:=\sum_{k=1}^nY_k T n := ∑ k = 1 n Y k † \dagger †
∑ k ≥ 1 P ( X k ≠ Y k ) = ∑ k ≥ 1 P ( X 1 > k ) ≤ E [ X 1 ] < ∞ \sum_{k\ge1}P(X_k\ne Y_k)=\sum_{k\ge1}P(X_1>k)\le E[X_1]<\infty k ≥ 1 ∑ P ( X k = Y k ) = k ≥ 1 ∑ P ( X 1 > k ) ≤ E [ X 1 ] < ∞ なので、補題 4.4 により確率 1 1 1 X k ≠ Y k X_k\ne Y_k X k = Y k k k k ω \omega ω ( S n − T n ) ( ω ) (S_n-T_n)(\omega) ( S n − T n ) ( ω ) ( S n − T n ) / n → 0 (S_n-T_n)/n\to0 ( S n − T n ) / n → 0 T n / n → μ T_n/n\to\mu T n / n → μ E [ Y k ] = E [ X 1 1 { X 1 ≤ k } ] ↑ E [ X 1 ] = μ E[Y_k]=E[X_1\mathbf 1_{\{X_1\le k\}}]\uparrow E[X_1]=\mu E [ Y k ] = E [ X 1 1 { X 1 ≤ k } ] ↑ E [ X 1 ] = μ 定理 2.1[確率変数と期待値] )なので、Cesàro 平均として E [ T n ] / n → μ E[T_n]/n\to\mu E [ T n ] / n → μ
ステップ 2:等比部分列での収束。 α > 1 \alpha>1 α > 1 k n : = ⌊ α n ⌋ k_n:=\lfloor\alpha^n\rfloor k n := ⌊ α n ⌋ k n ≥ α n / 2 k_n\ge\alpha^n/2 k n ≥ α n /2 Y k Y_k Y k X k X_k X k 命題 5.3[確率変数と期待値] )。ε > 0 \varepsilon>0 ε > 0 命題 3.5 )から
∑ n ≥ 1 P ( ∣ T k n − E [ T k n ] ∣ > ε k n ) ≤ 1 ε 2 ∑ n ≥ 1 1 k n 2 ∑ k ≤ k n E [ Y k 2 ] = 1 ε 2 ∑ k ≥ 1 E [ Y k 2 ] ∑ n : k n ≥ k 1 k n 2 . \sum_{n\ge1}P\bigl(|T_{k_n}-E[T_{k_n}]|>\varepsilon k_n\bigr)\le\frac1{\varepsilon^2}\sum_{n\ge1}\frac1{k_n^2}\sum_{k\le k_n}E[Y_k^2]
=\frac1{\varepsilon^2}\sum_{k\ge1}E[Y_k^2]\sum_{n:\,k_n\ge k}\frac1{k_n^2}. n ≥ 1 ∑ P ( ∣ T k n − E [ T k n ] ∣ > ε k n ) ≤ ε 2 1 n ≥ 1 ∑ k n 2 1 k ≤ k n ∑ E [ Y k 2 ] = ε 2 1 k ≥ 1 ∑ E [ Y k 2 ] n : k n ≥ k ∑ k n 2 1 . k n ≥ k k_n\ge k k n ≥ k α n ≥ k \alpha^n\ge k α n ≥ k 4 ∑ n : α n ≥ k α − 2 n ≤ 4 ( 1 − α − 2 ) k 2 4\sum_{n:\alpha^n\ge k}\alpha^{-2n}\le\dfrac{4}{(1-\alpha^{-2})k^2} 4 ∑ n : α n ≥ k α − 2 n ≤ ( 1 − α − 2 ) k 2 4
∑ k ≥ 1 E [ Y k 2 ] k 2 = E [ X 1 2 ∑ k ≥ max ( 1 , X 1 ) 1 k 2 ] ≤ E [ X 1 2 ⋅ 2 max ( 1 , X 1 ) ] ≤ 2 E [ X 1 ] < ∞ \sum_{k\ge1}\frac{E[Y_k^2]}{k^2}=E\Bigl[X_1^2\sum_{k\ge\max(1,X_1)}\frac1{k^2}\Bigr]\le E\Bigl[X_1^2\cdot\frac{2}{\max(1,X_1)}\Bigr]\le2E[X_1]<\infty k ≥ 1 ∑ k 2 E [ Y k 2 ] = E [ X 1 2 k ≥ m a x ( 1 , X 1 ) ∑ k 2 1 ] ≤ E [ X 1 2 ⋅ max ( 1 , X 1 ) 2 ] ≤ 2 E [ X 1 ] < ∞ です(m ≥ 1 m\ge1 m ≥ 1 ∑ k ≥ m k − 2 ≤ m − 2 + m − 1 ≤ 2 / m \sum_{k\ge m}k^{-2}\le m^{-2}+m^{-1}\le2/m ∑ k ≥ m k − 2 ≤ m − 2 + m − 1 ≤ 2/ m 補題 4.4 と ε = 1 / j \varepsilon=1/j ε = 1/ j j ∈ N j\in\mathbb{N} j ∈ N ( T k n − E [ T k n ] ) / k n → 0 (T_{k_n}-E[T_{k_n}])/k_n\to0 ( T k n − E [ T k n ]) / k n → 0 E [ T k n ] / k n → μ E[T_{k_n}]/k_n\to\mu E [ T k n ] / k n → μ T k n / k n → μ T_{k_n}/k_n\to\mu T k n / k n → μ
ステップ 3:間を埋める。 Y k ≥ 0 Y_k\ge0 Y k ≥ 0 T m T_m T m m m m k n ≤ m ≤ k n + 1 k_n\le m\le k_{n+1} k n ≤ m ≤ k n + 1
k n k n + 1 ⋅ T k n k n ≤ T m m ≤ k n + 1 k n ⋅ T k n + 1 k n + 1 \frac{k_n}{k_{n+1}}\cdot\frac{T_{k_n}}{k_n}\le\frac{T_m}{m}\le\frac{k_{n+1}}{k_n}\cdot\frac{T_{k_{n+1}}}{k_{n+1}} k n + 1 k n ⋅ k n T k n ≤ m T m ≤ k n k n + 1 ⋅ k n + 1 T k n + 1 で、k n + 1 / k n → α k_{n+1}/k_n\to\alpha k n + 1 / k n → α 1 1 1 μ / α ≤ lim inf m T m / m ≤ lim sup m T m / m ≤ α μ \mu/\alpha\le\liminf_mT_m/m\le\limsup_mT_m/m\le\alpha\mu μ / α ≤ lim inf m T m / m ≤ lim sup m T m / m ≤ α μ α = 1 + 1 / j \alpha=1+1/j α = 1 + 1/ j j ∈ N j\in\mathbb{N} j ∈ N T m / m → μ T_m/m\to\mu T m / m → μ
逆の主張。 E ∣ X 1 ∣ = ∞ E|X_1|=\infty E ∣ X 1 ∣ = ∞ c ∈ N c\in\mathbb{N} c ∈ N † \dagger † Z = ∣ X 1 ∣ / c Z=|X_1|/c Z = ∣ X 1 ∣/ c ∑ n ≥ 1 P ( ∣ X n ∣ ≥ c n ) = ∑ n ≥ 1 P ( ∣ X 1 ∣ / c ≥ n ) = ∞ \sum_{n\ge1}P(|X_n|\ge cn)=\sum_{n\ge1}P(|X_1|/c\ge n)=\infty ∑ n ≥ 1 P ( ∣ X n ∣ ≥ c n ) = ∑ n ≥ 1 P ( ∣ X 1 ∣/ c ≥ n ) = ∞ A n = { ∣ X n ∣ ≥ c n } A_n=\{|X_n|\ge cn\} A n = { ∣ X n ∣ ≥ c n } N > n N>n N > n
P ( ⋂ m = n N A m c ) = ∏ m = n N ( 1 − P ( A m ) ) ≤ exp ( − ∑ m = n N P ( A m ) ) → N → ∞ 0 P\Bigl(\bigcap_{m=n}^{N}A_m^c\Bigr)=\prod_{m=n}^{N}\bigl(1-P(A_m)\bigr)\le\exp\Bigl(-\sum_{m=n}^{N}P(A_m)\Bigr)\xrightarrow{N\to\infty}0 P ( m = n ⋂ N A m c ) = m = n ∏ N ( 1 − P ( A m ) ) ≤ exp ( − m = n ∑ N P ( A m ) ) N → ∞ 0 (1 − x ≤ e − x 1-x\le e^{-x} 1 − x ≤ e − x P ( ⋂ m ≥ n A m c ) = 0 P(\bigcap_{m\ge n}A_m^c)=0 P ( ⋂ m ≥ n A m c ) = 0 n n n 1 1 1 A n A_n A n ∣ X n ∣ = ∣ S n − S n − 1 ∣ ≤ ∣ S n ∣ + ∣ S n − 1 ∣ |X_n|=|S_n-S_{n-1}|\le|S_n|+|S_{n-1}| ∣ X n ∣ = ∣ S n − S n − 1 ∣ ≤ ∣ S n ∣ + ∣ S n − 1 ∣ ∣ X n ∣ ≥ c n |X_n|\ge cn ∣ X n ∣ ≥ c n ∣ S n ∣ / n ≥ c / 2 |S_n|/n\ge c/2 ∣ S n ∣/ n ≥ c /2 ∣ S n − 1 ∣ / ( n − 1 ) ≥ c / 2 |S_{n-1}|/(n-1)\ge c/2 ∣ S n − 1 ∣/ ( n − 1 ) ≥ c /2 1 1 1 lim sup n ∣ X ˉ n ∣ ≥ c / 2 \limsup_n|\bar X_n|\ge c/2 lim sup n ∣ X ˉ n ∣ ≥ c /2 c ∈ N c\in\mathbb{N} c ∈ N lim sup n ∣ X ˉ n ∣ = ∞ \limsup_n|\bar X_n|=\infty lim sup n ∣ X ˉ n ∣ = ∞
∎ 命題 4.7 (4 次モーメント版の強法則 ) ✓
X 1 , X 2 , … X_1, X_2, \ldots X 1 , X 2 , … E [ X 1 4 ] < ∞ E[X_1^4] < \infty E [ X 1 4 ] < ∞ μ = E [ X 1 ] \mu = E[X_1] μ = E [ X 1 ] X ˉ n → a.s. μ \bar{X}_n \xrightarrow{\text{a.s.}} \mu X ˉ n a.s. μ
証明(命題 4.7) Y i = X i − μ Y_i = X_i - \mu Y i = X i − μ E [ Y i ] = 0 E[Y_i] = 0 E [ Y i ] = 0 E [ Y i 4 ] = K < ∞ E[Y_i^4] = K < \infty E [ Y i 4 ] = K < ∞ E [ Y i 2 ] = σ 2 < ∞ E[Y_i^2] = \sigma^2 < \infty E [ Y i 2 ] = σ 2 < ∞ E [ Y 2 ] ≤ ( E [ Y 4 ] ) 1 / 2 < ∞ E[Y^2] \le (E[Y^4])^{1/2} < \infty E [ Y 2 ] ≤ ( E [ Y 4 ] ) 1/2 < ∞ T n = ∑ i = 1 n Y i T_n = \sum_{i=1}^n Y_i T n = ∑ i = 1 n Y i X ˉ n − μ = T n / n \bar{X}_n - \mu = T_n/n X ˉ n − μ = T n / n
T n 4 T_n^4 T n 4 Y i 4 Y_i^4 Y i 4 Y i 3 Y j Y_i^3Y_j Y i 3 Y j Y i 2 Y j 2 Y_i^2Y_j^2 Y i 2 Y j 2 Y i 2 Y j Y k Y_i^2Y_jY_k Y i 2 Y j Y k Y i Y j Y k Y l Y_iY_jY_kY_l Y i Y j Y k Y l E [ Y i ] = 0 E[Y_i]=0 E [ Y i ] = 0 1 1 1 0 0 0 i ≠ j i \ne j i = j E [ Y i 3 Y j ] = E [ Y i 3 ] E [ Y j ] = 0 E[Y_i^3Y_j] = E[Y_i^3]E[Y_j] = 0 E [ Y i 3 Y j ] = E [ Y i 3 ] E [ Y j ] = 0 Y i 4 Y_i^4 Y i 4 n n n Y i 2 Y j 2 Y_i^2Y_j^2 Y i 2 Y j 2 i ≠ j i \ne j i = j ( 4 2 ) = 6 \binom{4}{2} = 6 ( 2 4 ) = 6 n ( n − 1 ) n(n-1) n ( n − 1 ) ( n 2 ) \binom{n}{2} ( 2 n ) 6 6 6 3 n ( n − 1 ) 3n(n-1) 3 n ( n − 1 )
E [ T n 4 ] = n K + 3 n ( n − 1 ) σ 4 ≤ n K + 3 n 2 σ 4 . E[T_n^4] = nK + 3n(n-1)\sigma^4 \le nK + 3n^2\sigma^4 . E [ T n 4 ] = n K + 3 n ( n − 1 ) σ 4 ≤ n K + 3 n 2 σ 4 . したがって C = K + 3 σ 4 C = K + 3\sigma^4 C = K + 3 σ 4 n ≥ 1 n \ge 1 n ≥ 1
E [ ( T n n ) 4 ] ≤ n K + 3 n 2 σ 4 n 4 ≤ C n 2 . E\left[\left(\frac{T_n}{n}\right)^4\right] \le \frac{nK + 3n^2\sigma^4}{n^4} \le \frac{C}{n^2}. E [ ( n T n ) 4 ] ≤ n 4 n K + 3 n 2 σ 4 ≤ n 2 C . ε > 0 \varepsilon > 0 ε > 0 A n = { ∣ T n / n ∣ > ε } A_n = \{|T_n/n| > \varepsilon\} A n = { ∣ T n / n ∣ > ε } 命題 3.5 のマルコフの不等式(Y = ( T n / n ) 4 Y = (T_n/n)^4 Y = ( T n / n ) 4 a = ε 4 a = \varepsilon^4 a = ε 4
P ( A n ) ≤ E [ ( T n / n ) 4 ] ε 4 ≤ C ε 4 n 2 , P(A_n) \le \frac{E[(T_n/n)^4]}{\varepsilon^4} \le \frac{C}{\varepsilon^4 n^2}, P ( A n ) ≤ ε 4 E [( T n / n ) 4 ] ≤ ε 4 n 2 C , であり ∑ n ≥ 1 n − 2 < ∞ \sum_{n\ge1} n^{-2} < \infty ∑ n ≥ 1 n − 2 < ∞ ∑ n P ( A n ) < ∞ \sum_n P(A_n) < \infty ∑ n P ( A n ) < ∞ 補題 4.4 より、確率 1 1 1 ∣ T n / n ∣ > ε |T_n/n| > \varepsilon ∣ T n / n ∣ > ε n n n N ε = { ω : ∣ T n ( ω ) / n ∣ > ε が無限回 } N_\varepsilon = \{\omega : |T_n(\omega)/n| > \varepsilon \text{ が無限回}\} N ε = { ω : ∣ T n ( ω ) / n ∣ > ε が無限回 } P ( N ε ) = 0 P(N_\varepsilon) = 0 P ( N ε ) = 0
最後に ε \varepsilon ε N = ⋃ k ≥ 1 N 1 / k N = \bigcup_{k \ge 1} N_{1/k} N = ⋃ k ≥ 1 N 1/ k P ( N ) = 0 P(N) = 0 P ( N ) = 0 ω ∉ N \omega \notin N ω ∈ / N k k k ∣ T n ( ω ) / n ∣ ≤ 1 / k |T_n(\omega)/n| \le 1/k ∣ T n ( ω ) / n ∣ ≤ 1/ k n n n T n ( ω ) / n → 0 T_n(\omega)/n \to 0 T n ( ω ) / n → 0 X ˉ n ( ω ) → μ \bar{X}_n(\omega) \to \mu X ˉ n ( ω ) → μ P ( N c ) = 1 P(N^c) = 1 P ( N c ) = 1
∎ 例 4.9 (ボレルの正規数定理 )
ω \omega ω [ 0 , 1 ] [0,1] [ 0 , 1 ] ω = ∑ i ≥ 1 d i ( ω ) 2 − i \omega = \sum_{i\ge1} d_i(\omega) 2^{-i} ω = ∑ i ≥ 1 d i ( ω ) 2 − i d i ∈ { 0 , 1 } d_i \in \{0,1\} d i ∈ { 0 , 1 } d 1 , d 2 , … d_1, d_2, \ldots d 1 , d 2 , … P ( d i = 1 ) = 1 / 2 P(d_i = 1) = 1/2 P ( d i = 1 ) = 1/2 定理 4.5 を X i = d i X_i = d_i X i = d i μ = 1 / 2 \mu = 1/2 μ = 1/2 E [ ∣ X 1 ∣ ] = 1 / 2 < ∞ E[|X_1|] = 1/2 < \infty E [ ∣ X 1 ∣ ] = 1/2 < ∞
P ( lim n → ∞ d 1 + ⋯ + d n n = 1 2 ) = 1 P\left(\lim_{n\to\infty} \frac{d_1 + \cdots + d_n}{n} = \frac12\right) = 1 P ( n → ∞ lim n d 1 + ⋯ + d n = 2 1 ) = 1 です。ルベーグ測度の言葉に翻訳すれば、[ 0 , 1 ] [0,1] [ 0 , 1 ] 1 1 1 1 / 2 1/2 1/2 2 \sqrt{2} 2 π \pi π
大数の法則は X ˉ n − μ → 0 \bar{X}_n - \mu \to 0 X ˉ n − μ → 0 X ˉ n − μ \bar{X}_n - \mu X ˉ n − μ σ / n \sigma/\sqrt{n} σ / n n \sqrt{n} n
Z n = X ˉ n − μ σ / n = S n − n μ σ n Z_n = \frac{\bar{X}_n - \mu}{\sigma/\sqrt{n}} = \frac{S_n - n\mu}{\sigma\sqrt{n}} Z n = σ / n X ˉ n − μ = σ n S n − n μ は E [ Z n ] = 0 E[Z_n] = 0 E [ Z n ] = 0 Var ( Z n ) = 1 \operatorname{Var}(Z_n) = 1 Var ( Z n ) = 1 Z n Z_n Z n 元の分布によらず 標準正規分布に収束すると主張します。
定義 5.1 (特性関数 ) ↗
確率変数 X X X φ X : R → C \varphi_X : \mathbb{R} \to \mathbb{C} φ X : R → C
φ X ( t ) = E [ e i t X ] = E [ cos ( t X ) ] + i E [ sin ( t X ) ] \varphi_X(t) = E\left[e^{itX}\right] = E[\cos(tX)] + i\,E[\sin(tX)] φ X ( t ) = E [ e i tX ] = E [ cos ( tX )] + i E [ sin ( tX )] で定める。これを X X X 特性関数 という。∣ e i t X ∣ = 1 |e^{itX}| = 1 ∣ e i tX ∣ = 1 ∣ φ X ( t ) ∣ ≤ 1 |\varphi_X(t)| \le 1 ∣ φ X ( t ) ∣ ≤ 1 φ X ( 0 ) = 1 \varphi_X(0) = 1 φ X ( 0 ) = 1
e i t X e^{itX} e i tX t t t Fourier 変換 )にあたります。
特性関数を使う理由は二つです。第一に、独立な確率変数の和 の特性関数は特性関数の積 になります。X , Y X, Y X , Y E [ e i t ( X + Y ) ] = E [ e i t X e i t Y ] = φ X ( t ) φ Y ( t ) E[e^{it(X+Y)}] = E[e^{itX}e^{itY}] = \varphi_X(t)\varphi_Y(t) E [ e i t ( X + Y ) ] = E [ e i tX e i t Y ] = φ X ( t ) φ Y ( t ) 独立な確率変数の積の期待値(命題 7.5)[確率変数と期待値] が期待値の積になることを、有界可測関数 e i t x e^{itx} e i t x
定理 5.2 (レヴィの連続性定理 ) ✓
確率変数列 ( X n ) (X_n) ( X n ) X X X
X n → d X X_n \xrightarrow{d} X X n d X t ∈ R t \in \mathbb{R} t ∈ R φ X n ( t ) → φ X ( t ) \varphi_{X_n}(t) \to \varphi_X(t) φ X n ( t ) → φ X ( t ) 逆に、ある関数 ψ : R → C \psi : \mathbb{R} \to \mathbb{C} ψ : R → C t t t φ X n ( t ) → ψ ( t ) \varphi_{X_n}(t) \to \psi(t) φ X n ( t ) → ψ ( t ) ψ \psi ψ t = 0 t = 0 t = 0 ψ \psi ψ X X X X n → d X X_n \xrightarrow{d} X X n d X
証明(定理 5.2) 特性関数と Gauss ベクトル で証明した二つの定理に帰着させます。橋渡しは、定義 3.4 (分布関数が極限の連続点で収束すること)が、分布の弱収束(すべての有界連続関数の積分が収束すること)と同値であるという 補題 4.2[特性関数と Gauss ベクトル] です。
(1) X n → d X X_n\xrightarrow{d}X X n d X 補題 4.2[特性関数と Gauss ベクトル] により X n X_n X n X X X 定理 4.4[特性関数と Gauss ベクトル] の (1) ⇒ (2) から、すべての t t t φ X n ( t ) → φ X ( t ) \varphi_{X_n}(t)\to\varphi_X(t) φ X n ( t ) → φ X ( t )
(2) 仮定は 定理 4.7[特性関数と Gauss ベクトル] の仮定そのものなので、ψ \psi ψ μ \mu μ X n X_n X n μ \mu μ ( R , B ( R ) , μ ) (\mathbb{R},\mathcal{B}(\mathbb{R}),\mu) ( R , B ( R ) , μ ) X ( x ) = x X(x)=x X ( x ) = x μ \mu μ φ X = ψ \varphi_X=\psi φ X = ψ 補題 4.2[特性関数と Gauss ベクトル] により X n → d X X_n\xrightarrow{d}X X n d X
∎ 補題 5.4 (特性関数の 2 次展開 ) ✓
確率変数 X X X E [ X ] = 0 E[X] = 0 E [ X ] = 0 E [ X 2 ] = σ 2 < ∞ E[X^2] = \sigma^2 < \infty E [ X 2 ] = σ 2 < ∞ t → 0 t \to 0 t → 0
φ X ( t ) = 1 − σ 2 t 2 2 + o ( t 2 ) \varphi_X(t) = 1 - \frac{\sigma^2 t^2}{2} + o(t^2) φ X ( t ) = 1 − 2 σ 2 t 2 + o ( t 2 ) が成り立つ。
証明(補題 5.4) 実数 u u u
∣ e i u − ( 1 + i u − u 2 2 ) ∣ ≤ min ( ∣ u ∣ 3 6 , u 2 ) \left|e^{iu} - \left(1 + iu - \frac{u^2}{2}\right)\right| \le \min\left(\frac{|u|^3}{6},\ u^2\right) e i u − ( 1 + i u − 2 u 2 ) ≤ min ( 6 ∣ u ∣ 3 , u 2 ) を使います。これは e i u − ∑ k = 0 m ( i u ) k k ! = i m + 1 m ! ∫ 0 u ( u − s ) m e i s d s e^{iu} - \sum_{k=0}^{m}\frac{(iu)^k}{k!} = \frac{i^{m+1}}{m!}\int_0^u (u-s)^m e^{is}\,ds e i u − ∑ k = 0 m k ! ( i u ) k = m ! i m + 1 ∫ 0 u ( u − s ) m e i s d s ∣ e i s ∣ = 1 |e^{is}| = 1 ∣ e i s ∣ = 1 m = 2 m = 2 m = 2 m = 1 m = 1 m = 1 m = 2 m=2 m = 2 ∣ u ∣ 3 / 6 |u|^3/6 ∣ u ∣ 3 /6 m = 1 m=1 m = 1 u 2 u^2 u 2 ( i u ) 2 2 \frac{(iu)^2}{2} 2 ( i u ) 2
u = t X u = tX u = tX E [ X ] = 0 E[X] = 0 E [ X ] = 0
∣ φ X ( t ) − 1 + σ 2 t 2 2 ∣ = ∣ E [ e i t X − 1 − i t X + t 2 X 2 2 ] ∣ ≤ E [ min ( ∣ t ∣ 3 ∣ X ∣ 3 6 , t 2 X 2 ) ] . \left|\varphi_X(t) - 1 + \frac{\sigma^2t^2}{2}\right| = \left|E\left[e^{itX} - 1 - itX + \frac{t^2X^2}{2}\right]\right| \le E\left[\min\left(\frac{|t|^3|X|^3}{6},\ t^2X^2\right)\right]. φ X ( t ) − 1 + 2 σ 2 t 2 = E [ e i tX − 1 − i tX + 2 t 2 X 2 ] ≤ E [ min ( 6 ∣ t ∣ 3 ∣ X ∣ 3 , t 2 X 2 ) ] . 右辺を t 2 t^2 t 2 E [ R t ] E[R_t] E [ R t ] R t = min ( ∣ t ∣ ∣ X ∣ 3 6 , X 2 ) R_t = \min\left(\frac{|t||X|^3}{6}, X^2\right) R t = min ( 6 ∣ t ∣∣ X ∣ 3 , X 2 ) ω \omega ω t → 0 t \to 0 t → 0 R t → 0 R_t \to 0 R t → 0 0 ≤ R t ≤ X 2 0 \le R_t \le X^2 0 ≤ R t ≤ X 2 E [ X 2 ] < ∞ E[X^2] < \infty E [ X 2 ] < ∞ E [ R t ] → 0 E[R_t] \to 0 E [ R t ] → 0 o ( t 2 ) o(t^2) o ( t 2 )
∎ 補題 5.5 (指数関数への収束 ) ✓
複素数列 ( c n ) (c_n) ( c n ) c n → c ∈ C c_n \to c \in \mathbb{C} c n → c ∈ C
lim n → ∞ ( 1 + c n n ) n = e c \lim_{n\to\infty}\left(1 + \frac{c_n}{n}\right)^n = e^{c} n → ∞ lim ( 1 + n c n ) n = e c が成り立つ。
次の補題は、( 1 + c / n ) n → e c (1+c/n)^n \to e^c ( 1 + c / n ) n → e c c c c n n n ( 1 + c n / n ) n (1+c_n/n)^n ( 1 + c n / n ) n e c n = ( e c n / n ) n e^{c_n}=(e^{c_n/n})^n e c n = ( e c n / n ) n n n n 0 0 0 θ n \theta_n θ n
証明(補題 5.5) M = sup n ∣ c n ∣ < ∞ M = \sup_n |c_n| < \infty M = sup n ∣ c n ∣ < ∞ z n = 1 + c n / n z_n = 1 + c_n/n z n = 1 + c n / n w n = e c n / n w_n = e^{c_n/n} w n = e c n / n ∣ z n ∣ ≤ 1 + M / n |z_n| \le 1 + M/n ∣ z n ∣ ≤ 1 + M / n ∣ w n ∣ ≤ e M / n ≤ 1 + M / n ⋅ e M |w_n| \le e^{M/n} \le 1 + M/n \cdot e^{M} ∣ w n ∣ ≤ e M / n ≤ 1 + M / n ⋅ e M θ n = e M / n + M / n \theta_n = e^{M/n} + M/n θ n = e M / n + M / n ∣ z n ∣ , ∣ w n ∣ ≤ θ n |z_n|, |w_n| \le \theta_n ∣ z n ∣ , ∣ w n ∣ ≤ θ n θ n n − 1 ≤ ( 1 + 2 M + M 2 n ) n ≤ e 2 M + M 2 \theta_n^{\,n-1} \le \left(1 + \tfrac{2M+M^2}{n}\right)^{n} \le e^{2M+M^2} θ n n − 1 ≤ ( 1 + n 2 M + M 2 ) n ≤ e 2 M + M 2 n n n
複素数 a , b a, b a , b ∣ a ∣ , ∣ b ∣ ≤ θ |a|, |b| \le \theta ∣ a ∣ , ∣ b ∣ ≤ θ a n − b n = ( a − b ) ∑ k = 0 n − 1 a k b n − 1 − k a^n - b^n = (a-b)\sum_{k=0}^{n-1} a^k b^{n-1-k} a n − b n = ( a − b ) ∑ k = 0 n − 1 a k b n − 1 − k ∣ a n − b n ∣ ≤ n θ n − 1 ∣ a − b ∣ |a^n - b^n| \le n\theta^{n-1}|a-b| ∣ a n − b n ∣ ≤ n θ n − 1 ∣ a − b ∣
∣ e u − 1 − u ∣ = ∣ ∑ k ≥ 2 u k k ! ∣ ≤ ∣ u ∣ 2 2 e ∣ u ∣ |e^{u} - 1 - u| = \left|\sum_{k\ge2}\frac{u^k}{k!}\right| \le \frac{|u|^2}{2}e^{|u|} ∣ e u − 1 − u ∣ = k ≥ 2 ∑ k ! u k ≤ 2 ∣ u ∣ 2 e ∣ u ∣ なので、u = c n / n u = c_n/n u = c n / n ∣ z n − w n ∣ ≤ M 2 2 n 2 e M |z_n - w_n| \le \frac{M^2}{2n^2}e^{M} ∣ z n − w n ∣ ≤ 2 n 2 M 2 e M n n n
∣ z n n − w n n ∣ ≤ n ⋅ e 2 M + M 2 ⋅ M 2 e M 2 n 2 = M 2 e 3 M + M 2 2 n → n → ∞ 0. \left|z_n^{\,n} - w_n^{\,n}\right| \le n \cdot e^{2M+M^2}\cdot \frac{M^2 e^{M}}{2n^2} = \frac{M^2 e^{3M + M^2}}{2n} \xrightarrow[n\to\infty]{} 0 . ∣ z n n − w n n ∣ ≤ n ⋅ e 2 M + M 2 ⋅ 2 n 2 M 2 e M = 2 n M 2 e 3 M + M 2 n → ∞ 0. 一方 w n n = e c n → e c w_n^{\,n} = e^{c_n} \to e^{c} w n n = e c n → e c z n n → e c z_n^{\,n} \to e^c z n n → e c
∎ 定理 5.6 (中心極限定理(リンドバーグ・レヴィ) ) ✓
X 1 , X 2 , … X_1, X_2, \ldots X 1 , X 2 , … μ = E [ X 1 ] \mu = E[X_1] μ = E [ X 1 ] σ 2 = Var ( X 1 ) \sigma^2 = \operatorname{Var}(X_1) σ 2 = Var ( X 1 ) 0 < σ 2 < ∞ 0 < \sigma^2 < \infty 0 < σ 2 < ∞ S n = ∑ i = 1 n X i S_n = \sum_{i=1}^n X_i S n = ∑ i = 1 n X i
Z n = S n − n μ σ n → d Z ∼ N ( 0 , 1 ) Z_n = \frac{S_n - n\mu}{\sigma\sqrt{n}} \xrightarrow{d} Z \sim N(0,1) Z n = σ n S n − n μ d Z ∼ N ( 0 , 1 ) が成り立つ。すなわち、すべての x ∈ R x \in \mathbb{R} x ∈ R
lim n → ∞ P ( S n − n μ σ n ≤ x ) = Φ ( x ) = ∫ − ∞ x 1 2 π e − u 2 / 2 d u . \lim_{n\to\infty} P\left(\frac{S_n - n\mu}{\sigma\sqrt{n}} \le x\right) = \Phi(x) = \int_{-\infty}^{x}\frac{1}{\sqrt{2\pi}}e^{-u^2/2}\,du . n → ∞ lim P ( σ n S n − n μ ≤ x ) = Φ ( x ) = ∫ − ∞ x 2 π 1 e − u 2 /2 d u . 証明(定理 5.6) Y i = ( X i − μ ) / σ Y_i = (X_i - \mu)/\sigma Y i = ( X i − μ ) / σ Y i Y_i Y i E [ Y i ] = 0 E[Y_i] = 0 E [ Y i ] = 0 E [ Y i 2 ] = 1 E[Y_i^2] = 1 E [ Y i 2 ] = 1
Z n = 1 n ∑ i = 1 n Y i . Z_n = \frac{1}{\sqrt{n}}\sum_{i=1}^{n} Y_i . Z n = n 1 i = 1 ∑ n Y i . φ \varphi φ Y 1 Y_1 Y 1 E [ e i t ( Y / n ) ] = φ ( t / n ) E[e^{it(Y/\sqrt n)}] = \varphi(t/\sqrt n) E [ e i t ( Y / n ) ] = φ ( t / n )
φ Z n ( t ) = E [ exp ( i t n ∑ i = 1 n Y i ) ] = ∏ i = 1 n φ ( t n ) = [ φ ( t n ) ] n . \varphi_{Z_n}(t) = E\left[\exp\left(\frac{it}{\sqrt{n}}\sum_{i=1}^n Y_i\right)\right] = \prod_{i=1}^{n} \varphi\!\left(\frac{t}{\sqrt{n}}\right) = \left[\varphi\!\left(\frac{t}{\sqrt{n}}\right)\right]^{n}. φ Z n ( t ) = E [ exp ( n i t i = 1 ∑ n Y i ) ] = i = 1 ∏ n φ ( n t ) = [ φ ( n t ) ] n . t t t n → ∞ n \to \infty n → ∞ t / n → 0 t/\sqrt{n} \to 0 t / n → 0 補題 5.4 (σ 2 = 1 \sigma^2 = 1 σ 2 = 1
φ ( t n ) = 1 − t 2 2 n + o ( 1 n ) = 1 + c n n , c n = − t 2 2 + n ⋅ o ( 1 n ) . \varphi\!\left(\frac{t}{\sqrt{n}}\right) = 1 - \frac{t^2}{2n} + o\!\left(\frac{1}{n}\right) = 1 + \frac{c_n}{n}, \qquad c_n = -\frac{t^2}{2} + n\cdot o\!\left(\frac{1}{n}\right). φ ( n t ) = 1 − 2 n t 2 + o ( n 1 ) = 1 + n c n , c n = − 2 t 2 + n ⋅ o ( n 1 ) . ここで o ( 1 / n ) o(1/n) o ( 1/ n ) n → ∞ n\to\infty n → ∞ n n n 0 0 0 c n → − t 2 / 2 c_n \to -t^2/2 c n → − t 2 /2 補題 5.5 を適用して
φ Z n ( t ) = ( 1 + c n n ) n → n → ∞ e − t 2 / 2 . \varphi_{Z_n}(t) = \left(1 + \frac{c_n}{n}\right)^{n} \xrightarrow[n\to\infty]{} e^{-t^2/2}. φ Z n ( t ) = ( 1 + n c n ) n n → ∞ e − t 2 /2 . これがすべての t ∈ R t \in \mathbb{R} t ∈ R e − t 2 / 2 e^{-t^2/2} e − t 2 /2 N ( 0 , 1 ) N(0,1) N ( 0 , 1 ) t = 0 t=0 t = 0 定理 5.2 (2) より Z n → d N ( 0 , 1 ) Z_n \xrightarrow{d} N(0,1) Z n d N ( 0 , 1 )
最後に、Φ \Phi Φ R \mathbb{R} R 定義 3.4 の「連続点で」という制限は消え、すべての x x x
∎ 証明を振り返ると、正規分布が現れた理由がはっきりします。Y 1 Y_1 Y 1 E [ Y ] = 0 E[Y]=0 E [ Y ] = 0 E [ Y 2 ] = 1 E[Y^2]=1 E [ Y 2 ] = 1 o ( t 2 ) o(t^2) o ( t 2 ) n \sqrt{n} n
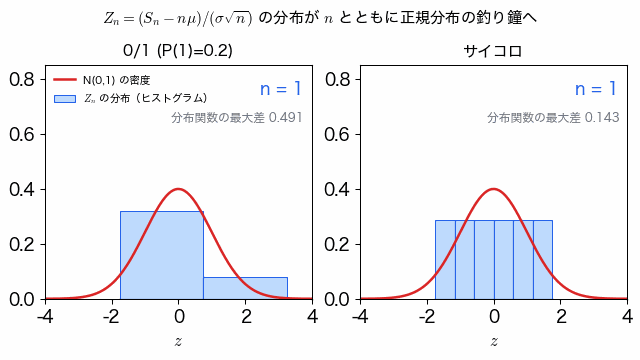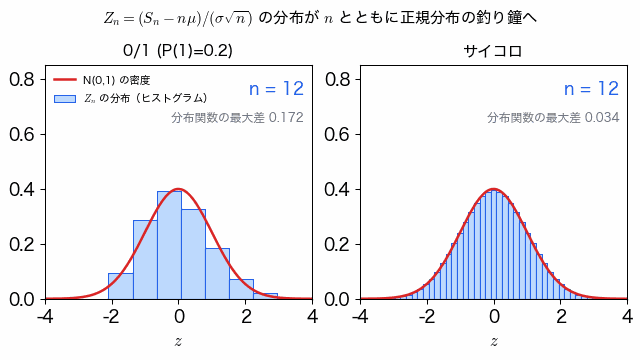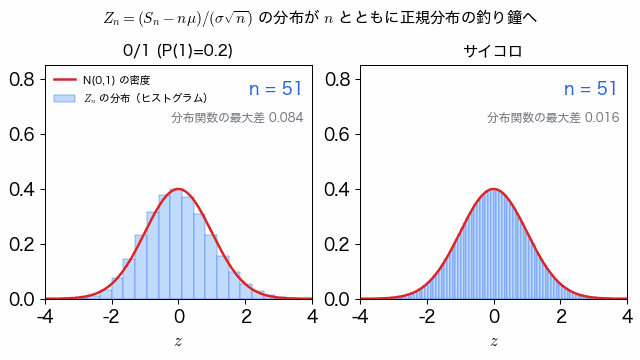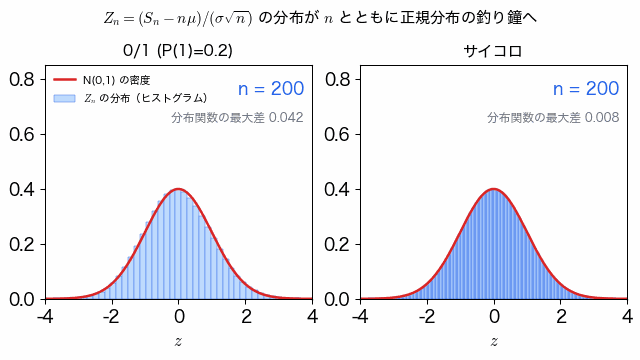
標準正規分布の密度と、確率 95% を占める区間 [-1.96, 1.96] n n n Z n Z_n Z n 0 0 0 1 1 1 N ( 0 , 1 ) N(0,1) N ( 0 , 1 ) Z n Z_n Z n
Z n n = 1 200 P ( X = 1 ) = 0.2 例 5.7 (コイン投げ再訪:チェビシェフと正規近似の比較 )
例 4.2 の設定(n = 10,000 n = 10{,}000 n = 10 , 000 μ = 1 / 2 \mu = 1/2 μ = 1/2 σ = 1 / 2 \sigma = 1/2 σ = 1/2 P ( ∣ X ˉ n − 1 / 2 ∣ ≥ 0.01 ) P(|\bar{X}_n - 1/2| \ge 0.01) P ( ∣ X ˉ n − 1/2∣ ≥ 0.01 ) X ˉ n \bar{X}_n X ˉ n σ / n = 0.5 / 100 = 0.005 \sigma/\sqrt{n} = 0.5/100 = 0.005 σ / n = 0.5/100 = 0.005 0.01 0.01 0.01 2 2 2 定理 5.6 より
P ( ∣ X ˉ n − 1 2 ∣ ≥ 0.01 ) = P ( ∣ Z n ∣ ≥ 2 ) ≈ 2 ( 1 − Φ ( 2 ) ) = 2 × 0.02275 = 0.0455. P\left(\left|\bar{X}_n - \tfrac12\right| \ge 0.01\right) = P(|Z_n| \ge 2) \approx 2\left(1 - \Phi(2)\right) = 2 \times 0.02275 = 0.0455 . P ( X ˉ n − 2 1 ≥ 0.01 ) = P ( ∣ Z n ∣ ≥ 2 ) ≈ 2 ( 1 − Φ ( 2 ) ) = 2 × 0.02275 = 0.0455. チェビシェフの 0.25 0.25 0.25 0.046 0.046 0.046 5 5 5 n → ∞ n \to \infty n → ∞ n n n
有限の n n n ∣ t ∣ ≤ T |t|\le T ∣ t ∣ ≤ T 1 / T 1/T 1/ T
補題 5.8 (エセーンの平滑化不等式 ) ✓
F F F X X X φ \varphi φ Φ \Phi Φ m = 1 / 2 π m=1/\sqrt{2\pi} m = 1/ 2 π T > 0 T\gt0 T > 0 ∫ − T T ∣ φ ( t ) − e − t 2 / 2 ∣ ∣ t ∣ d t < ∞ \displaystyle\int_{-T}^{T}\frac{|\varphi(t)-e^{-t^2/2}|}{|t|}\,dt\lt\infty ∫ − T T ∣ t ∣ ∣ φ ( t ) − e − t 2 /2 ∣ d t < ∞
sup x ∈ R ∣ F ( x ) − Φ ( x ) ∣ ≤ 1 π ∫ − T T ∣ φ ( t ) − e − t 2 / 2 ∣ ∣ t ∣ d t + 24 m π T . \sup_{x\in\mathbb{R}}|F(x)-\Phi(x)|\le\frac1\pi\int_{-T}^{T}\frac{|\varphi(t)-e^{-t^2/2}|}{|t|}\,dt+\frac{24m}{\pi T}. x ∈ R sup ∣ F ( x ) − Φ ( x ) ∣ ≤ π 1 ∫ − T T ∣ t ∣ ∣ φ ( t ) − e − t 2 /2 ∣ d t + π T 24 m . 証明は三段階です。(1) 分布を少しぼかすための、特性関数が簡単な形になる密度 h T h_T h T T T T h T h_T h T
証明(補題 5.8) (1) ぼかしの核. Λ T ( t ) = ( 1 − ∣ t ∣ / T ) + \Lambda_T(t)=(1-|t|/T)_+ Λ T ( t ) = ( 1 − ∣ t ∣/ T ) + h T ( y ) = 1 − cos T y π T y 2 h_T(y)=\dfrac{1-\cos Ty}{\pi Ty^2} h T ( y ) = π T y 2 1 − cos T y Λ T \Lambda_T Λ T
∫ R Λ T ( t ) e − i t y d t = 2 ∫ 0 T ( 1 − t T ) cos ( t y ) d t = 2 T y ∫ 0 T sin ( t y ) d t = 2 ( 1 − cos T y ) T y 2 = 2 π h T ( y ) \int_{\mathbb{R}}\Lambda_T(t)e^{-ity}\,dt=2\int_0^T\Bigl(1-\frac tT\Bigr)\cos(ty)\,dt=\frac{2}{Ty}\int_0^T\sin(ty)\,dt=\frac{2(1-\cos Ty)}{Ty^2}=2\pi h_T(y) ∫ R Λ T ( t ) e − i t y d t = 2 ∫ 0 T ( 1 − T t ) cos ( t y ) d t = T y 2 ∫ 0 T sin ( t y ) d t = T y 2 2 ( 1 − cos T y ) = 2 π h T ( y ) です。0 ≤ h T ( y ) ≤ min ( T 2 π , 2 π T y 2 ) 0\le h_T(y)\le\min\bigl(\frac{T}{2\pi},\frac{2}{\pi Ty^2}\bigr) 0 ≤ h T ( y ) ≤ min ( 2 π T , π T y 2 2 ) 1 − cos u ≤ u 2 / 2 1-\cos u\le u^2/2 1 − cos u ≤ u 2 /2 1 − cos u ≤ 2 1-\cos u\le2 1 − cos u ≤ 2 h T ∈ L 1 h_T\in L^1 h T ∈ L 1 Λ T ∈ L 1 \Lambda_T\in L^1 Λ T ∈ L 1 定理 3.3[ℝⁿ 上のフーリエ変換] )を使うと、両辺が連続なのですべての t t t ∫ h T ( y ) e i t y d y = Λ T ( t ) \int h_T(y)e^{ity}dy=\Lambda_T(t) ∫ h T ( y ) e i t y d y = Λ T ( t ) h T h_T h T Λ T \Lambda_T Λ T
(2) ぼかした差の表示. 確率空間を広げて、X X X h T h_T h T Y Y Y Z Z Z Z Z Z Y Y Y Δ = F − Φ \Delta=F-\Phi Δ = F − Φ Δ T ( x ) = ∫ Δ ( x − y ) h T ( y ) d y \Delta_T(x)=\int\Delta(x-y)h_T(y)\,dy Δ T ( x ) = ∫ Δ ( x − y ) h T ( y ) d y Δ T ( x ) = P ( X + Y ≤ x ) − P ( Z + Y ≤ x ) \Delta_T(x)=P(X+Y\le x)-P(Z+Y\le x) Δ T ( x ) = P ( X + Y ≤ x ) − P ( Z + Y ≤ x ) X + Y X+Y X + Y φ Λ T \varphi\Lambda_T φ Λ T 命題 2.2[特性関数と Gauss ベクトル] の 4)で、台が [ − T , T ] [-T,T] [ − T , T ] 定理 3.3[特性関数と Gauss ベクトル] の 2 から X + Y X+Y X + Y f T ( x ) = 1 2 π ∫ φ ( t ) Λ T ( t ) e − i t x d t f_T(x)=\frac1{2\pi}\int\varphi(t)\Lambda_T(t)e^{-itx}dt f T ( x ) = 2 π 1 ∫ φ ( t ) Λ T ( t ) e − i t x d t Z + Y Z+Y Z + Y g T ( x ) = 1 2 π ∫ e − t 2 / 2 Λ T ( t ) e − i t x d t g_T(x)=\frac1{2\pi}\int e^{-t^2/2}\Lambda_T(t)e^{-itx}dt g T ( x ) = 2 π 1 ∫ e − t 2 /2 Λ T ( t ) e − i t x d t e − t 2 / 2 e^{-t^2/2} e − t 2 /2 Z Z Z 補題 2.3[特性関数と Gauss ベクトル] )。D ( t ) = φ ( t ) − e − t 2 / 2 D(t)=\varphi(t)-e^{-t^2/2} D ( t ) = φ ( t ) − e − t 2 /2 a < b a\lt b a < b
Δ T ( b ) − Δ T ( a ) = ∫ a b ( f T − g T ) d x = 1 2 π ∫ − T T D ( t ) Λ T ( t ) e − i t a − e − i t b i t d t . \Delta_T(b)-\Delta_T(a)=\int_a^b(f_T-g_T)\,dx=\frac1{2\pi}\int_{-T}^{T}D(t)\Lambda_T(t)\,\frac{e^{-ita}-e^{-itb}}{it}\,dt . Δ T ( b ) − Δ T ( a ) = ∫ a b ( f T − g T ) d x = 2 π 1 ∫ − T T D ( t ) Λ T ( t ) i t e − i t a − e − i t b d t . 仮定から k ( t ) = D ( t ) Λ T ( t ) / ( i t ) k(t)=D(t)\Lambda_T(t)/(it) k ( t ) = D ( t ) Λ T ( t ) / ( i t ) L 1 ( R ) L^1(\mathbb{R}) L 1 ( R ) 1 2 π ( k ^ ( a ) − k ^ ( b ) ) \frac1{2\pi}(\hat k(a)-\hat k(b)) 2 π 1 ( k ^ ( a ) − k ^ ( b )) k ^ \hat k k ^ 定義 2.1[ℝⁿ 上のフーリエ変換] の Fourier 変換)。a → − ∞ a\to-\infty a → − ∞ Δ T ( a ) → 0 \Delta_T(a)\to0 Δ T ( a ) → 0 0 0 0 k ^ ( a ) → 0 \hat k(a)\to0 k ^ ( a ) → 0 定理 2.4[ℝⁿ 上のフーリエ変換] )なので、
∣ Δ T ( b ) ∣ = 1 2 π ∣ k ^ ( b ) ∣ ≤ 1 2 π ∫ − T T ∣ D ( t ) ∣ ∣ t ∣ d t ( b ∈ R ) . |\Delta_T(b)|=\frac1{2\pi}|\hat k(b)|\le\frac1{2\pi}\int_{-T}^{T}\frac{|D(t)|}{|t|}\,dt\qquad(b\in\mathbb{R}). ∣ Δ T ( b ) ∣ = 2 π 1 ∣ k ^ ( b ) ∣ ≤ 2 π 1 ∫ − T T ∣ t ∣ ∣ D ( t ) ∣ d t ( b ∈ R ) . (3) ぼかしによる損失. η = sup ∣ Δ ∣ \eta=\sup|\Delta| η = sup ∣Δ∣ η > 0 \eta\gt0 η > 0 Δ ( x ) → 0 \Delta(x)\to0 Δ ( x ) → 0 x → ± ∞ x\to\pm\infty x → ± ∞ ∣ Δ ( x n ) ∣ → η |\Delta(x_n)|\to\eta ∣Δ ( x n ) ∣ → η Δ ( x n ) \Delta(x_n) Δ ( x n ) x 0 x_0 x 0 F F F Φ \Phi Φ Δ ( x 0 ) \Delta(x_0) Δ ( x 0 ) Δ ( x 0 − ) = F ( x 0 − ) − Φ ( x 0 ) \Delta(x_0-)=F(x_0-)-\Phi(x_0) Δ ( x 0 − ) = F ( x 0 − ) − Φ ( x 0 ) η \eta η − η -\eta − η F F F Φ ′ ≤ m \Phi'\le m Φ ′ ≤ m s > 0 s\gt0 s > 0
(A) Δ ( x 0 ) = η \Delta(x_0)=\eta Δ ( x 0 ) = η Δ ( x 0 − ) = η \Delta(x_0-)=\eta Δ ( x 0 − ) = η F ( x 0 + s ) ≥ F ( x 0 ) ≥ F ( x 0 − ) F(x_0+s)\ge F(x_0)\ge F(x_0-) F ( x 0 + s ) ≥ F ( x 0 ) ≥ F ( x 0 − ) F ( x 0 + s ) − Φ ( x 0 ) ≥ max ( Δ ( x 0 ) , Δ ( x 0 − ) ) = η F(x_0+s)-\Phi(x_0)\ge\max(\Delta(x_0),\Delta(x_0-))=\eta F ( x 0 + s ) − Φ ( x 0 ) ≥ max ( Δ ( x 0 ) , Δ ( x 0 − )) = η Φ ( x 0 + s ) ≤ Φ ( x 0 ) + m s \Phi(x_0+s)\le\Phi(x_0)+ms Φ ( x 0 + s ) ≤ Φ ( x 0 ) + m s Δ ( x 0 + s ) ≥ η − m s \Delta(x_0+s)\ge\eta-ms Δ ( x 0 + s ) ≥ η − m s
(B) Δ ( x 0 ) = − η \Delta(x_0)=-\eta Δ ( x 0 ) = − η Δ ( x 0 − ) = − η \Delta(x_0-)=-\eta Δ ( x 0 − ) = − η F ( x 0 − s ) ≤ F ( x 0 − ) F(x_0-s)\le F(x_0-) F ( x 0 − s ) ≤ F ( x 0 − ) Φ ( x 0 − s ) ≥ Φ ( x 0 ) − m s \Phi(x_0-s)\ge\Phi(x_0)-ms Φ ( x 0 − s ) ≥ Φ ( x 0 ) − m s Δ ( x 0 − s ) ≤ − η + m s \Delta(x_0-s)\le-\eta+ms Δ ( x 0 − s ) ≤ − η + m s
(A) の場合、δ = η / ( 2 m ) \delta=\eta/(2m) δ = η / ( 2 m ) x = x 0 + δ x=x_0+\delta x = x 0 + δ ∣ y ∣ < δ |y|\lt\delta ∣ y ∣ < δ Δ ( x − y ) ≥ η − m ( δ − y ) = η 2 + m y \Delta(x-y)\ge\eta-m(\delta-y)=\frac\eta2+my Δ ( x − y ) ≥ η − m ( δ − y ) = 2 η + m y ∣ y ∣ ≥ δ |y|\ge\delta ∣ y ∣ ≥ δ Δ ( x − y ) ≥ − η \Delta(x-y)\ge-\eta Δ ( x − y ) ≥ − η h T h_T h T ∫ ∣ y ∣ < δ y h T ( y ) d y = 0 \int_{|y|\lt\delta}y\,h_T(y)dy=0 ∫ ∣ y ∣ < δ y h T ( y ) d y = 0 P δ = ∫ ∣ y ∣ ≥ δ h T P_\delta=\int_{|y|\ge\delta}h_T P δ = ∫ ∣ y ∣ ≥ δ h T
Δ T ( x ) ≥ η 2 ( 1 − P δ ) − η P δ = η 2 − 3 η 2 P δ , P δ ≤ 2 ∫ δ ∞ 2 π T y 2 d y = 4 π T δ = 8 m π T η . \Delta_T(x)\ge\frac\eta2(1-P_\delta)-\eta P_\delta=\frac\eta2-\frac{3\eta}2P_\delta,\qquad P_\delta\le2\int_\delta^\infty\frac{2}{\pi Ty^2}dy=\frac{4}{\pi T\delta}=\frac{8m}{\pi T\eta}. Δ T ( x ) ≥ 2 η ( 1 − P δ ) − η P δ = 2 η − 2 3 η P δ , P δ ≤ 2 ∫ δ ∞ π T y 2 2 d y = π T δ 4 = π T η 8 m . よって Δ T ( x ) ≥ η 2 − 12 m π T \Delta_T(x)\ge\frac\eta2-\frac{12m}{\pi T} Δ T ( x ) ≥ 2 η − π T 12 m x = x 0 − δ x=x_0-\delta x = x 0 − δ Δ T ( x ) ≤ − η 2 + 12 m π T \Delta_T(x)\le-\frac\eta2+\frac{12m}{\pi T} Δ T ( x ) ≤ − 2 η + π T 12 m sup ∣ Δ T ∣ ≥ η 2 − 12 m π T \sup|\Delta_T|\ge\frac\eta2-\frac{12m}{\pi T} sup ∣ Δ T ∣ ≥ 2 η − π T 12 m η ≤ 2 sup ∣ Δ T ∣ + 24 m π T \eta\le2\sup|\Delta_T|+\frac{24m}{\pi T} η ≤ 2 sup ∣ Δ T ∣ + π T 24 m
∎ 定理 5.9 (ベリー・エセーンの定理 ) ✓
X 1 , X 2 , … X_1, X_2, \ldots X 1 , X 2 , … E [ X 1 ] = μ E[X_1] = \mu E [ X 1 ] = μ Var ( X 1 ) = σ 2 ∈ ( 0 , ∞ ) \operatorname{Var}(X_1) = \sigma^2 \in (0,\infty) Var ( X 1 ) = σ 2 ∈ ( 0 , ∞ ) ρ = E [ ∣ X 1 − μ ∣ 3 ] < ∞ \rho = E[|X_1 - \mu|^3] < \infty ρ = E [ ∣ X 1 − μ ∣ 3 ] < ∞ F n F_n F n Z n = ( S n − n μ ) / ( σ n ) Z_n = (S_n - n\mu)/(\sigma\sqrt{n}) Z n = ( S n − n μ ) / ( σ n ) C C C
sup x ∈ R ∣ F n ( x ) − Φ ( x ) ∣ ≤ C ρ σ 3 n \sup_{x \in \mathbb{R}} \left|F_n(x) - \Phi(x)\right| \le \frac{C\rho}{\sigma^3\sqrt{n}} x ∈ R sup ∣ F n ( x ) − Φ ( x ) ∣ ≤ σ 3 n C ρ がすべての n ≥ 1 n \ge 1 n ≥ 1
証明(定理 5.9) Y i = ( X i − μ ) / σ Y_i=(X_i-\mu)/\sigma Y i = ( X i − μ ) / σ E [ Y 1 ] = 0 E[Y_1]=0 E [ Y 1 ] = 0 E [ Y 1 2 ] = 1 E[Y_1^2]=1 E [ Y 1 2 ] = 1 β : = E ∣ Y 1 ∣ 3 = ρ / σ 3 \beta:=E|Y_1|^3=\rho/\sigma^3 β := E ∣ Y 1 ∣ 3 = ρ / σ 3 定理 4.2[L^p 空間と関数解析への導入] 、p = 3 / 2 p=3/2 p = 3/2 q = 3 q=3 q = 3 1 = E [ ∣ Y 1 ∣ 2 ⋅ 1 ] ≤ ( E ∣ Y 1 ∣ 3 ) 2 / 3 1=E[|Y_1|^2\cdot1]\le(E|Y_1|^3)^{2/3} 1 = E [ ∣ Y 1 ∣ 2 ⋅ 1 ] ≤ ( E ∣ Y 1 ∣ 3 ) 2/3 β ≥ 1 \beta\ge1 β ≥ 1 φ \varphi φ Y 1 Y_1 Y 1 定理 5.6 の証明と同じく φ Z n ( t ) = φ ( t / n ) n \varphi_{Z_n}(t)=\varphi(t/\sqrt n)^n φ Z n ( t ) = φ ( t / n ) n
(1) 二つの初等評価. 実数 u u u e i u − 1 − i u + u 2 2 = i 3 2 ∫ 0 u ( u − r ) 2 e i r d r e^{iu}-1-iu+\frac{u^2}2=\frac{i^3}{2}\int_0^u(u-r)^2e^{ir}dr e i u − 1 − i u + 2 u 2 = 2 i 3 ∫ 0 u ( u − r ) 2 e i r d r ∣ e i u − 1 − i u + u 2 2 ∣ ≤ ∣ u ∣ 3 6 |e^{iu}-1-iu+\frac{u^2}{2}|\le\frac{|u|^3}6 ∣ e i u − 1 − i u + 2 u 2 ∣ ≤ 6 ∣ u ∣ 3 補題 5.4 の証明の評価)。u = s Y 1 u=sY_1 u = s Y 1
∣ φ ( s ) − 1 + s 2 2 ∣ ≤ β ∣ s ∣ 3 6 . \Bigl|\varphi(s)-1+\frac{s^2}2\Bigr|\le\frac{\beta|s|^3}6 . φ ( s ) − 1 + 2 s 2 ≤ 6 β ∣ s ∣ 3 . また w ≥ 0 w\ge0 w ≥ 0 0 ≤ e − w − 1 + w = ∫ 0 w ( w − r ) e − r d r ≤ w 2 2 0\le e^{-w}-1+w=\int_0^w(w-r)e^{-r}dr\le\frac{w^2}2 0 ≤ e − w − 1 + w = ∫ 0 w ( w − r ) e − r d r ≤ 2 w 2 ∣ e − s 2 / 2 − 1 + s 2 2 ∣ ≤ s 4 8 |e^{-s^2/2}-1+\frac{s^2}2|\le\frac{s^4}8 ∣ e − s 2 /2 − 1 + 2 s 2 ∣ ≤ 8 s 4
(2) ∣ t ∣ ≤ T : = n / β |t|\le T:=\sqrt n/\beta ∣ t ∣ ≤ T := n / β s = t / n s=t/\sqrt n s = t / n ∣ s ∣ ≤ 1 / β ≤ 1 |s|\le1/\beta\le1 ∣ s ∣ ≤ 1/ β ≤ 1 ∣ φ ( s ) ∣ ≤ 1 − s 2 2 + β ∣ s ∣ 3 6 ≤ 1 − s 2 3 ≤ e − s 2 / 3 |\varphi(s)|\le1-\frac{s^2}2+\frac{\beta|s|^3}6\le1-\frac{s^2}3\le e^{-s^2/3} ∣ φ ( s ) ∣ ≤ 1 − 2 s 2 + 6 β ∣ s ∣ 3 ≤ 1 − 3 s 2 ≤ e − s 2 /3 β ∣ s ∣ ≤ 1 \beta|s|\le1 β ∣ s ∣ ≤ 1 1 − s 2 2 ≥ 0 1-\frac{s^2}{2}\ge0 1 − 2 s 2 ≥ 0 e − s 2 / 2 ≤ e − s 2 / 3 e^{-s^2/2}\le e^{-s^2/3} e − s 2 /2 ≤ e − s 2 /3 a , b a,b a , b ∣ a ∣ , ∣ b ∣ ≤ γ |a|,|b|\le\gamma ∣ a ∣ , ∣ b ∣ ≤ γ ∣ a n − b n ∣ ≤ n γ n − 1 ∣ a − b ∣ |a^n-b^n|\le n\gamma^{n-1}|a-b| ∣ a n − b n ∣ ≤ n γ n − 1 ∣ a − b ∣ a n − b n = ( a − b ) ∑ k a k b n − 1 − k a^n-b^n=(a-b)\sum_ka^kb^{n-1-k} a n − b n = ( a − b ) ∑ k a k b n − 1 − k a = φ ( s ) a=\varphi(s) a = φ ( s ) b = e − s 2 / 2 b=e^{-s^2/2} b = e − s 2 /2 γ = e − s 2 / 3 \gamma=e^{-s^2/3} γ = e − s 2 /3 s 4 = ∣ s ∣ 3 ∣ s ∣ ≤ ∣ s ∣ 3 / β ≤ β ∣ s ∣ 3 s^4=|s|^3|s|\le|s|^3/\beta\le\beta|s|^3 s 4 = ∣ s ∣ 3 ∣ s ∣ ≤ ∣ s ∣ 3 / β ≤ β ∣ s ∣ 3 β ≥ 1 \beta\ge1 β ≥ 1 ∣ a − b ∣ ≤ ( 1 6 + 1 8 ) β ∣ s ∣ 3 = 7 24 β ∣ s ∣ 3 |a-b|\le(\frac16+\frac18)\beta|s|^3=\frac7{24}\beta|s|^3 ∣ a − b ∣ ≤ ( 6 1 + 8 1 ) β ∣ s ∣ 3 = 24 7 β ∣ s ∣ 3 t 2 / n = s 2 ≤ 1 t^2/n=s^2\le1 t 2 / n = s 2 ≤ 1 γ n − 1 = e − t 2 / 3 e t 2 / ( 3 n ) ≤ e 1 / 3 e − t 2 / 3 \gamma^{n-1}=e^{-t^2/3}e^{t^2/(3n)}\le e^{1/3}e^{-t^2/3} γ n − 1 = e − t 2 /3 e t 2 / ( 3 n ) ≤ e 1/3 e − t 2 /3
∣ φ Z n ( t ) − e − t 2 / 2 ∣ ≤ n ⋅ 7 24 β ∣ t ∣ 3 n 3 / 2 ⋅ e 1 / 3 e − t 2 / 3 = 7 e 1 / 3 24 β n ∣ t ∣ 3 e − t 2 / 3 ( ∣ t ∣ ≤ T ) . \bigl|\varphi_{Z_n}(t)-e^{-t^2/2}\bigr|\le n\cdot\frac7{24}\beta\frac{|t|^3}{n^{3/2}}\cdot e^{1/3}e^{-t^2/3}=\frac{7e^{1/3}}{24}\,\frac{\beta}{\sqrt n}\,|t|^3e^{-t^2/3}\qquad(|t|\le T). φ Z n ( t ) − e − t 2 /2 ≤ n ⋅ 24 7 β n 3/2 ∣ t ∣ 3 ⋅ e 1/3 e − t 2 /3 = 24 7 e 1/3 n β ∣ t ∣ 3 e − t 2 /3 ( ∣ t ∣ ≤ T ) . (3) 平滑化不等式の適用. (2) から 補題 5.8 の積分は有限で、∫ R t 2 e − t 2 / 3 d t = 3 2 3 π \int_{\mathbb{R}}t^2e^{-t^2/3}dt=\frac32\sqrt{3\pi} ∫ R t 2 e − t 2 /3 d t = 2 3 3 π
sup x ∣ F n ( x ) − Φ ( x ) ∣ ≤ 1 π ⋅ 7 e 1 / 3 24 ⋅ 3 2 3 π β n + 24 π 2 π β n ≤ 3.7 β n . \sup_x|F_n(x)-\Phi(x)|\le\frac1\pi\cdot\frac{7e^{1/3}}{24}\cdot\frac32\sqrt{3\pi}\,\frac{\beta}{\sqrt n}+\frac{24}{\pi\sqrt{2\pi}}\,\frac{\beta}{\sqrt n}\le3.7\,\frac{\beta}{\sqrt n}. x sup ∣ F n ( x ) − Φ ( x ) ∣ ≤ π 1 ⋅ 24 7 e 1/3 ⋅ 2 3 3 π n β + π 2 π 24 n β ≤ 3.7 n β . 数値は第 1 項の係数が約 0.597 0.597 0.597 3.048 3.048 3.048 β = ρ / σ 3 \beta=\rho/\sigma^3 β = ρ / σ 3 C = 3.7 C=3.7 C = 3.7
∎ 命題 6.1 (スルツキーの定理 ) ✓
X n → d X X_n \xrightarrow{d} X X n d X Y n → P c Y_n \xrightarrow{P} c Y n P c c c c
X n + Y n → d X + c , X n Y n → d c X X_n + Y_n \xrightarrow{d} X + c, \qquad X_n Y_n \xrightarrow{d} cX X n + Y n d X + c , X n Y n d c X が成り立つ。さらに c ≠ 0 c \ne 0 c = 0 X n / Y n → d X / c X_n / Y_n \xrightarrow{d} X/c X n / Y n d X / c
証明(命題 6.1) F F F X X X C F C_F C F F F F F F F C F C_F C F R \mathbb{R} R
和。 X + c X+c X + c F ( ⋅ − c ) F(\cdot-c) F ( ⋅ − c ) x − c ∈ C F x-c\in C_F x − c ∈ C F x x x P ( X n + Y n ≤ x ) → F ( x − c ) P(X_n+Y_n\le x)\to F(x-c) P ( X n + Y n ≤ x ) → F ( x − c ) ε > 0 \varepsilon>0 ε > 0 x − c ± ε ∈ C F x-c\pm\varepsilon\in C_F x − c ± ε ∈ C F
{ X n + Y n ≤ x } ⊂ { X n ≤ x − c + ε } ∪ { ∣ Y n − c ∣ > ε } , { X n ≤ x − c − ε } ⊂ { X n + Y n ≤ x } ∪ { ∣ Y n − c ∣ > ε } \{X_n+Y_n\le x\}\subset\{X_n\le x-c+\varepsilon\}\cup\{|Y_n-c|>\varepsilon\},\qquad
\{X_n\le x-c-\varepsilon\}\subset\{X_n+Y_n\le x\}\cup\{|Y_n-c|>\varepsilon\} { X n + Y n ≤ x } ⊂ { X n ≤ x − c + ε } ∪ { ∣ Y n − c ∣ > ε } , { X n ≤ x − c − ε } ⊂ { X n + Y n ≤ x } ∪ { ∣ Y n − c ∣ > ε } から
F n ( x − c − ε ) − P ( ∣ Y n − c ∣ > ε ) ≤ P ( X n + Y n ≤ x ) ≤ F n ( x − c + ε ) + P ( ∣ Y n − c ∣ > ε ) . F_n(x-c-\varepsilon)-P(|Y_n-c|>\varepsilon)\le P(X_n+Y_n\le x)\le F_n(x-c+\varepsilon)+P(|Y_n-c|>\varepsilon). F n ( x − c − ε ) − P ( ∣ Y n − c ∣ > ε ) ≤ P ( X n + Y n ≤ x ) ≤ F n ( x − c + ε ) + P ( ∣ Y n − c ∣ > ε ) . n → ∞ n\to\infty n → ∞ F ( x − c − ε ) ≤ lim inf ≤ lim sup ≤ F ( x − c + ε ) F(x-c-\varepsilon)\le\liminf\le\limsup\le F(x-c+\varepsilon) F ( x − c − ε ) ≤ lim inf ≤ lim sup ≤ F ( x − c + ε ) C F C_F C F ε ↓ 0 \varepsilon\downarrow0 ε ↓ 0 F F F x − c x-c x − c
積。 X n Y n = c X n + ( Y n − c ) X n X_nY_n=cX_n+(Y_n-c)X_n X n Y n = c X n + ( Y n − c ) X n ( Y n − c ) X n → P 0 (Y_n-c)X_n\xrightarrow{P}0 ( Y n − c ) X n P 0 η > 0 \eta>0 η > 0 M > 0 M>0 M > 0 ± M ∈ C F \pm M\in C_F ± M ∈ C F F ( − M ) < η F(-M)<\eta F ( − M ) < η 1 − F ( M ) < η 1-F(M)<\eta 1 − F ( M ) < η P ( ∣ X n ∣ > M ) ≤ F n ( − M ) + 1 − F n ( M ) → F ( − M ) + 1 − F ( M ) < 2 η P(|X_n|>M)\le F_n(-M)+1-F_n(M)\to F(-M)+1-F(M)<2\eta P ( ∣ X n ∣ > M ) ≤ F n ( − M ) + 1 − F n ( M ) → F ( − M ) + 1 − F ( M ) < 2 η ε > 0 \varepsilon>0 ε > 0
P ( ∣ ( Y n − c ) X n ∣ > ε ) ≤ P ( ∣ X n ∣ > M ) + P ( ∣ Y n − c ∣ > ε / M ) P(|(Y_n-c)X_n|>\varepsilon)\le P(|X_n|>M)+P(|Y_n-c|>\varepsilon/M) P ( ∣ ( Y n − c ) X n ∣ > ε ) ≤ P ( ∣ X n ∣ > M ) + P ( ∣ Y n − c ∣ > ε / M ) なので lim sup n P ( ∣ ( Y n − c ) X n ∣ > ε ) ≤ 2 η \limsup_nP(|(Y_n-c)X_n|>\varepsilon)\le2\eta lim sup n P ( ∣ ( Y n − c ) X n ∣ > ε ) ≤ 2 η η \eta η
次に c X n → d c X cX_n\xrightarrow{d}cX c X n d c X c = 0 c=0 c = 0 0 0 0 c > 0 c>0 c > 0 P ( c X n ≤ x ) = F n ( x / c ) P(cX_n\le x)=F_n(x/c) P ( c X n ≤ x ) = F n ( x / c ) x x x c X cX c X x / c ∈ C F x/c\in C_F x / c ∈ C F c < 0 c<0 c < 0 P ( c X n ≤ x ) = 1 − P ( X n < x / c ) P(cX_n\le x)=1-P(X_n<x/c) P ( c X n ≤ x ) = 1 − P ( X n < x / c ) y = x / c ∈ C F y=x/c\in C_F y = x / c ∈ C F F n ( y − ε ) ≤ P ( X n < y ) ≤ F n ( y ) F_n(y-\varepsilon)\le P(X_n<y)\le F_n(y) F n ( y − ε ) ≤ P ( X n < y ) ≤ F n ( y ) y − ε ∈ C F y-\varepsilon\in C_F y − ε ∈ C F P ( X n < y ) → F ( y ) = P ( X < y ) P(X_n<y)\to F(y)=P(X<y) P ( X n < y ) → F ( y ) = P ( X < y ) P ( c X ≤ x ) = 1 − P ( X < y ) P(cX\le x)=1-P(X<y) P ( c X ≤ x ) = 1 − P ( X < y )
最後に、すでに示した和の場合を「c X n → d c X cX_n\xrightarrow{d}cX c X n d c X ( Y n − c ) X n → P 0 (Y_n-c)X_n\xrightarrow{P}0 ( Y n − c ) X n P 0 X n Y n → d c X X_nY_n\xrightarrow{d}cX X n Y n d c X
商。 c ≠ 0 c\neq0 c = 0 Y n = 0 Y_n=0 Y n = 0 ω \omega ω X n / Y n X_n/Y_n X n / Y n 0 0 0 ε > 0 \varepsilon>0 ε > 0 δ ∈ ( 0 , ∣ c ∣ / 2 ) \delta\in(0,|c|/2) δ ∈ ( 0 , ∣ c ∣/2 ) ∣ y − c ∣ < δ ⇒ ∣ 1 / y − 1 / c ∣ < ε |y-c|<\delta\Rightarrow|1/y-1/c|<\varepsilon ∣ y − c ∣ < δ ⇒ ∣1/ y − 1/ c ∣ < ε P ( ∣ 1 / Y n − 1 / c ∣ ≥ ε ) ≤ P ( ∣ Y n − c ∣ ≥ δ ) → 0 P(|1/Y_n-1/c|\ge\varepsilon)\le P(|Y_n-c|\ge\delta)\to0 P ( ∣1/ Y n − 1/ c ∣ ≥ ε ) ≤ P ( ∣ Y n − c ∣ ≥ δ ) → 0 1 / Y n → P 1 / c 1/Y_n\xrightarrow{P}1/c 1/ Y n P 1/ c Y n = 0 Y_n=0 Y n = 0 { ∣ Y n − c ∣ ≥ δ } \{|Y_n-c|\ge\delta\} { ∣ Y n − c ∣ ≥ δ } X n X_n X n 1 / Y n 1/Y_n 1/ Y n X n / Y n → d X / c X_n/Y_n\xrightarrow{d}X/c X n / Y n d X / c
∎ 母平均 μ \mu μ 定理 5.6 より n ( X ˉ n − μ ) / σ → d N ( 0 , 1 ) \sqrt{n}(\bar{X}_n - \mu)/\sigma \xrightarrow{d} N(0,1) n ( X ˉ n − μ ) / σ d N ( 0 , 1 ) σ \sigma σ
σ ^ n = 1 n − 1 ∑ i = 1 n ( X i − X ˉ n ) 2 \hat{\sigma}_n = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(X_i - \bar{X}_n)^2} σ ^ n = n − 1 1 i = 1 ∑ n ( X i − X ˉ n ) 2 は E [ X 1 2 ] < ∞ E[X_1^2] < \infty E [ X 1 2 ] < ∞ 定理 4.5 から σ ^ n → a.s. σ \hat{\sigma}_n \xrightarrow{\text{a.s.}} \sigma σ ^ n a.s. σ σ / σ ^ n → P 1 \sigma/\hat{\sigma}_n \xrightarrow{P} 1 σ / σ ^ n P 1 命題 6.1 を X n = n ( X ˉ n − μ ) / σ X_n = \sqrt{n}(\bar{X}_n-\mu)/\sigma X n = n ( X ˉ n − μ ) / σ Y n = σ / σ ^ n Y_n = \sigma/\hat{\sigma}_n Y n = σ / σ ^ n
n ( X ˉ n − μ ) σ ^ n → d N ( 0 , 1 ) \frac{\sqrt{n}\,(\bar{X}_n - \mu)}{\hat{\sigma}_n} \xrightarrow{d} N(0,1) σ ^ n n ( X ˉ n − μ ) d N ( 0 , 1 ) を得ます。これを μ \mu μ 95 % 95\% 95% 信頼区間
[ X ˉ n − 1.96 σ ^ n n , X ˉ n + 1.96 σ ^ n n ] \left[\ \bar{X}_n - 1.96\frac{\hat{\sigma}_n}{\sqrt{n}},\quad \bar{X}_n + 1.96\frac{\hat{\sigma}_n}{\sqrt{n}}\ \right] [ X ˉ n − 1.96 n σ ^ n , X ˉ n + 1.96 n σ ^ n ] が出ます。1.96 1.96 1.96 Φ ( 1.96 ) − Φ ( − 1.96 ) = 0.95 \Phi(1.96) - \Phi(-1.96) = 0.95 Φ ( 1.96 ) − Φ ( − 1.96 ) = 0.95 σ ^ n / n \hat{\sigma}_n/\sqrt{n} σ ^ n / n 標準誤差 と呼びます。
例 6.3 (世論調査の標本サイズ )
支持率 p p p ± 3 % \pm 3\% ± 3% 95 % 95\% 95% X i X_i X i 0 0 0 1 1 1 σ 2 = p ( 1 − p ) ≤ 1 / 4 \sigma^2 = p(1-p) \le 1/4 σ 2 = p ( 1 − p ) ≤ 1/4
1.96 × p ( 1 − p ) n ≤ 0.03. 1.96 \times \frac{\sqrt{p(1-p)}}{\sqrt{n}} \le 0.03 . 1.96 × n p ( 1 − p ) ≤ 0.03. 最悪の場合 p = 1 / 2 p = 1/2 p = 1/2 p ( 1 − p ) = 0.5 \sqrt{p(1-p)} = 0.5 p ( 1 − p ) = 0.5 n ≥ 1.96 × 0.5 / 0.03 = 32.67 \sqrt{n} \ge 1.96 \times 0.5 / 0.03 = 32.67 n ≥ 1.96 × 0.5/0.03 = 32.67 n ≥ 1067.1 n \ge 1067.1 n ≥ 1067.1 n = 1068 n = 1068 n = 1068 1000 1000 1000
比較のため、命題 3.5 のチェビシェフの不等式だけで同じ保証を得るには
0.25 n × 0.03 2 ≤ 0.05 ⟺ n ≥ 0.25 0.0009 × 0.05 = 5555.6 , \frac{0.25}{n \times 0.03^2} \le 0.05 \iff n \ge \frac{0.25}{0.0009 \times 0.05} = 5555.6, n × 0.0 3 2 0.25 ≤ 0.05 ⟺ n ≥ 0.0009 × 0.05 0.25 = 5555.6 , つまり 5556 5556 5556 5 5 5
そして注目すべきは、必要な標本数が母集団の大きさに依存しない ことです。人口 1 1 1 1 1 1 1068 1068 1068 σ / n \sigma/\sqrt{n} σ / n
例 6.4 (モンテカルロ積分の精度 )
[ 0 , 1 ] 2 [0,1]^2 [ 0 , 1 ] 2 ( U i , V i ) (U_i, V_i) ( U i , V i ) n n n X i = 1 { U i 2 + V i 2 ≤ 1 } X_i = \mathbf{1}\{U_i^2 + V_i^2 \le 1\} X i = 1 { U i 2 + V i 2 ≤ 1 } E [ X 1 ] = π / 4 E[X_1] = \pi/4 E [ X 1 ] = π /4 π ^ n = 4 X ˉ n \hat{\pi}_n = 4\bar{X}_n π ^ n = 4 X ˉ n 定理 4.5 より π \pi π p = π / 4 ≈ 0.7854 p = \pi/4 \approx 0.7854 p = π /4 ≈ 0.7854
σ 2 = p ( 1 − p ) ≈ 0.7854 × 0.2146 ≈ 0.1686 , σ ≈ 0.4106. \sigma^2 = p(1-p) \approx 0.7854 \times 0.2146 \approx 0.1686, \qquad \sigma \approx 0.4106 . σ 2 = p ( 1 − p ) ≈ 0.7854 × 0.2146 ≈ 0.1686 , σ ≈ 0.4106. π ^ n \hat{\pi}_n π ^ n 4 σ / n ≈ 1.642 / n 4\sigma/\sqrt{n} \approx 1.642/\sqrt{n} 4 σ / n ≈ 1.642/ n n = 10 6 n = 10^6 n = 1 0 6 0.00164 0.00164 0.00164 100 100 100 π \pi π 3 3 3 5 5 5 100 100 100 1 1 1 n = 10 10 n = 10^{10} n = 1 0 10
rng = np.random. default_rng ( 0 )
u, v = rng. random ( n ), rng. random ( n )
x = (u ** 2 + v ** 2 <= 1.0 ). astype ( float )
se = 4 * x. std ( ddof = 1 ) / np. sqrt ( n )
print ( f "pi_hat = {pi_hat :.5f } , 95% CI = [ {pi_hat - 1.96 * se :.5f } , {pi_hat + 1.96 * se :.5f } ]" )
この 1 / n 1/\sqrt{n} 1/ n σ \sigma σ − 1 / 2 -1/2 − 1/2 定理 5.6 が決めています。
中心極限定理は「n n n
仮定 破れた場合に起きること E [ X 1 2 ] < ∞ E[X_1^2] < \infty E [ X 1 2 ] < ∞ 裾の重い分布(コーシー、指数 α < 2 \alpha < 2 α < 2 例 4.3 参照 独立性 相関が強いと有効標本サイズが減り、標準誤差 σ / n \sigma/\sqrt{n} σ / n 同分布 独立だが分布が異なる場合はリンドバーグ条件(どの 1 項も和を支配しないこと)が必要 収束の速さ 定理 5.9 より誤差は ρ / ( σ 3 n ) \rho/(\sigma^3\sqrt n) ρ / ( σ 3 n ) P ( Z n > 4 ) P(Z_n > 4) P ( Z n > 4 ) n n n
特に最後の行は実務で見落とされがちです。中心極限定理は分布の中心 の近似定理であり、極端な裾の確率を精密に与えるものではありません。裾には大偏差原理という別の理論があり、そちらは e − n I ( x ) e^{-nI(x)} e − n I ( x )
演習 7.1 易
(a) X n → L 2 X X_n \xrightarrow{L^2} X X n L 2 X X n → L 1 X X_n \xrightarrow{L^1} X X n L 1 X L 1 L^1 L 1 L 2 L^2 L 2
解答 (a) コーシー・シュワルツの不等式を ∣ X n − X ∣ |X_n - X| ∣ X n − X ∣ 1 1 1
E [ ∣ X n − X ∣ ] = E [ ∣ X n − X ∣ ⋅ 1 ] ≤ ( E [ ∣ X n − X ∣ 2 ] ) 1 / 2 ( E [ 1 2 ] ) 1 / 2 = ( E [ ∣ X n − X ∣ 2 ] ) 1 / 2 . E[|X_n - X|] = E[|X_n-X|\cdot 1] \le \left(E[|X_n-X|^2]\right)^{1/2}\left(E[1^2]\right)^{1/2} = \left(E[|X_n-X|^2]\right)^{1/2}. E [ ∣ X n − X ∣ ] = E [ ∣ X n − X ∣ ⋅ 1 ] ≤ ( E [ ∣ X n − X ∣ 2 ] ) 1/2 ( E [ 1 2 ] ) 1/2 = ( E [ ∣ X n − X ∣ 2 ] ) 1/2 . 右辺は仮定より 0 0 0 0 0 0 p ≤ q p \le q p ≤ q ∥ Y ∥ p ≤ ∥ Y ∥ q \|Y\|_p \le \|Y\|_q ∥ Y ∥ p ≤ ∥ Y ∥ q 1 1 1
(b) Ω = [ 0 , 1 ] \Omega = [0,1] Ω = [ 0 , 1 ] X n = n 1 ( 0 , 1 / n ) X_n = \sqrt{n}\,\mathbf{1}_{(0,1/n)} X n = n 1 ( 0 , 1/ n )
E [ ∣ X n ∣ ] = n ⋅ 1 n = 1 n → 0 , E [ ∣ X n ∣ 2 ] = n ⋅ 1 n = 1 ↛ 0. E[|X_n|] = \sqrt{n}\cdot\frac{1}{n} = \frac{1}{\sqrt{n}} \to 0, \qquad E[|X_n|^2] = n \cdot \frac{1}{n} = 1 \not\to 0 . E [ ∣ X n ∣ ] = n ⋅ n 1 = n 1 → 0 , E [ ∣ X n ∣ 2 ] = n ⋅ n 1 = 1 → 0. よって X n → L 1 0 X_n \xrightarrow{L^1} 0 X n L 1 0 L 2 L^2 L 2
演習 7.2 標準
ある工場の製品の重量 X X X μ \mu μ σ = 20 \sigma = 20 σ = 20 μ \mu μ ± 2 \pm 2 ± 2 99 % 99\% 99% n n n Φ ( 2.576 ) = 0.995 \Phi(2.576) = 0.995 Φ ( 2.576 ) = 0.995
解答 (a) 命題 3.5 より P ( ∣ X ˉ n − μ ∣ ≥ 2 ) ≤ σ 2 / ( n ⋅ 2 2 ) = 400 / ( 4 n ) = 100 / n P(|\bar{X}_n - \mu| \ge 2) \le \sigma^2/(n \cdot 2^2) = 400/(4n) = 100/n P ( ∣ X ˉ n − μ ∣ ≥ 2 ) ≤ σ 2 / ( n ⋅ 2 2 ) = 400/ ( 4 n ) = 100/ n 0.01 0.01 0.01 n ≥ 10,000 n \ge 10{,}000 n ≥ 10 , 000
(b) 定理 5.6 より X ˉ n ≈ N ( μ , σ 2 / n ) \bar{X}_n \approx N(\mu, \sigma^2/n) X ˉ n ≈ N ( μ , σ 2 / n ) 99 % 99\% 99%
2.576 × 20 n ≤ 2 ⟺ n ≥ 2.576 × 20 2 = 25.76 ⟺ n ≥ 663.6. 2.576 \times \frac{20}{\sqrt{n}} \le 2 \iff \sqrt{n} \ge \frac{2.576 \times 20}{2} = 25.76 \iff n \ge 663.6 . 2.576 × n 20 ≤ 2 ⟺ n ≥ 2 2.576 × 20 = 25.76 ⟺ n ≥ 663.6. よって n = 664 n = 664 n = 664 10,000 10{,}000 10 , 000 15 15 15 1 1 1
演習 7.3 標準
X 1 , X 2 , … X_1, X_2, \ldots X 1 , X 2 , … E [ X 1 ] = 0 E[X_1] = 0 E [ X 1 ] = 0 E [ X 1 2 ] = σ 2 < ∞ E[X_1^2] = \sigma^2 < \infty E [ X 1 2 ] = σ 2 < ∞ ε > 0 \varepsilon > 0 ε > 0 ( X ˉ n 2 ) n ∈ N (\bar{X}_{n^2})_{n \in \mathbb{N}} ( X ˉ n 2 ) n ∈ N X ˉ n 2 → a.s. 0 \bar{X}_{n^2} \xrightarrow{\text{a.s.}} 0 X ˉ n 2 a.s. 0
解答 A n = { ∣ X ˉ n 2 ∣ > ε } A_n = \{|\bar{X}_{n^2}| > \varepsilon\} A n = { ∣ X ˉ n 2 ∣ > ε } 命題 3.5 のチェビシェフの不等式と Var ( X ˉ m ) = σ 2 / m \operatorname{Var}(\bar{X}_m) = \sigma^2/m Var ( X ˉ m ) = σ 2 / m m = n 2 m = n^2 m = n 2
P ( A n ) ≤ σ 2 n 2 ε 2 . P(A_n) \le \frac{\sigma^2}{n^2 \varepsilon^2}. P ( A n ) ≤ n 2 ε 2 σ 2 . ∑ n ≥ 1 n − 2 = π 2 / 6 < ∞ \sum_{n \ge 1} n^{-2} = \pi^2/6 < \infty ∑ n ≥ 1 n − 2 = π 2 /6 < ∞ ∑ n P ( A n ) ≤ σ 2 π 2 / ( 6 ε 2 ) < ∞ \sum_n P(A_n) \le \sigma^2\pi^2/(6\varepsilon^2) < \infty ∑ n P ( A n ) ≤ σ 2 π 2 / ( 6 ε 2 ) < ∞ 補題 4.4 より確率 1 1 1 ∣ X ˉ n 2 ∣ > ε |\bar{X}_{n^2}| > \varepsilon ∣ X ˉ n 2 ∣ > ε n n n
これを ε = 1 / k \varepsilon = 1/k ε = 1/ k k ∈ N k \in \mathbb{N} k ∈ N N = ⋃ k N 1 / k N = \bigcup_k N_{1/k} N = ⋃ k N 1/ k P ( N ) = 0 P(N) = 0 P ( N ) = 0 ω ∉ N \omega \notin N ω ∈ / N X ˉ n 2 ( ω ) → 0 \bar{X}_{n^2}(\omega) \to 0 X ˉ n 2 ( ω ) → 0
補足: 一般の n n n n 2 ≤ m < ( n + 1 ) 2 n^2 \le m < (n+1)^2 n 2 ≤ m < ( n + 1 ) 2 X ˉ m \bar{X}_m X ˉ m X ˉ n 2 \bar{X}_{n^2} X ˉ n 2 命題 4.7 で 4 次モーメントを仮定して ∑ n P ( A n ) < ∞ \sum_n P(A_n) < \infty ∑ n P ( A n ) < ∞
演習 7.4 難
X 1 , X 2 , … X_1, X_2, \ldots X 1 , X 2 , … E [ X 1 ] = μ ≠ 0 E[X_1] = \mu \ne 0 E [ X 1 ] = μ = 0 Var ( X 1 ) = σ 2 ∈ ( 0 , ∞ ) \operatorname{Var}(X_1) = \sigma^2 \in (0,\infty) Var ( X 1 ) = σ 2 ∈ ( 0 , ∞ )
n ( X ˉ n 2 − μ 2 ) → d N ( 0 , 4 μ 2 σ 2 ) \sqrt{n}\left(\bar{X}_n^{\,2} - \mu^2\right) \xrightarrow{d} N\left(0,\ 4\mu^2\sigma^2\right) n ( X ˉ n 2 − μ 2 ) d N ( 0 , 4 μ 2 σ 2 ) を示してください(デルタ法の g ( x ) = x 2 g(x) = x^2 g ( x ) = x 2 定理 5.6 と命題 6.1 を使ってかまいません。
解答 因数分解します。
n ( X ˉ n 2 − μ 2 ) = n ( X ˉ n − μ ) ( X ˉ n + μ ) . \sqrt{n}\left(\bar{X}_n^{\,2} - \mu^2\right) = \sqrt{n}\left(\bar{X}_n - \mu\right)\left(\bar{X}_n + \mu\right). n ( X ˉ n 2 − μ 2 ) = n ( X ˉ n − μ ) ( X ˉ n + μ ) . 第 1 因子について、定理 5.6 より n ( X ˉ n − μ ) → d N ( 0 , σ 2 ) \sqrt{n}(\bar{X}_n - \mu) \xrightarrow{d} N(0, \sigma^2) n ( X ˉ n − μ ) d N ( 0 , σ 2 )
第 2 因子について、定理 4.1 (あるいは定理 4.5 と定理 3.6 (1))より X ˉ n → P μ \bar{X}_n \xrightarrow{P} \mu X ˉ n P μ X ˉ n + μ → P 2 μ \bar{X}_n + \mu \xrightarrow{P} 2\mu X ˉ n + μ P 2 μ 2 μ 2\mu 2 μ
命題 6.1 の積の部分(X n → d X X_n \xrightarrow{d} X X n d X Y n → P c Y_n \xrightarrow{P} c Y n P c X n Y n → d c X X_nY_n \xrightarrow{d} cX X n Y n d c X X n = n ( X ˉ n − μ ) X_n = \sqrt n(\bar X_n - \mu) X n = n ( X ˉ n − μ ) Y n = X ˉ n + μ Y_n = \bar X_n + \mu Y n = X ˉ n + μ c = 2 μ c = 2\mu c = 2 μ
n ( X ˉ n 2 − μ 2 ) → d 2 μ ⋅ N ( 0 , σ 2 ) . \sqrt{n}\left(\bar{X}_n^{\,2} - \mu^2\right) \xrightarrow{d} 2\mu \cdot N(0,\sigma^2). n ( X ˉ n 2 − μ 2 ) d 2 μ ⋅ N ( 0 , σ 2 ) . W ∼ N ( 0 , σ 2 ) W \sim N(0,\sigma^2) W ∼ N ( 0 , σ 2 ) 2 μ W 2\mu W 2 μ W 0 0 0 ( 2 μ ) 2 σ 2 = 4 μ 2 σ 2 (2\mu)^2\sigma^2 = 4\mu^2\sigma^2 ( 2 μ ) 2 σ 2 = 4 μ 2 σ 2
なお 4 μ 2 σ 2 = ( g ′ ( μ ) ) 2 σ 2 4\mu^2\sigma^2 = \left(g'(\mu)\right)^2\sigma^2 4 μ 2 σ 2 = ( g ′ ( μ ) ) 2 σ 2 g ( x ) = x 2 g(x)=x^2 g ( x ) = x 2 g ′ ( x ) = 2 x g'(x) = 2x g ′ ( x ) = 2 x
n ( g ( X ˉ n ) − g ( μ ) ) → d N ( 0 , ( g ′ ( μ ) ) 2 σ 2 ) ( g は μ で微分可能 ) \sqrt{n}\left(g(\bar X_n) - g(\mu)\right) \xrightarrow{d} N\left(0, (g'(\mu))^2\sigma^2\right) \quad (g \text{ は } \mu \text{ で微分可能}) n ( g ( X ˉ n ) − g ( μ ) ) d N ( 0 , ( g ′ ( μ ) ) 2 σ 2 ) ( g は μ で微分可能 ) と整合しています。μ = 0 \mu = 0 μ = 0 g ′ ( μ ) = 0 g'(\mu) = 0 g ′ ( μ ) = 0 0 0 0 μ ≠ 0 \mu \ne 0 μ = 0
伊藤清『確率論』岩波書店、1991 — 第 3 章(大数の法則)、第 4 章(中心極限定理)。
舟木直久『確率論』朝倉書店、2004 — 第 5 章から第 7 章にかけて、収束概念・大数の法則・中心極限定理が体系的に扱われています。
R. Durrett, Probability: Theory and Examples , 5th ed., Cambridge University Press, 2019 — 第 2 章(大数の法則、ボレル・カンテリの補題)、第 3 章(中心極限定理、特性関数、リンドバーグ条件)。著者サイトで PDF が公開されています。
P. Billingsley, Probability and Measure , 3rd ed., Wiley, 1995 — 第 22 節(強法則)、第 26–27 節(特性関数とレヴィの連続性定理)。
W. Feller, An Introduction to Probability Theory and Its Applications , Vol. II, 2nd ed., Wiley, 1971 — 第 XVI 章にベリー・エセーンの定理と正規近似の誤差評価。
A. W. van der Vaart, Asymptotic Statistics , Cambridge University Press, 1998 — 第 2 章(確率的収束、スルツキーの定理、デルタ法)。統計への応用を重視する読者向け。
独立同分布を外す。 定理 5.6 は同分布を仮定していますが、実際には各項が和全体を支配しないことだけが本質です。独立だが分布が異なる X n , 1 , … , X n , n X_{n,1},\ldots,X_{n,n} X n , 1 , … , X n , n 0 0 0 s n 2 s_n^2 s n 2 ε > 0 \varepsilon>0 ε > 0
1 s n 2 ∑ i = 1 n E [ X n , i 2 1 { ∣ X n , i ∣ > ε s n } ] → 0 \frac{1}{s_n^2}\sum_{i=1}^{n} E\left[X_{n,i}^2\,\mathbf{1}\{|X_{n,i}| > \varepsilon s_n\}\right] \to 0 s n 2 1 i = 1 ∑ n E [ X n , i 2 1 { ∣ X n , i ∣ > ε s n } ] → 0 が成り立つ(リンドバーグ条件 )ならば s n − 1 ∑ i X n , i → d N ( 0 , 1 ) s_n^{-1}\sum_i X_{n,i} \xrightarrow{d} N(0,1) s n − 1 ∑ i X n , i d N ( 0 , 1 ) 定理 5.6 はその系になります。
独立性を外す。 独立性の代わりにマルチンゲール差列であることを仮定しても中心極限定理が成り立ちます(マルチンゲール中心極限定理)。時系列解析や確率的アルゴリズムの解析では、独立性は望めない一方で「過去の情報のもとでの条件付き期待値が 0 0 0 条件付き期待値 (定義 3.1[条件付き期待値] )で、マルチンゲールそのものはマルチンゲールとブラウン運動 (定義 3.1[マルチンゲールとブラウン運動] )で扱います。
極限を過程に格上げする。 定理 5.6 は「時刻 n n n t ∈ [ 0 , 1 ] t \in [0,1] t ∈ [ 0 , 1 ]
W n ( t ) = S ⌊ n t ⌋ − ⌊ n t ⌋ μ σ n W_n(t) = \frac{S_{\lfloor nt \rfloor} - \lfloor nt\rfloor \mu}{\sigma\sqrt{n}} W n ( t ) = σ n S ⌊ n t ⌋ − ⌊ n t ⌋ μ に格上げすると、この確率過程がブラウン運動(定義 5.1)[マルチンゲールとブラウン運動] に分布収束する、というドンスカーの不変原理が得られます。中心極限定理が「正規分布の普遍性」を語るのに対し、不変原理は「ブラウン運動の普遍性」を語ります。ここから先が確率解析の入り口で、確率微分方程式(伊藤積分) へ続きます。
裾を見る。 最後に、P ( X ˉ n − μ > x ) P(\bar X_n - \mu > x) P ( X ˉ n − μ > x ) x > 0 x > 0 x > 0 0 0 0 O ( 1 / n ) O(1/\sqrt n) O ( 1/ n ) 1 n log P ( X ˉ n − μ > x ) → − I ( x ) \frac{1}{n}\log P(\bar X_n - \mu > x) \to -I(x) n 1 log P ( X ˉ n − μ > x ) → − I ( x ) I I I 0 0 0 n \sqrt n n n n n
執筆: Claude Code(Opus 5.5)、Claude Code(Sonnet 5.5)・監査 5 回(Claude Code)・最終 2026-10-12