クラウドコンピューティング:オンプレミスとの分岐点を数式で見る
対象読者: 確率の初歩(独立事象の積)と指数・分数を使った計算ができ、サーバやデータベースの基本的な役割を知っている人。本テーマ前章までの内容を前提にし、クラウドの経験は仮定しません。
前提となる記事:データベース設計の基礎:関係モデル・SQL・正規化を「事実の置き場所」から考える
0. この記事の要点
Section titled “0. この記事の要点”動画を見たりアプリを使ったりするとき、その裏で動いているサーバーを、会社が自前で買って持つのではなく、使った分だけ借りる仕組みがクラウドです。この記事では、「借りるのと買うのではどちらが得か」「台数を増やすとどれだけ速くなるか」「サーバーが壊れても止まらないようにするには、どう並べればよいか」という素朴な疑問に、簡単な計算で答えます。読み終えると、クラウドを使うかどうかや必要な台数の見積もりを、数字を使って説明できるようになります。
- クラウドとは「計算資源をセルフサービスで即時に借り、使った分だけ計量課金される仕組み」です。IaaS・PaaS・SaaS の違いは機能の違いではなく、利用者と事業者のどちらが何を運用するかという責任分界の違いです。
- 従量課金が有利かどうかは、平均利用率 が損益分岐利用率 を下回るかで決まります(損益分岐利用率とは、自前で持つ場合とクラウドで借りる場合の費用がちょうど等しくなる利用率のことです)。後で示すように は所有コストとオンデマンド単価の比で書けて、実務的な数値では 前後になります。
- スケールアウトの効果は線形ではありません。待ち行列モデル(窓口に並ぶ客の列を数式で扱う考え方)では応答時間が となり、飽和に近いほど台数追加の効き目が大きく、余裕があるほど小さくなります。
- 一方で並列化には上限があります。直列部分と協調コストを含む拡張則では、スループットは台数 について最大値を持ち、それを超えると増やすほど遅くなります。
- 冗長化した系の可用性は並列部分で 、直列部分で になります。系全体の可用性は最も弱い直列要素に支配されるため、アプリだけ三重化してもデータベースが単一なら意味がありません。
- マネージドサービスは運用を事業者に移譲する代わりに、移行コスト(データ重力・下り転送料金)という形でロックインを生みます。これは技術的欠陥ではなく、明示的に評価すべきコスト項目です。
1. 動機:なぜ計算機を「借りる」のか
Section titled “1. 動機:なぜ計算機を「借りる」のか”1961 年、MIT の記念講演で John McCarthy は、計算機が将来「電話のように、公益事業(ユーティリティ)として組織される」だろうと述べました。電力を自家発電せず電力会社から買うように、計算能力も買う対象になる、という予測です。当時の時分割システム(TSS)は 1 台の高価な計算機を多人数で分け合う技術であり、その発想の延長線上にありました。
この予測が現実の商用サービスとして立ち上がったのは 2006 年です。Amazon がオブジェクトストレージ S3 と仮想マシンサービス EC2 を公開し、クレジットカード 1 枚で、申請も見積もりもなく、数分で仮想サーバーが起動する状態が生まれました。Google App Engine(2008)、Microsoft Azure(2010 一般提供)、Google Compute Engine(2013)が続きます。
素朴な疑問から始めましょう。自分でサーバーを買って置く(オンプレミス)のと、借りるのと、どちらが得なのでしょうか。
「借りるほうが高いに決まっている、間に事業者の利益が乗るのだから」というのは、半分だけ正しい議論です。単価だけを比べればそのとおりです。しかし所有には、単価に現れない次の性質があります。
- 稼働していなくても費用が発生する。 サーバーは買った瞬間から減価償却が始まり、ラック代も電力も保守契約も、CPU 使用率が 3% でも 100% でも変わりません。
- 調達に時間がかかる。 見積もり、発注、納品、ラッキング、OS 導入までに数週間から数か月を要します。需要が読めない段階では、この待ち時間そのものが損失です。
- 需要のピークに合わせて買わざるを得ない。 平常時の 10 倍の負荷が年 2 回来るなら、その 10 倍に耐える設備を 1 年中維持することになります。
クラウドが変えたのは、この 3 点です。稼働時間に比例した課金、数分での調達、負荷に応じた台数の増減。要するにクラウドは、設備投資(CapEx)を運用費(OpEx)に変換し、需要の不確実性に対する保険を買う仕組みです(CapEx は機材を買うときにまとめて払う初期投資、OpEx は使った分を日々払う運用の費用のことです)。保険料が妥当かどうかは、状況によって変わります。この章では、その判断を感覚ではなく計算で行うための道具を揃えます。
この章はデータベース設計の知識を前提にします。マネージドデータベースの選択(データベース設計の基礎、とくに 関係スキーマと関係(定義 2.1)[データベース設計の基礎])と、コンテナ実行基盤(仮想化技術(Docker・Kubernetes)、とくに コンテナ(定義 3.1)[Docker と Kubernetes] の定義)は、以降で繰り返し登場します。
2. 準備:クラウドとは何か、サービスモデルとは何か
Section titled “2. 準備:クラウドとは何か、サービスモデルとは何か”「クラウド」という語は広告で濫用されましたが、技術的には米国国立標準技術研究所(NIST)による定義が事実上の標準です。
定義 2.1(クラウドコンピューティング(NIST SP 800-145))↗
構成可能な計算資源(ネットワーク、サーバー、ストレージ、アプリケーション、サービス)の共有プールに対して、どこからでもオンデマンドにネットワーク経由でアクセスでき、最小限の管理作業または事業者とのやり取りで迅速に割り当て・解放できるモデルをクラウドコンピューティングと呼ぶ。次の 5 つの本質的特徴をすべて備える。
- オンデマンド・セルフサービス:利用者が人手の介在なしに資源を確保できる。
- 広範なネットワークアクセス:標準的な機構でネットワーク越しに利用できる。
- 資源のプール化:複数利用者に資源が動的に割り当てられ、物理的な位置は原則として利用者から抽象化される。
- 迅速な弾力性:需要に応じて資源を迅速に、しばしば自動的に増減できる。
- 計量されたサービス:利用量が計測され、その計測に基づいて課金・報告される。
5 つのうち 1 つでも欠ければ、それは「ホスティング」であってクラウドではありません。たとえば増設に営業への連絡が必要なら特徴 1 と 4 を欠き、月額固定で使用量に関係なく請求されるなら特徴 5 を欠きます。
定義 2.2(サービスモデル(IaaS・PaaS・SaaS))↗
利用者が管理する層の深さによって、クラウドサービスを次の 3 つに分類する。
- IaaS(Infrastructure as a Service):事業者は物理設備・仮想化基盤・ネットワークまでを運用し、利用者は OS 以上(OS、ミドルウェア、ランタイム、アプリケーション、データ)を運用する。例:仮想マシン、ブロックストレージ、仮想ネットワーク。
- PaaS(Platform as a Service):事業者は OS・ミドルウェア・ランタイムまでを運用し、利用者はアプリケーションとデータのみを運用する。例:マネージドデータベース、アプリケーション実行環境、関数実行基盤。
- SaaS(Software as a Service):事業者はアプリケーションまでを運用し、利用者は自分のデータと設定のみを管理する。例:メール、グループウェア、CRM。
この分類で重要なのは、移譲されるのは作業であって責任ではないという点です。IaaS の仮想マシンで OS のセキュリティ更新を怠れば、侵害の責任は利用者にあります。PaaS のマネージドデータベースでも、権限設計とバックアップ世代の設定は利用者の責任です。事業者が担うのは「クラウドのセキュリティ」、利用者が担うのは「クラウドにおけるセキュリティ」という言い方がよく使われ、これを責任共有モデルと呼びます。
3. オンプレミスとクラウドの経済学
Section titled “3. オンプレミスとクラウドの経済学”議論を数式に載せます。ある一定のワークロードが、能力の等しい 1 台分の計算機を必要とするとします。
評価期間の長さを (時間)とする。ワークロードが計算機を実際に必要とする時間の合計を とし、
を平均利用率と呼ぶ。オンプレミスで同等の計算機を保有・運用するために期間 全体で要する総費用を (円)、クラウドの同等インスタンスのオンデマンド単価を (円/時間)とする。両者の総費用が一致する利用率
を損益分岐利用率と呼ぶ。
上の記号のもとで、オンプレミスの総費用は に依存せず に等しく、クラウドの総費用は に等しいとする。さらに 、 とする。このとき
が成り立つ。すなわち平均利用率が損益分岐利用率を下回るときに限り、クラウドの総費用が小さい。また ならば、どのような に対してもクラウドが有利( のときは同額以下)である。
証明(命題 3.2)
かつ より なので、不等式 の両辺を正の数 で割っても向きは変わらず、 を得ます。逆向きも同じ変形で従います。
後半を示します。 とすると、任意の について です。 のときは前半よりクラウドが厳密に安く、(したがって )のときは で同額です。以上より総費用はつねに 以下になります。
この命題は自明に見えますが、比較の土俵を固定した点に意味があります。オンプレミス側の費用は に依存しないという仮定が、所有と従量課金の本質的な非対称性です。
例 3.3(損益分岐利用率を実際に計算する)
数値はすべて説明のための仮定値です(実際の価格は事業者・リージョン・時期で変動します)。8 vCPU・32 GB 相当の計算機を 3 年間使うとします。
- 本体購入費:60 万円(3 年で償却)
- 設置・電力・保守・ネットワーク:年 12 万円 × 3 年 = 36 万円
したがって 万円です。期間は
なので、所有コストは 1 時間あたり 円になります。同等スペックのクラウド仮想マシンのオンデマンド単価を 円/時間と仮定すると、命題 3.2 より
です。つまり平均して 1 日 8 時間()より短く使うワークロードなら、クラウドのほうが安いという結論になります。開発環境、バッチ処理、検証用クラスタはこの範囲に入ることが多く、24 時間走り続ける本番データベースは入りません。
3 年コミットの割引(仮に 45% 引き、 円/時間)を適用すると
となり、分岐点は まで上がります。常時稼働に近いワークロードほど、オンデマンドではなくコミット型の購入方式を選ぶべきことが数値で確認できます。
上の例の数値( 万円、オンデマンド単価 円/時間)を図にすると、次のようになります。オンプレミスの費用は利用率によらない水平線、クラウドの費用は原点から右上がりの直線で、2 本が交わる点の横座標が損益分岐利用率です。
このモデルは 3 つの費目を無視しています。第一に人件費です。オンプレミスにはハードウェア保守・ファームウェア更新・故障対応の工数が伴い、これを に含めると は上がります。第二に調達リードタイムの価値です。需要が読めない段階で数か月待つ損失は に現れません。第三に下り転送料金(egress)で、クラウドから外部へ大量のデータを出す用途では に無視できない額が加算されます。動画配信や科学データ配布のように出力が支配的なワークロードで、オンプレミス回帰の判断が出ることがあるのはこのためです。
4. 三大クラウドの主要サービスの対応
Section titled “4. 三大クラウドの主要サービスの対応”AWS・GCP・Azure は、名前は違っても中核サービスの構成はほぼ対応します。設計を移す際は、この対応表を出発点にして差分だけを検討するのが効率的です。
| 機能カテゴリ | AWS | Google Cloud | Microsoft Azure |
|---|---|---|---|
| 仮想マシン(IaaS) | EC2 | Compute Engine | Virtual Machines |
| オブジェクトストレージ | S3 | Cloud Storage | Blob Storage |
| ブロックストレージ | EBS | Persistent Disk | Managed Disks |
| マネージド RDB | RDS / Aurora | Cloud SQL / AlloyDB | Azure Database for PostgreSQL |
| マネージド NoSQL | DynamoDB | Firestore / Bigtable | Cosmos DB |
| データウェアハウス | Redshift | BigQuery | Synapse Analytics / Microsoft Fabric |
| 関数実行(FaaS) | Lambda | Cloud Run functions | Azure Functions |
| コンテナ基盤 | ECS / EKS | GKE | AKS |
| 仮想ネットワーク | VPC | VPC | Virtual Network |
| 負荷分散 | ELB(ALB / NLB) | Cloud Load Balancing | Load Balancer / Application Gateway |
| 権限管理 | IAM | Cloud IAM | Microsoft Entra ID + RBAC |
| 監視・ログ | CloudWatch | Cloud Monitoring / Logging | Azure Monitor |
| IaC(純正) | CloudFormation | Infrastructure Manager(Terraform ベース。旧 Deployment Manager は 2025 年末でサポート終了) | ARM テンプレート / Bicep |
対応表から漏れる差分のうち、設計判断に効くものを挙げます。
- ネットワークの粒度:AWS の VPC はリージョン単位で、サブネットがアベイラビリティゾーン(AZ。同じ地域の中で電源やネットワークを分けた、独立性の高い設備群のこと)に属します。Google Cloud の VPC はグローバル資源で、サブネットがリージョンに属します。この違いはマルチリージョン構成の設計に直接影響します。詳しくは ネットワーク(TCP/IP) の内容が前提になります。サブネットをプレフィックス長で切り分ける操作そのものは IPv4 アドレスと CIDR プレフィックス(定義 4.1)[ネットワーク(TCP/IP)] にあります。
- オブジェクトストレージの整合性:現在はいずれの事業者も書き込み後の読み取り一貫性を提供しますが、一覧取得(list)の反映やバージョニングの挙動には差があります。
- データウェアハウスの課金軸:BigQuery はオンデマンド課金ではスキャンしたバイト数に応じて課金され(スロット予約による定額型もあります)、Redshift は従来のクラスタ(時間)課金が基本です(従量型の Serverless もあります)。同じ SQL でも費用構造が変わります。
例 4.1(3 層 Web アプリケーションを 3 社で構成する)
「ロードバランサ → アプリサーバー群 → リレーショナルデータベース、静的ファイルはオブジェクトストレージ」という典型構成を、各社のサービス名で書き下します。
| 層 | AWS | Google Cloud | Azure |
|---|---|---|---|
| DNS | Route 53 | Cloud DNS | Azure DNS |
| 負荷分散 | ALB | Cloud Load Balancing | Application Gateway |
| アプリ | EC2 Auto Scaling group または EKS | Managed Instance Group または GKE | Virtual Machine Scale Sets または AKS |
| データベース | RDS for PostgreSQL(Multi-AZ) | Cloud SQL for PostgreSQL(HA 構成) | Azure Database for PostgreSQL(ゾーン冗長) |
| 静的配信 | S3 + CloudFront | Cloud Storage + Cloud CDN | Blob Storage + Azure Front Door |
| 秘密情報 | Secrets Manager | Secret Manager | Key Vault |
どの社でも構成要素の役割は同じで、変わるのは名前と、ネットワーク資源の階層(リージョン/ゾーン)の切り方です。アプリ層をコンテナで組んでおけば移植の主たる作業はネットワークと権限の再定義に限られます。
5. スケーラビリティの数理
Section titled “5. スケーラビリティの数理”「クラウドはスケールする」という宣伝文句を、定量的な主張に翻訳します。まず待ち行列の基本定理から始めます。
次のリトルの法則は、「平均して何人が系の中にいるか」を「1 秒あたりの到着人数」と「1 人あたりの滞在時間」の積で表す関係です。たとえば毎秒 2 人が到着し、平均 3 秒滞在するなら、平均して 人が系にいる、という計算になります。仮定にある「系が空になる時刻」は、そこで区切ると全員の出入りが完結して数え漏れが出ないための条件で、証明では「系内客数の時間積分」を客ごとの滞在時間の合計と 2 通りに数えて等置します。
系は時刻 で空であるとする。時刻 までの到着数を 、退去数を 、系内客数を とし、 番目の客の系内滞在時間を とする。次の 3 条件を仮定する。
- 系が空になる時刻の列 で となるものが存在する(各 で )。
- 極限 が存在し、 である。
- 極限 が存在し、有限である。
このとき平均系内客数
が存在して、 が成り立つ。
証明(定理 5.1)
固定した について、区間 での面積を 2 通りに数えます。
番目の客の到着時刻を 、退去時刻を とすると、この客は時刻 が を満たすときちょうど 1 だけ に寄与します。すなわち です。仮定 1 より時刻 で系は空なので、 までに到着した 人の客はすべて までに退去しており、 が成り立ちます。よって積分と有限和を交換して
を得ます。両辺を で割り、右辺を で調整すると
です。仮定 2 より右辺第 1 因子は に、仮定 3 より第 2 因子は に収束します。収束する 2 つの数列の積は極限の積に収束するので、左辺も収束して極限は に等しくなります。これが です。
リトルの法則は分布についてまったく仮定を置いていません。到着がポアソンでなくても、サービス時間がどんな分布でも成り立ちます。この一般性のため、容量計画では最初に持ち出す道具になります。次に、分布を特定した場合の応答時間を求めます。次の命題のねらいは、サーバー 1 台の利用率 から平均応答時間を具体的な式で求めることです。証明は、客数の平均 を等比級数で計算し、リトルの法則で応答時間 に直す流れです。定常分布そのものの導出は、本筋を妨げないよう Appendix に置いています。
到着が強度 のポアソン過程に従い、サービス時間が平均 ()の指数分布に独立に従い、サーバーは 1 台、待ち行列の長さに上限はなく、規律は先着順であるとする。利用率を とし、 を仮定する。このとき定常状態が存在して、系内客数が である確率は
であり、平均系内客数と平均応答時間はそれぞれ
で与えられる。
証明(命題 5.2)
は、 が に近づくと発散します。これが容量計画で「利用率 70% を超えたら増設」と言われる理由です。 の関数として を描くと、次のように急峻な立ち上がり(ホッケースティック)になります。
命題 5.2 と同じ仮定のもとで、到着した客を確率 ずつ独立に 台のサーバーへ振り分け、各サーバーが独立な M/M/1 として動作するとする。各サーバーのサービス率は のままとし、 を仮定する。このとき系全体の平均応答時間は
であり、 のとき に単調減少する。
証明(系 5.3)
ポアソン過程を確率 で独立に間引くと強度 のポアソン過程になります(ポアソン過程の分解定理)。したがって各サーバーは到着率 、サービス率 の M/M/1 であり、仮定 よりその利用率は 未満です。命題 5.2 を適用すると 1 台あたりの平均応答時間は です。客はどのサーバーに振り分けられても同じ分布の応答時間を持つので、全体の平均も同じ値になります。
単調性は、 が増えると が減り、 が増えるためです。分母が増えるので は減少し、 より となります。
ここに重要な含意があります。 は 1 件を処理するのに必要な時間そのもの(サービス時間)なので、どれだけ台数を増やしても応答時間は より速くならないのです。台数追加が縮められるのは待ち時間だけです。応答時間をさらに縮めたければ、 そのものを大きくする(アルゴリズム改善、索引追加、キャッシュ導入)しかありません。
例 5.4(オートスケールの台数を見積もる)
API サーバー 1 台のサービス率が 件/秒、到着率が 件/秒とします。1 台のときの利用率は で、命題 5.2 より
です。サービス時間そのものは ミリ秒ですから、40 ミリ秒は待ち時間です。系 5.3 で台数を増やすと
となります。1 台から 2 台への改善は 33 ミリ秒、2 台から 4 台への改善は 4.2 ミリ秒しかありません。
平均応答時間 20 ミリ秒以下という目標を置くなら、必要な台数は
より 台です。 は整数なので切り上げます。オートスケールの下限台数をこの計算から決め、上限はこの後の拡張則から決めるのが定石です。Kubernetes の HorizontalPodAutoscaler が実際に台数を決める式は HorizontalPodAutoscaler の一段収束(命題 7.4)[Docker と Kubernetes] にあります。
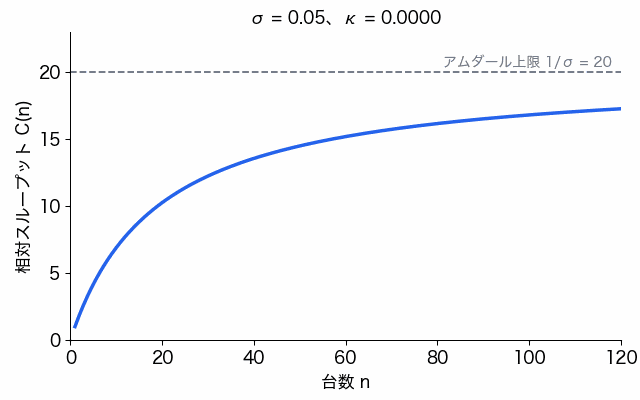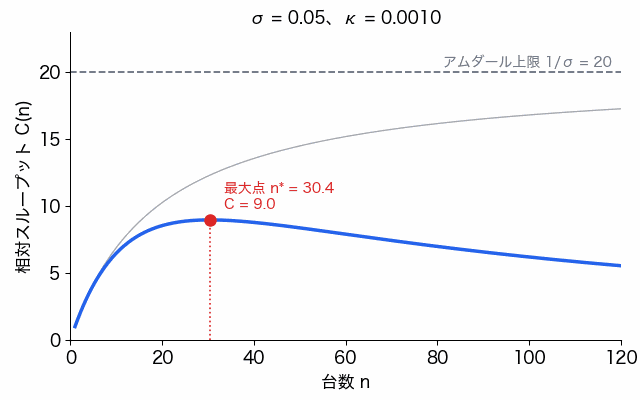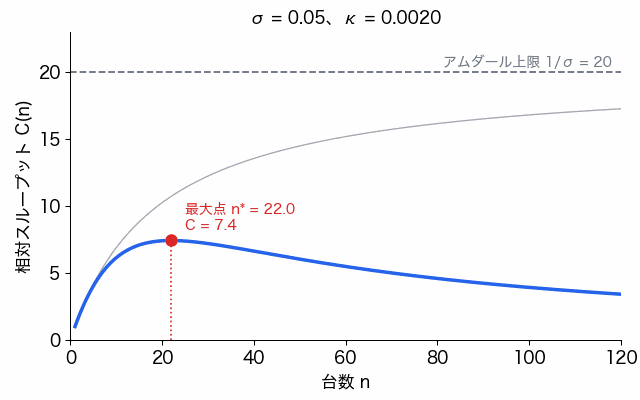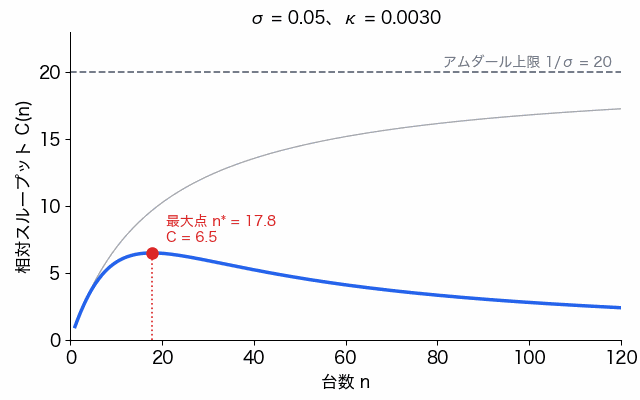
台数を増やしても性能が台数に比例して伸びないのは、並列化できない仕事が残ることと、台数が増えるほどサーバー同士のやり取りが増えることの 2 つが原因です。次の式では、分母の が前者を、 が後者を表します。証明の方針は、 を微分して増加から減少に変わる点を探すことです。
台数 における相対スループット(1 台のときを とする)が
で与えられるとする。ここで は直列(並列化できない)部分の割合、 は台数間の整合コスト(データの同期・調停)の係数で とする。 のとき、 を の実数に拡張して考えると、 は
でただ 1 つの最大値をとる(仮定 より である)。とくに では台数を増やすほどスループットが下がる。また のときは は で単調増加で、さらに ならば (アムダールの法則の上限)となる( かつ のときは で上限を持たない)。
証明(命題 5.5)
分母を と置きます。まず を確かめます。 のとき かつ なので です。 を考えるのはこの範囲(台数は 1 以上)なので、以下 とします。
商の微分法により
です。分子を計算すると
となり、 の 1 次の項が打ち消し合います。 よりこれは について狭義単調減少で、 の範囲でちょうど 1 点
で になります。 では分子が正なので 、 では負なので です。したがって は で最大値をとり、それ以降は減少します。
の場合は で、上の分子は となり 、すなわち単調増加です。さらに とすると、極限は
です(分子分母を で割りました)。 のときは となり、極限は有限ではありません。
例 5.6(どこまで増やせるかを数値で出す)
負荷試験の結果を上式に当てはめて 、 が得られたとします。命題 5.5 より最大点は
なので、整数では 31 台です。そのときのスループットは
倍にとどまります。一方、整合コストを無視した のアムダール上限は 倍です。整合コストがわずか あるだけで、到達可能な最大スループットは上限の半分以下に落ちます。
さらに 60 台まで増やすと
で、31 台のときより下がります。オートスケールの上限台数を設定しないと、負荷スパイク時にこの領域へ突入し、費用を払って性能を落とすことになります。
を固定して を 0 から増やすと、曲線の山がどう動くかを見てみましょう。灰色の細線は の曲線、赤い点が最大点です。
6. 可用性と冗長化
Section titled “6. 可用性と冗長化”クラウドの SLA は「99.99%」のような数値で示されます。この数値が構成によってどう合成されるかを確認します。
| 可用性 | 年間の許容停止時間 |
|---|---|
| 99% | 87.6 時間(3.65 日) |
| 99.9% | 8.76 時間 |
| 99.99% | 52.6 分 |
| 99.999% | 5.26 分 |
構成要素 の可用性をそれぞれ とし、各要素の故障事象は互いに独立であるとする。
- 直列構成(すべての要素が正常でなければ系が動かない)の可用性は である。とくに が成り立つ。
- 並列構成(少なくとも 1 つの要素が正常なら系が動く)の可用性は である。とくに が成り立つ。
証明(命題 6.2)
要素 が正常である事象を とし、 とします。独立性より、任意の部分集合について事象の積の確率は確率の積に等しいことを使います。
-
直列構成が正常である事象は です。独立性より です。各 なので、任意の について が成り立ちます。 は任意なので です。
-
並列構成が停止している事象は「すべての要素が停止している」、すなわち です。補事象の独立性より なので、正常である確率はその補で です。任意の について (他の因子が 以下だから)なので、 となり、 を動かして を得ます。
命題 1 の が実務上いちばん重要です。**系全体の可用性は、直列に並んだ要素のうち最も弱いものを超えられません。**なお 2 の並列構成を、可用性の等しい同一構成のレプリカに特化したものが 独立故障の下での冗長化(定理 7.1)[Docker と Kubernetes] です。
例 6.3(マルチ AZ 構成の可用性を計算する)
ロードバランサ、アプリサーバー 3 台、データベース 1 台からなる系を考えます。ロードバランサはマネージドサービスで 、アプリサーバーは 1 台あたり で 3 つの AZ に 1 台ずつ配置し故障は独立、データベースは単一 AZ で とします。
アプリ層は並列構成なので 命題 6.2 の 2 より
です。系全体はロードバランサ、アプリ層、データベースの直列なので、同命題の 1 より
となり、年間停止時間は 時間です。アプリ層を三重化して まで上げたのに、全体は にとどまりました。
原因は明らかで、直列に入っているデータベースの が全体を抑えています。データベースをゾーン冗長構成にして に改善すると
となり、年間停止時間は 時間に短縮されます。アプリを 3 台から 10 台に増やしても効果はほぼゼロですが、データベースを冗長化すると停止時間は 3 分の 1 になります。投資すべき場所は、可用性の積のうち最も小さい因子です。
7. マネージドサービス、ロックイン、そして何を選ぶか
Section titled “7. マネージドサービス、ロックイン、そして何を選ぶか”クラウドの価値の多くは、仮想マシンそのものではなくマネージドサービスにあります。マネージドデータベースを使えば、バックアップ、フェイルオーバー、マイナーバージョン更新、パッチ適用が事業者の運用に移ります。命題 6.2 の観点では、直列要素の を人手ではなく事業者の運用品質で引き上げることに相当します。
その代償がロックインです。ロックインは次の 3 段階に分けて考えると判断しやすくなります。
| 段階 | 内容 | 移行コストの目安 |
|---|---|---|
| 弱い | 標準実装のマネージド提供(PostgreSQL、Redis、Kafka 互換) | 低い。同じ製品を別環境で動かせる |
| 中程度 | 独自 API だが概念が共通(オブジェクトストレージ、FaaS) | 中。抽象化層を挟めば吸収できる |
| 強い | 独自データモデル・独自クエリ言語(一部の NoSQL・DWH) | 高い。データモデルごと再設計になる |
これに加えて、どの段階でも効いてくるのがデータ重力です。蓄積したデータが大きいほど、下り転送料金と移行に要する時間が移行を妨げます。100 TB を下り 10 円/GB で外部へ出すと 万円の転送料金が発生し、これは移行の意思決定に直接効きます。
実務での選択方針を述べます。これは判断を含むので、私の推奨として書きます。
- 状態を持たない層は移植性を高く保つのがよいでしょう。コンテナ化しておけば、実行基盤の差は吸収できます(仮想化技術(Docker・Kubernetes)、移植の単位になるのは イメージとレイヤ(定義 4.1)[Docker と Kubernetes] です)。
- 状態を持つ層は素直にマネージドに寄せるのがよいと思います。データベースの高可用構成を自前で正しく組み運用する工数は、ロックインの費用より高くつくことが多いためです。
- 構成はコードで管理する(IaC)。手作業で作った資源は再現できず、災害復旧の演習ができません。構成ファイルはアプリケーションと同じくバージョン管理下に置きます(バージョン管理システム(Git))。どの構成が本番に出ているかをコミット 1 個のハッシュで一意に指せることは、ハッシュによる履歴全体の同定(定理 3.3)[バージョン管理システム Git] が保証しています。
- 費用は設計段階で見積もる。 命題 3.2 の 、例 5.4 の台数、下り転送量の 3 つを設計レビューの項目に入れておくと、運用開始後の請求書で驚かずに済みます。
次の 4 つのサービス利用形態を IaaS・PaaS・SaaS に分類し、OS のセキュリティパッチ適用の責任が利用者と事業者のどちらにあるかを述べてください。
(a) 仮想マシンを借りて自分で Nginx と PostgreSQL を導入する。 (b) マネージドの PostgreSQL に接続文字列だけで接続して使う。 (c) 社内の勤怠管理をブラウザで提供されるサービスで行う。 (d) コンテナイメージを渡すと事業者が自動で実行・スケールする実行環境を使う。
解答
定義 2.2 の分類に従います。
(a) IaaS。事業者が運用するのは仮想化基盤までなので、OS のパッチ適用は利用者の責任です。ゲスト OS は利用者の管理下にあります。
(b) PaaS。OS とデータベースエンジンの運用は事業者が担うため、OS のパッチ適用は事業者の責任です。ただしデータベースのメジャーバージョン更新時期の選択、権限設計、バックアップ保持期間の設定は利用者の責任として残ります。
(c) SaaS。全層を事業者が運用するので、OS のパッチ適用は事業者の責任です。利用者の責任はアカウント管理と、どのデータを入力するかの判断です。
(d) PaaS。コンテナランタイムより下は事業者が運用するので OS のパッチは事業者の責任ですが、コンテナイメージの中に含まれるライブラリ(基底イメージの OS パッケージを含む)の更新は利用者の責任です。ここは境界が紛らわしいので注意してください。
演習 8.2標準
16 vCPU のサーバーを 4 年間使う計画がある。本体購入費 120 万円、設置・電力・保守が年 18 万円、同等スペックのクラウド仮想マシンのオンデマンド単価は 220 円/時間とする。
(1) 損益分岐利用率 を求めてください。 (2) このワークロードが平日 9 時から 19 時まで(週 5 日、年 250 日)稼働するバッチ基盤であるとき、クラウドとオンプレミスのどちらが安いか判定してください。 (3) 事業者が「3 年コミットで 50% 引き」を提示した。(2) のワークロードでこの購入方式を選ぶべきか論じてください。
解答
(1) 期間は 時間、総保有コストは 円です。定義 3.1 より
すなわち約 です。
(2) 稼働時間は年 時間なので、平均利用率は
です。 なので、命題 3.2 よりオンプレミスのほうが安くなります。実際に確かめると、クラウドの 4 年総額は 万円で、オンプレミスの 万円を上回ります。
(3) 割引後の単価は 円/時間なので、新しい分岐点は
です。 なのでクラウドが有利に転じます。ただしコミット型の購入は、稼働していない時間も課金される点に注意が必要です。コミット時のクラウド総額は 万円となり、オンプレミスの 万円より高くなります。つまりこのワークロードではコミットを選ぶべきではなく、オンデマンドのまま比較して (2) の結論(オンプレミスが安い)が残ります。命題 3.2 の前提「クラウド費用は 」はオンデマンドの場合の式であり、コミット型では費用が に依存しなくなるため、命題をそのまま当てはめてはいけません。なお 注意 3.4 のとおり、実際の判断には運用人件費と調達期間も加える必要があります。
演習 8.3標準
1 台あたりのサービス率が 件/秒のアプリケーションサーバーがある。ピーク時の到着率は 件/秒とする。到着はポアソン、サービス時間は指数分布に従い、負荷は各台に均等分散されるとする。
(1) 平均応答時間を 8 ミリ秒以下にするために必要な最小台数を求めてください。 (2) そのときの 1 台あたりの利用率を求めてください。 (3) 台数をいくら増やしても達成できない応答時間の下限はいくらか答えてください。
解答
(1) 系 5.3 より です。条件は
です。まず が必要なので 、すなわち です。この範囲で分母は正なので不等式の両辺に を掛けても向きは変わらず、
を得ます。整理すると 、すなわち です。 は整数なので最小台数は 8 台です。検算すると ミリ秒で、条件を満たします。7 台では ミリ秒となり満たしません。
(2) 1 台あたりの到着率は 件/秒なので、利用率は
です。命題 5.2 の記法での にあたります。応答時間の目標を厳しくすると、利用率をかなり低く抑える必要があることが分かります。
(3) 系 5.3 の後半より ミリ秒です。これはサービス時間そのもので、待ち時間をゼロにしても縮まりません。4 ミリ秒より速くするには台数ではなく を改善する必要があります。
命題 5.5 の拡張則を考える。、 とする。
(1) スループットが最大になる台数 と、そのときの相対スループット を求めてください(小数第 2 位まで)。 (2) 同じ でアムダールの法則()が与える上限と比較し、その比を求めてください。 (3) 一般に、 を と で表す閉じた式を導いてください。
- P. Mell and T. Grance, “The NIST Definition of Cloud Computing”, NIST Special Publication 800-145, National Institute of Standards and Technology, 2011. — 定義 2.1 と 定義 2.2 の出典。
- M. Armbrust et al., “A View of Cloud Computing”, Communications of the ACM 53(4) (2010), 50–58. — クラウドの経済性と「弾力性の価値」を最初に体系的に論じた論文。
- J. D. C. Little, “A Proof for the Queuing Formula: ”, Operations Research 9(3) (1961), 383–387. — 定理 5.1 の原論文。
- G. M. Amdahl, “Validity of the single processor approach to achieving large scale computing capabilities”, AFIPS Conference Proceedings 30 (1967), 483–485. — 命題 5.5 の の場合。
- N. J. Gunther, Guerrilla Capacity Planning, Springer, 2007. — 拡張則(Universal Scalability Law)の定式化と、測定値からの の推定法。
- L. A. Barroso, U. Hölzle, and P. Ranganathan, The Datacenter as a Computer, 3rd ed., Morgan & Claypool, 2018. — データセンターの総保有コスト、電力、故障率の実データ。
- B. Beyer, C. Jones, J. Petoff, and N. R. Murphy (eds.), Site Reliability Engineering, O’Reilly, 2016. — 可用性目標(SLO)とエラーバジェットの運用。
Appendix: M/M/1 の定常分布の導出
Section titled “Appendix: M/M/1 の定常分布の導出”釣り合い方程式を立てる。 命題 5.2 で用いた を導きます。系内客数 は連続時間マルコフ連鎖で、状態 から への遷移率は到着率 、状態 から への遷移率はサービス率 です(指数分布の無記憶性により、遷移率は現在の状態のみで決まります)。これは出生死滅過程です。
定常分布 は、状態集合 とその補集合の間を出入りする確率流が釣り合うという条件(切断による釣り合い)を満たします。境界 を左から右へ渡る流量は 、右から左は なので
です。
漸化式を解く。 これは という等比数列の漸化式なので、帰納法により が従います。実際、 では自明で、 を仮定すると です。
正規化する。 確率の総和が でなければならないので
です。ここで仮定 が効きます。 のとき等比級数は収束して なので、 を得ます。したがって
です。 のときは級数が発散するため正規化できず、定常分布は存在しません。これは待ち行列が際限なく伸びる状態に対応し、応答時間の式 が で発散することと整合します。
なぜ利用率 100% を目指してはいけないか。 この事実は運用上の指針に直結します。到着がゆらぐ以上、平均利用率を に近づける設計は、待ち行列が発散する領域へ一時的に入ることを許すことになります。オートスケールの目標利用率を 〜 に置くのは、余裕を無駄にしているのではなく、命題 5.2 の分母 に安全余裕を確保しているのです。
執筆: Claude Code(Sonnet 5.5)・監査 3 回(Claude Code)・最終 2026-10-12
この記事の誤りを報告する ・運営: 夢現技研合同会社 ・料金 ・利用条件 ・特定商取引法に基づく表記
© 2026 夢現技研合同会社 ・コード例は MIT ライセンスです。