探索アルゴリズム:二分探索の O(log n) とハッシュ表の平均 O(1)
対象読者: 本テーマ第 1〜3 章(O 記法、配列・リストなどの基本データ構造、ソートと再帰)を学んだ人。確率の初歩(期待値)があると読みやすく、ハッシュ表の知識は仮定しません。
前提となる記事:ソートアルゴリズム:バブルソート・マージソート・クイックソートと「二乗の壁」
0. この記事の要点
Section titled “0. この記事の要点”辞書で単語を引くとき、先頭から順に読む人はいません。真ん中あたりを開き、探す語がそれより前か後かで、残りの半分に絞っていきます。この記事は、この「半分に絞る」やり方がなぜ速く、なぜこれ以上は速くできないのかを示し、さらに順序を使わず「語から直接ページを計算する」ハッシュ表がなぜ平均して一瞬で済むのかを説明します。読み終えると、二分探索を間違いなく書く方法と、ハッシュ表の「平均」が何を意味するのかを説明できるようになります。
- 線形探索は です。ソートという前処理を一度だけ払えば、二分探索は最悪でも 回の比較で答えます。 でも 30 回です。
- 二分探索の正しさは「探索区間の外側は答えが確定している」という不変条件で証明できます。実装の誤りの大半は、この不変条件を書き下さないまま添字をいじることから生じます。
- キーどうしの比較しか使えないモデルでは 回が下界で、二分探索は最適です。これ以上速くするにはモデルを変えるしかありません。
- ハッシュ表はキーの値から添字を計算し、比較モデルの外に出ます。最悪計算量は のままですが、負荷率 を定数に保てば探索・挿入・削除は期待 時間です。
- 「平均 」には性質の違う 3 つの意味(データの分布仮定、ハッシュ関数の乱択、リサイズのならし)が混在しています。実務で頼ってよいのは後ろの 2 つです。
- ハッシュ表は順序を失います。最小値・範囲検索が要るなら、ソート済み配列か平衡二分探索木を選びます。
1. 動機:探索を速くするために何を捨てるか
Section titled “1. 動機:探索を速くするために何を捨てるか”探索は、計算機がもっとも頻繁に実行する操作です。データベースのインデックス、コンパイラのシンボル表、ルータの経路表、言語の連想配列、いずれも中身は「キーを与えると対応する値を返す」装置です。素朴にやるなら線形探索で、 個のデータに 時間かかります。 が 10 なら誰も困りませんが、 ではどうにもなりません。 記法がスケーラビリティを測る道具だという話は 計算量とO記法 で扱いました(定義 3.1[計算量と O 記法])。ここではその道具で、探索を速くする 2 つの道筋を最後まで追いかけます。
第 1 の道は前処理です。あらかじめデータを並べ替えておけば、1 回の比較で候補を半分に減らせます。これが二分探索で、比較回数は になります。ただしソートには 時間かかる(ソートアルゴリズム の 定理 4.2[ソートアルゴリズム])ので、前処理が引き合うかは検索回数次第です。 の配列を 回検索する場面を比較回数だけで概算すると、線形探索は最悪 回、ソートしてから二分探索する方は 回です。損益分岐点は で、20 回より多く検索するならソートしたほうが得だと分かります。前処理は繰り返し使ってはじめて回収できるのです。
第 2 の道はキーの値を直接使うことです。比較は「大きいか小さいか」という 1 ビットしか引き出しませんが、キーが整数やビット列なら、その中身を計算に使って格納位置を決められます。これがハッシュ法で、うまくいけば すら要らず、平均で定数時間になります。
歴史を少しだけ挟みます。二分探索の着想自体は古く、Knuth によれば計算機上での言及は 1946 年の Mauchly の講義にさかのぼりますが、任意の長さ に対して正しく動く版が公刊されたのは 1960 年前後、最初の言及から十数年後のことでした(『The Art of Computer Programming』第 3 巻 §6.2.1 の歴史的注記)。J. Bentley は『Programming Pearls』で、時間を与えられたプロの技術者の大半が正しい二分探索を書けなかったと報告しています。極めつけは 2006 年で、Java の標準ライブラリ Arrays.binarySearch が中央位置を (low + high) / 2 で計算していたために、要素数が を超えると加算が桁あふれして添字が負になる不具合が見つかりました。20 行に満たないアルゴリズムが、広く使われた標準ライブラリの中で壊れていたのです。だからこの記事では、正しさを不変条件で証明します。
ハッシュ法のほうは、Knuth の歴史的注記(同書 §6.4)によれば 1953 年 1 月の H. P. Luhn による IBM 社内メモが最初の記述で、そこにはすでにチェイン法が現れています。
2. 準備:探索問題と 2 つの計算モデル
Section titled “2. 準備:探索問題と 2 つの計算モデル”まず、これから何を実装しようとしているのかを抽象データ型として固定します。
キーの集合 と値の集合 を固定します。辞書とは、相異なるキーをもつ有限個の対の集合 を保持し、次の 3 つの操作を提供する抽象データ型です。
- : となる を返す。そのような がなければ「無い」と答える。
- : に を加える(同じキーの対がすでにあれば値を置き換える)。
- :キーが である対を から取り除く。
以下、 と書きます。
Python の dict、Java の HashMap、C++ の std::map はいずれもこの抽象データ型の実装です。実装が違えば計算量も、できることも違います。その差は第 7 節で表にします。
次に、計算量を測る土俵を 2 つ用意します。どちらの土俵に立つかで結論が変わります。
キーの集合 に全順序 が与えられているとします。アルゴリズムがキーについて行える操作が「2 つのキー を比べて , , のいずれであるかを知る」ことだけであるとき、そのアルゴリズムは比較モデルで動くといいます。キーの値を使った算術(下位ビットを取り出す、 を計算する、など)は比較モデルでは禁止されます。
これに対し、キーをビット列とみなして算術や添字計算に使ってよい土俵を、ここではアドレス計算モデル(語 RAM モデル)と呼びます。整数の加減乗除・剰余・ビット演算と、配列の添字アクセスが 1 単位時間でできるものとします。これは 一様コスト RAM モデル(定義 2.1)[計算量と O 記法] と同じ約束です。
これはソートの下界を論じるときに使った 比較ソートモデル(定義 2.2)[ソートアルゴリズム] と同じ制約です。比較モデルの利点は汎用性です。キーが文字列でも日付でもユーザ定義の構造体でも、比較さえ定義されていれば同じアルゴリズムが動きます。代償として、第 4 節で見るとおり の壁が生じます。
土台として、線形探索の費用を確定させておきます。
長さ の配列 の要素はすべて相異なるとし、キー を の順に比べていく線形探索を考えます。
- が のどこにも現れないとき、比較回数はちょうど 回です。
- が のいずれかの位置に等確率で現れるとき、比較回数の期待値は 回です。
いずれの場合も計算量は です。
証明(命題 2.3)
(1) アルゴリズムは について かどうかを調べ、どれも成立しないので 回比較して「無い」と答えます。
(2) である場合、比較は に対して行われるので 回です。各 の確率が なので、期待値は
です。途中で等差数列の和 を使いました。 も も です。
期待値を取っても定数倍しか改善しません。 から抜け出すには、走査の順序ではなくデータの持ち方を変える必要があります。
3. 二分探索:不変条件で正しさを保証する
Section titled “3. 二分探索:不変条件で正しさを保証する”3.1. 何を返す関数として定義するか
Section titled “3.1. 何を返す関数として定義するか”「 を見つけたら添字、見つからなければ 」という仕様は、実は扱いにくい仕様です。重複キーがあるとどの添字を返すか曖昧ですし、「無かった」ときに挿入すべき位置が分かりません。そこで境界を返す形に定義し直します。
が昇順である以上、 を満たす添字の集合は という形の切片になります。実際 かつ なら だからです。したがって は「 となる最小の添字」(そのような添字がなければ )と一致します。この値さえ得られれば、存在判定は かつ で済み、ソート順を保った挿入位置もそのまま得られます。
3.2. アルゴリズム
Section titled “3.2. アルゴリズム”def lower_bound(a, x): """昇順の配列 a に対し、a[i] >= x となる最小の i を返す(無ければ len(a))。""" lo, hi = 0, len(a) while lo < hi: mid = lo + (hi - lo) // 2 if a[mid] < x: lo = mid + 1 else: hi = mid return lo
def contains(a, x): i = lower_bound(a, x) return i < len(a) and a[i] == x区間は半開区間 で持ちます。hi を「まだ調べていない範囲の右端の 1 つ先」とすることで、空区間が という 1 つの条件で表せ、場合分けが減ります。
3.3. 正しさ
Section titled “3.3. 正しさ”次の証明は、ループが回るたびに「 より左はすべて 未満、 以降はすべて 以上」という性質が崩れないことを確かめ、最後に になったとき答えが 1 つに決まる、という流れです。なお初期状態の「 より左」には添字が 1 つも無いので、「すべて 未満」という主張に反する例は存在しません。このように、該当するものが無いために成り立つとみなす扱いを「空虚に真」といいます。
証明(定理 3.2)
次の 3 つの条件をループ不変条件とします。
- (I1)
- (I2) すべての について
- (I3) すべての について
初期化。 , のとき (I1) は明らかに成立します。(I2) は「 なる添字」が存在しないので空虚に真、(I3) も「 なる添字」が存在しないので空虚に真です。
中央位置の範囲。 ループ本体に入るとき 、すなわち です。 について より 。また なら 、 なら なので、いずれにせよ 、つまり です。よって であり、 の参照は配列の範囲内で、(I1) も保たれます。
保存。 2 つの場合に分かれます。
のとき、 を に更新します。 なる任意の について、 が昇順(定理の仮定)なので 。よって新しい についても (I2) が成り立ちます。(I3) は を変えていないので保たれます。
のとき、 を に更新します。 なる任意の について、昇順性より 。よって新しい についても (I3) が成り立ちます。(I2) は を変えていないので保たれます。
停止。 の場合、 は に、そうでない場合は になります(どちらも を使いました)。したがって は毎回 1 以上減り、かつ (I1) より 以上なので、ループは有限回で終わります。
終了時。 ループを抜けたとき です。(I2) より なるすべての添字が を満たすので 、(I3) より なる添字はどれも で条件を満たさないので 。両者を合わせて であり、返り値は正しい値です。 のときはループが 1 度も回らず を返しますが、これも と一致します。
3.4. 計算量
Section titled “3.4. 計算量”この証明のねらいは「1 回の反復で探索区間の長さが半分以下になる」ことです。区間の長さが奇数でも偶数でも、中央の要素を除いた残りの片側は元の半分以下に収まります。たとえば長さ 10 なら残りは 5 か 4、長さ 7 なら残りは 3 か 3 です。以下では偶数と奇数に分けて、これを式で確かめます。
証明(定理 3.3)
まず 2 つの表示が等しいことを確かめます。 とおくと 、したがって なので です。
次に反復回数を数えます。反復開始時の区間長を 、終了時を とし、 の定義から とおきます。定理 3.2 の証明で見たとおり です。
- の場合:。
- の場合:。
が偶数なら 、 が奇数なら なので、どちらの場合も が成り立ちます。
回の反復後の区間長を と書くと で、いま示した不等式から です( についての帰納法)。 は非負整数なので です。 とすると なので 、つまり となり、ループ条件 が破れます。よって反復回数は高々 回で、各反復はキーの比較をちょうど 1 回行うので、比較回数も同じ上界を持ちます。
例 3.4(二分探索の実行を最後まで追う)
()とします。上界は 回です。
まず を探します。
| 反復 | lo | hi | mid | A[mid] | 更新 | |
|---|---|---|---|---|---|---|
| 1 | 0 | 10 | 5 | 13 | 偽 | hi = 5 |
| 2 | 0 | 5 | 2 | 5 | 真 | lo = 3 |
| 3 | 3 | 5 | 4 | 11 | 真 | lo = 5 |
| — | 5 | 5 | — | — | — | 終了、5 を返す |
比較 3 回で を得ました。 なので は存在します。
次に を探します。
| 反復 | lo | hi | mid | A[mid] | 更新 | |
|---|---|---|---|---|---|---|
| 1 | 0 | 10 | 5 | 13 | 真 | lo = 6 |
| 2 | 6 | 10 | 8 | 23 | 偽 | hi = 8 |
| 3 | 6 | 8 | 7 | 19 | 偽 | hi = 7 |
| 4 | 6 | 7 | 6 | 17 | 偽 | hi = 6 |
| — | 6 | 6 | — | — | — | 終了、6 を返す |
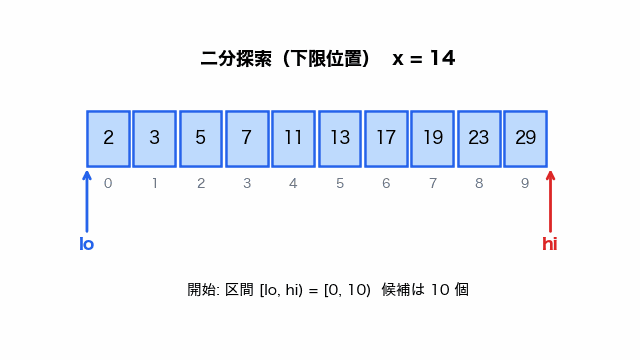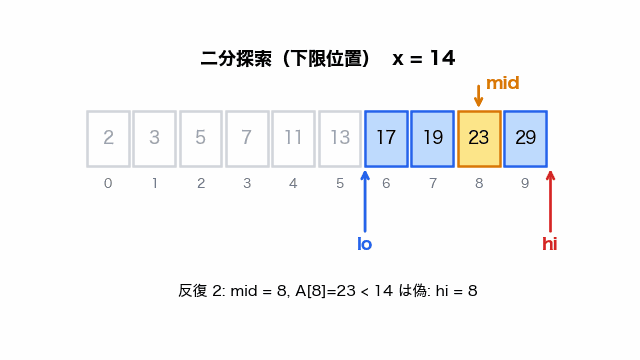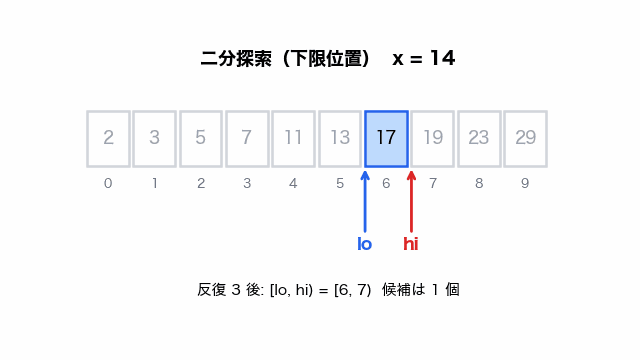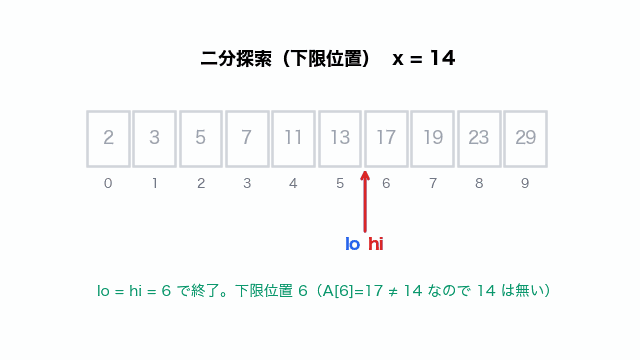
比較 4 回で 。 なので は存在せず、もし挿入するなら添字 6 の位置だと分かります。この 4 回は 定理 3.3 の上界ちょうどで、上界が達成され得ることも確認できました。
の探索を動きで見ると、mid の比較ごとに候補の区間(青)が半分以下に絞られ、最後に lo = hi = 6 で止まります。
注意 3.5(実装上の落とし穴)
mid = (lo + hi) // 2 と書くと、固定長整数を使う言語では lo + hi が桁あふれします。32 ビット符号付き整数なら、要素数が を超えた時点で和が負になり、添字が範囲外になります。これが 2006 年に Java 標準ライブラリで見つかった不具合で、lo + (hi - lo) // 2 と書けば なので桁あふれしません。Python の整数は多倍長なのでこの問題は起きませんが、書き癖として後者を勧めます。
もう 1 つは「等しいときに即座に返す」変種です。運がよければ早く終わりますが、重複キーのときどの添字を返すか決まらず、最悪比較回数も減りません(定理 4.1)。境界を返す形に統一しておくほうが応用が利きます。
3.5. 配列でなくてもよい:述語の二分探索
Section titled “3.5. 配列でなくてもよい:述語の二分探索”二分探索が使えるための本質的な条件は「配列がソートされていること」ではなく、判定が単調であることです。真偽値を返す述語 が (偽が続いた後に真が続く)を満たすなら、同じ手続きで「 が真になる最小の点」を求められます。 という述語はその特別な場合です。
例 3.6(答えで二分探索する:整数平方根)
非負整数 に対して 、つまり を満たす最大の整数 を求めます。述語 は について単調( が大きくなると偽から真に一度だけ変わる)なので、二分探索できます。
def isqrt(n): """n >= 0 に対し floor(sqrt(n)) を返す。""" lo, hi = 0, n + 1 # 不変条件: lo*lo <= n < hi*hi while hi - lo > 1: mid = (lo + hi) // 2 if mid * mid <= n: lo = mid else: hi = mid return lo不変条件は です。初期値では であり、 なので成立します。ループ内で ( のとき は両端の間に来る)なので、どちらの更新でも区間は真に狭まり、不変条件は保たれます。終了時 かつ なので、 です。
なら、初期区間長 が 1 回ごとに半分以下になるので反復は 回です( による)。答えの を から順に試せば 回のところ、60 回で終わります。なお Python には math.isqrt があります。
4. なぜ log n より速くならないのか:比較モデルの下界
Section titled “4. なぜ log n より速くならないのか:比較モデルの下界”をさらに縮められないかを考えます。答えは「比較モデルの中では不可能」です。証明の道具は決定木、つまりアルゴリズムの実行を「比較の結果でどちらの枝に進むか」の木として表す見方です。比較ソートの 下界(定理 6.1[ソートアルゴリズム])とまったく同じ道具立てで、葉の個数を下から、木の深さを上から押さえます。
とします。比較モデル(定義 2.2)で動く任意の決定的アルゴリズム が、昇順にソートされた長さ の配列 とキー を入力として を出力するならば、ある入力 に対して は少なくとも 回の比較を行います。
証明の方針は、答えの異なる入力を 個用意し、それぞれが決定木の別々の葉に着くことを示すことです。1 回の比較は枝を 2 本に分けるだけなので、深さ の木の葉は高々 枚しかありません。 枚の葉が要るなら でなければならず、そこから の下限が出ます。たとえば 、 なら、入力 の答えは の 4 通りで、次の図のように深さ 2 の木の 4 枚の葉にちょうど 1 つずつ対応します。
証明(定理 4.1)
配列を 、すなわち に固定します。これは昇順で要素はすべて相異なります。探索キーとして ()という 個の入力を考えます。
これらの出力はすべて異なります。実際 だからです。
の実行を、この 個の入力に限って決定木として描きます。 が行う比較は 2 種類あります。
- 配列の要素どうしの比較 と : は 個の入力すべてで同じなので、結果もすべて同じです。したがってこの節点ではすべての入力が同じ枝に進み、入力の区別に寄与しません。
- 探索キーと配列要素の比較 と : は偶数、 は奇数なので は決して起こりません。よって結果は「」か「」の 2 通りで、この節点の枝は実質 2 本です。
1 に当たる節点を縮約すれば、 個の入力の実行経路は 2 分木の根から葉への経路になります。比較回数の最大値を とすると、この 2 分木の深さは 以下なので、葉の個数は高々 です。
一方、2 つの入力 が同じ葉に到達したとすると、 は決定的なので同じ出力を返します。しかし上で見たように なので、少なくとも一方は誤答です。 が正しい以上これは起こり得ず、 個の入力は相異なる葉に到達します。
したがって 、すなわち です。 は整数なので が従います。
注意 4.3(下界から逃げる 2 つの方向)
定理 4.1 が縛っているのは「比較しかしない」アルゴリズムだけです。キーの値そのものを計算に使えば、この下界は適用されません。
1 つ目の逃げ道は補間探索です。電話帳で「さ」を引くとき真ん中を開かないのと同じ発想で、 の値から予想位置 を計算します(この式に限り は両端を含む閉区間とし、 も探索範囲の要素とします)。キーが区間上の一様分布から独立に選ばれるという仮定のもとで期待比較回数は になりますが(Knuth 前掲書 §6.2.1)、分布が偏ると最悪 に劣化します。
2 つ目が次節のハッシュ法で、キーから格納位置そのものを計算し、比較回数を定数にします。どちらも「比較しかしない」制約を捨てて下界を回避しています。下界とは、モデルの中でできることの限界であって、問題の限界ではありません。
5. ハッシュ表:キーから住所を計算する
Section titled “5. ハッシュ表:キーから住所を計算する”5.1. 直接アドレス表とその破綻
Section titled “5.1. 直接アドレス表とその破綻”キーが 以上 以下の整数なら、長さ の配列 を用意して に値を置けば、探索・挿入・削除はすべて最悪 です。これを直接アドレス表といいます。問題は空間です。キーが 64 ビット整数なら 個のスロットが要り、格納するキーが 1000 個でも不可能です。文字列キーならさらに絶望的です。
そこで、大きなキー空間 を小さな添字空間に押し込む関数を挟みます。
を正の整数、 を長さ の配列(ハッシュ表)、 を関数(ハッシュ関数)とします。キー はスロット に関係づけて格納します。相異なるキー に対して となることを衝突といいます。格納されているキーの個数を として、 を負荷率と呼びます。
証明(命題 5.2)
前半は鳩の巣原理です。 個の元を 個の値に写す以上、同じ値を取る 2 元が存在します。
後半を示します。 は 個の逆像 に分割されます。もしすべての について なら、 となり、仮定 に反します。よってある で となり、その逆像から 個選べば が得られます。
つまり、 をどれほど巧妙に設計しても、それを知った相手は全キーを同じスロットに集める入力を作れます。**ハッシュ表の最悪計算量は であり、これは改善できません。**それでも実用になるのは平均で見れば定数時間だからです。以下、その「平均」の意味を 2 通りに分けて厳密に述べます。
5.2. チェイン法
Section titled “5.2. チェイン法”チェイン法では、 に「 であるキーの連結リスト」への参照を置きます。挿入はリストの先頭に繋ぐだけ、探索は のリストを走査、削除はリストから外します。連結リストの基本操作は 基本的なデータ構造 で扱ったとおりです(命題 4.2[基本的なデータ構造])。
スロットのハッシュ表に 個のキーをチェイン法で格納し、 とします。次の仮定を置きます。
- 単純一様ハッシュの仮定:格納される各キーは、他のキーと独立に、 個のスロットのそれぞれに確率 で写る。
- ハッシュ関数 の計算は 時間でできる。
- 新しいキーはリストの先頭に挿入する。
このとき次が成り立ちます。
- 表に格納されていないキー (その もまた 個のスロット上の一様分布に従い、格納済みのキーとは独立とする)を探索するとき、走査されるリスト要素数の期待値は であり、探索時間の期待値は です。
- 格納されている 個のキーのどれを探すかが等確率であるとき、走査されるリスト要素数の期待値は であり、探索時間の期待値は です。
この証明では、「あるキーが特定のスロットに入るなら 1、そうでなければ 0」という値を取る変数(指標変数)を使います。個数を数える代わりに 0 と 1 の和で表すと、期待値の線形性で和を 1 項ずつ計算できます。(2) では、先頭に挿入するので「後から入れたキーほどリストの前に並ぶ」ことに注目してください。あるキーを探すとき、そのキーより前にあるのは、そのキーより後に挿入されて同じスロットに入ったキーだけです。
証明(定理 5.3)
(1) 不成功探索。 スロット のリストの長さを と書きます。 番目のキー について指標変数 ( のとき)、(それ以外)を定めると です。単純一様ハッシュの仮定から 、したがって です。期待値の線形性より
不成功探索では のリストを最後まで走査します。 が格納済みキーの配置と独立で一様なので、走査数の期待値は です。これに の計算と表アクセスの を加えて、時間は です。
(2) 成功探索。 挿入された順にキーを とします。先頭挿入なので、 を探すときにリスト上で より前にあるのは「 より後に挿入され、かつ と同じスロットに写ったキー」です。 に対して指標変数 ( のとき)、(それ以外)を定めると、単純一様ハッシュの仮定と独立性から
です。 の探索で調べる要素数は ( 自身の 1 個と、前に並ぶキーの個数)なので、どのキーを探すかについて平均を取ると
を得ます。途中で を、最後の等号では を使いました。この値は 以上 以下なので、時間は です。
証明(系 5.4)
探索は 定理 5.3 から期待 です。挿入は、同じキーが無いことが分かっているならリスト先頭に繋ぐだけで最悪 、重複を排除するなら先に探索するので期待 です。削除は、双方向連結リストを使い削除対象の要素への参照が与えられていれば最悪 、キーだけが与えられた場合は探索を伴うので期待 です。
例 5.5(チェイン法を手で動かす)
、 とし、 をこの順に挿入します。, , , , なので、先頭挿入の結果は
です。 の探索は のリストを先頭から見て、(不一致)、(一致)の 2 回の比較で成功します。 の探索は なので の 3 回を比較して不成功に終わります。
負荷率は で、定理 5.3 の (1) が予言する不成功探索の期待走査数は 回ですが、実際には 3 回かかりました。矛盾ではありません。定理は「キーが一様ランダムに散る」という仮定の下での期待値であり、いま選んだ 5 個は仮定から見て極端に運の悪い配置だからです。しかも を使う限り、8 の倍数だけ離れたキーは必ず衝突します。仮定は現実には成り立ちません。次の節がこの穴を塞ぎます。
5.3. 仮定を捨てる:万能ハッシュ族
Section titled “5.3. 仮定を捨てる:万能ハッシュ族”定理 5.3 の弱点は、確率がデータの側にあることです。入力がどう分布するかは、たいていの場合こちらには決められません。そこで、確率の出どころをアルゴリズム自身のコイン投げに移します。ハッシュ関数を 1 つに固定せず、族から実行時にランダムに選ぶのです。前の定理ではデータがランダムに散ることを仮定していましたが、ここではデータはどんなものでもよく、ランダムなのはプログラムが起動時に引く関数の選び方だけです。
を から への関数からなる有限集合とします。任意の相異なる に対して
が成り立つとき(確率は から一様に選ばれる についてのもの)、 を万能(universal)であるといいます。
を万能ハッシュ族とし、 を から一様ランダムに選んで スロットの表に使います。 を である任意のキー集合( の選択と無関係に定められたもの)とし、チェイン法で格納します。このとき任意のキー に対して、 と同じスロットに入る の元の個数 の期待値は 以下です。
証明(定理 5.7)
について指標変数 ( のとき)、(それ以外)とすると です。 なので 定義 5.6 がそのまま使えて です。期待値の線形性から
を得ます。 の探索で走査するリスト要素数は高々 なので、探索時間の期待値は です。
この定理には「データがランダムである」という仮定がどこにもありません。入力は敵が選んでよく、それでも期待値は 以下です。ランダムなのは の選び方だけで、敵は を知らないからです。
注意 5.8(具体的な万能族と、ハッシュ衝突攻撃)
Carter と Wegman は、 より大きい素数 を取り、、 に対して
と定めた族 が万能であることを示しました(原論文および Cormen ほか『Introduction to Algorithms』第 11 章に証明があります)。 をプログラム起動時に乱数で選べば 定理 5.7 が使えます。
これは理論的な贅沢ではありません。Crosby と Wallach は 2003 年に、固定のハッシュ関数を使う Web アプリケーションに対して、意図的に衝突するキーを大量に送り込んで処理を に劣化させるサービス妨害攻撃を報告しました(命題 5.2 がこの攻撃が常に可能であることを保証しています)。現在の主要な言語処理系は、この対策として起動ごとにハッシュの種をランダム化しています。Python では文字列のハッシュ値がプロセスごとに変わり、環境変数 PYTHONHASHSEED で制御できます。
6. オープンアドレス法とリサイズ
Section titled “6. オープンアドレス法とリサイズ”6.1. 表の外に出ない衝突解決
Section titled “6.1. 表の外に出ない衝突解決”連結リストはポインタの分だけ空間を食い、キャッシュ効率も悪くなります。全要素を表の中だけに置く方法がオープンアドレス法です。
とし、すべてのキーを表 に直接格納します。探査関数 を、各キー について探査列 が の並べ替えになるように定めます。
- 挿入: の順に を調べ、最初に見つかった空スロットに置く。
- 探索:同じ順に調べ、キーが一致すれば成功。空スロットに当たったら「無い」と答えて終了する。
代表的な探査法は次の 3 つです。
- 線形探査:
- 二次探査:( は探査列が表全体を覆うように選ぶ)
- 二重ハッシュ:( は と互いに素でなければならない。 を素数にして とすればよい)
と が互いに素でなければならない理由は、そうでないと探査列が表全体を覆わないからです。 なら、 が動く範囲は の倍数だけ、すなわち 個のスロットに限られ、空きがあるのに挿入に失敗する事態が起こります。
6.2. 削除には墓標が要る
Section titled “6.2. 削除には墓標が要る”オープンアドレス法で削除するとき、そのスロットをただ空にしてはいけません。探索は空スロットに当たった時点で「無い」と結論するので、探査列の途中に穴が空くと、その先のキーが見つからなくなります。そこで「削除済み」を表す印(墓標)を書き込み、探索はそこを通過し、挿入はそこを再利用します。
例 6.2(線形探査を手で動かし、素朴な削除を壊す)
、 の線形探査で をこの順に挿入します。
- : が空なので 。
- : は埋まっている。 が空なので 。探査 2 回。
- : が埋まっているので に置く。探査 3 回。
- : が空なので 。探査 1 回。
結果は という長さ 4 のかたまりです。ここで を探すと、スロット ()、()、(一致)で 3 回の探査を要します。
次に を削除して を単に空にしてみます。すると の探索は、スロット (不一致)、スロット (空)で打ち切られ、表の中に があるにもかかわらず「無い」と答えます。これが墓標が必要な理由です。
削除する前の状態に戻して を挿入すると、 から まで埋まっているので に回り込み、探査 5 回かかります。かたまりが長いほど新しい挿入が高くつく、この現象を一次クラスタリングと呼びます(演習 8.3 で定量化します)。
6.3. 探査回数の評価
Section titled “6.3. 探査回数の評価”一様ハッシュの仮定、すなわち各キーの探査列が の 通りの並べ替えから一様ランダムに、他のキーと独立に選ばれると仮定します。表に 個のキーが格納されており とすると、
- 不成功探索の探査回数の期待値は 以下です。
- 表にあるキーの探索(どのキーを探すかは等確率)の探査回数の期待値は 以下です。
(1) の証明は Appendix に置きます。(2) は、あるキーの探索コストがそのキーを挿入したときの探査回数に等しいことを使い、(1) を 個の挿入時点について平均して積分で評価します(Cormen ほか『Introduction to Algorithms』第 11 章)。
この式の意味は数値にすると明快です。
| 負荷率 | 一様ハッシュ・不成功 | 線形探査・不成功 |
|---|---|---|
| 0.50 | 2.0 | 2.5 |
| 0.75 | 4.0 | 8.5 |
| 0.90 | 10.0 | 50.5 |
| 0.95 | 20.0 | 200.5 |
右列は線形探査に対する Knuth の解析(『The Art of Computer Programming』第 3 巻 §6.4)による値で、原因は 例 6.2 で見たかたまりです。表が 9 割埋まると探査が 50 回、 という漸近的な主張が実際の速度を保証しないことの好例です。だから実装では、負荷率が閾値(0.5 から 0.75 程度)を超えたら表を作り直します。
6.4. リサイズのならし計算量
Section titled “6.4. リサイズのならし計算量”空のハッシュ表(初期容量 )から始め、負荷率が に達するたびに容量を 2 倍にして全要素を新しい表に入れ直すとします。1 回のキー挿入自体の費用と、1 個の要素の入れ直しの費用をそれぞれ定数とみなすと、 回の挿入にかかる総費用は です。すなわち 1 回の挿入あたりのならし費用は です。
証明(命題 6.4)
容量は と推移します。容量 の表からの作り直しは、要素数が に達したときに起こり、そのとき移し替える要素は 個なので費用は定数 を用いて と書けます。
回の挿入の間に起こる作り直しは、 を満たす についてのものだけです。そのような の最大値を とすると、作り直しの総費用は
です。等比数列の和 と、 の取り方から すなわち であることを使いました。これに挿入そのものの費用 を足しても総費用は で、1 回あたり です。
なお、個々の挿入は最悪 時間かかります(作り直しに当たったとき)。ならし計算量が保証するのは操作列全体の総和であって、各操作の上界ではありません。同じ等比級数の議論は動的配列の倍々拡張にもそのまま当てはまります(定理 3.3[基本的なデータ構造])。
注意 6.5(「平均 O(1)」の 3 つの意味)
ここまでで、性質の違う 3 種類の「平均」が出てきました。混同すると議論が噛み合いません。
- 入力の分布に関する平均:ランダムなのは入力データです(定理 5.3)。単純一様ハッシュが現実に成り立つ保証はありません(例 5.5)。
- 乱択アルゴリズムの期待値:ランダムなのはアルゴリズムが選ぶハッシュ関数で、入力は任意でよい(定理 5.7)。実務で頼れるのはこちらです。
- ならし(償却)計算量:ランダムな要素はどこにもなく、操作列全体の総費用を操作数で割った決定的な上界です(命題 6.4)。償却と平均が別物であることは 注意 3.5[基本的なデータ構造] でも注意しました。
現代のハッシュ表は後ろ 2 つを組み合わせています。種をランダム化したハッシュ関数を使い、負荷率が閾値を超えたら倍々に拡張するのです。
7. どの構造を選ぶか
Section titled “7. どの構造を選ぶか”辞書(定義 2.1)の 3 操作について、これまでの結果と既出の構造を並べます。 は要素数、 は範囲検索が返す要素数です。
| 構造 | 探索 | 挿入 | 削除 | 最小値・範囲検索 | 根拠 |
|---|---|---|---|---|---|
| 未整列の配列・連結リスト | 命題 2.3 | ||||
| ソート済み配列 | 定理 3.3、系 4.2 | ||||
| 平衡二分探索木 | 基本的なデータ構造 | ||||
| ハッシュ表 | 期待 、最悪 | 期待 | 期待 | 定理 5.3、命題 5.2 |
選択の指針は次のとおりです。
- データが静的で範囲検索や整列出力が要るなら、ソート済み配列と二分探索がもっとも単純で速く、余分な空間も要りません。
- 挿入・削除が頻繁で順序も要るなら平衡二分探索木です。ハッシュ表と違って「 以上の最小の要素」を で答えられます。
- 順序が要らないならハッシュ表が最速です。ただし最悪 であることと、外部から来るキーにはハッシュの種のランダム化が要ること(注意 5.8)を忘れないでください。
なお、この記事で扱ったのは「キーの集合の中を探す」問題です。状態空間や地図のように要素が辺で繋がった構造を探す問題は幅優先探索・深さ優先探索の話題で、グラフアルゴリズム で扱います。同じ「探索」でも枠組みが違います。
lower_bound の判定を 1 か所だけ変えて、 を返す関数 upper_bound を作ってください。またそれを使って、昇順配列 に含まれる の個数を 時間で求める方法を述べ、、 で値を確かめてください。
解答
判定を a[mid] < x から a[mid] <= x に変えるだけです。不変条件は「」「」となり、定理 3.2 の証明と同じ議論(昇順性で片側の添字全体に条件を伝播させる)が通って、返り値は になります。
個数は、 で、 が昇順だから両方の集合は の形の切片です。差は区間 となり、個数は 。二分探索 2 回なので比較回数は高々 回、 時間です。
、 では、 なのは だけなので 、 なのは の 4 個なので 。個数は で、確かに は 3 個あります。 なので比較回数の上界は 回です。
演習 8.2標準
単純一様ハッシュの仮定(定理 5.3)のもとで、 個のキーを スロットに入れたとき、同じスロットに入るキーの対の個数 の期待値を求めてください。次に , で数値を計算し、「同じスロットに入る対が少なくとも 1 つ存在する確率」が約 であることと比べて、両者の関係を説明してください。
解答
なる対に指標変数 ( のとき)、(それ以外)を割り当てます。定理 5.3 の証明中で計算したとおり です。対の総数は なので、期待値の線形性から
, では です。一方、どの対も衝突しない確率は なので、少なくとも 1 対衝突する確率は です。
両者は別の量です。 は「衝突対の個数の平均」で、0 対の場合と 2 対以上の場合を均した値です。マルコフの不等式 が両者を結びつけており、実際 で整合しています。
一般に となるのは のときで、 のスロットでも が 1400 程度あれば衝突が起こるのが普通です。衝突処理はハッシュ表の付随機能ではなく本体です。
線形探査(定義 6.1)で、占有されたスロットが連続して 個並び、その両隣が空である状態(長さ のかたまり)を考えます。次に挿入されるキー について が 上の一様分布に従うとき、このかたまりの長さが 以上になる確率を求めてください。孤立した空スロット 1 個が埋まる確率と比べて、何が起こるかを述べてください。
解答
かたまりが占める 個のスロットのいずれかに が落ちた場合、線形探査は右へ進み、かたまりの直後にある空スロットに を置きます。その結果、長さは になります。 がその直後の空スロットそのものに落ちた場合も、そこが埋まって長さは になります。また がかたまりの直前の空スロットに落ちた場合も、そこが埋まってかたまりは長さ になります(左に伸びる)。これら 個以外のスロットに落ちた場合、かたまりの長さは変わりません(別のかたまりから探査が伸びてきて併合する効果は数えないことにします)。 は一様なので、求める確率は
です。これに対して、周囲が埋まっていない孤立した空スロット 1 個が埋まる確率は、そこにちょうど が落ちる場合だけなので です。かたまりの直後の空スロット 1 個に注目しても、それが埋まる確率は で、孤立した空スロットの 倍です。
したがって、長いかたまりほど速く成長します。 が大きくなるほど吸い込む確率が上がるという正のフィードバックがあり、これを一次クラスタリングといいます。例 6.2 で の挿入に 5 回の探査を要したのは、長さ 4 のかたまりができていたためです。
定量的には、線形探査の不成功探索の期待探査回数は であり(第 6 節の表)、 では一様ハッシュを仮定した 定理 6.3 の 5 倍かかります。対策は負荷率を 0.5 前後に保つか、二重ハッシュのように探査の刻み幅をキーごとに変えてかたまりの成長を断つことです。ただし線形探査は連続領域を舐めるためキャッシュとの相性がよく、負荷率を低く保てば実測で速いこともあります。漸近的な式だけで優劣を決めないでください。
- T. H. Cormen, C. E. Leiserson, R. L. Rivest, C. Stein, Introduction to Algorithms, 4th ed., MIT Press, 2022 — 第 11 章(ハッシュ表:チェイン法、万能ハッシュ、オープンアドレス法)。邦訳は『アルゴリズムイントロダクション』(近代科学社)。
- D. E. Knuth, The Art of Computer Programming, Volume 3: Sorting and Searching, 2nd ed., Addison-Wesley, 1998 — §6.2.1(順序付き表の探索と二分探索の歴史)、§6.4(ハッシュ法と線形探査の解析、および歴史的注記)。
- J. Bentley, Programming Pearls, 2nd ed., Addison-Wesley, 2000 — コラム 4(二分探索を不変条件から正しく書く)。
- J. Bloch, “Extra, Extra — Read All About It: Nearly All Binary Searches and Mergesorts Are Broken”, Google Research Blog, 2006.
- J. L. Carter, M. N. Wegman, “Universal classes of hash functions”, Journal of Computer and System Sciences 18(2) (1979), 143–154.
- S. A. Crosby, D. S. Wallach, “Denial of Service via Algorithmic Complexity Attacks”, Proceedings of the 12th USENIX Security Symposium, 2003.
Appendix: オープンアドレス法の不成功探索の証明
Section titled “Appendix: オープンアドレス法の不成功探索の証明”準備:期待値の裾表示。 値が非負整数の確率変数 について が成り立ちます。実際、 を代入して和の順序を交換すると
となります(各 に対して の 回だけ が現れることを使いました)。
定理 6.3 の (1) の証明。 一様ハッシュを仮定し、 個のキーが格納された表で、格納されていないキーを探索するときの探査回数を とします。探索は空スロットに当たるまで続くので、「」は「最初の 回の探査がすべて占有スロットに当たった」ことと同値です。
一様ハッシュの仮定から、探査列は 個のスロットの一様ランダムな並べ替えです。第 1 探査が占有スロットに当たる確率は です。それが起こったという条件のもとで、第 2 探査は残り 個のスロットのどれかを等確率で見ることになり、そのうち占有されているのは 個なので、条件付き確率は です。以下同様に、 回目の探査が占有スロットに当たる条件付き確率は です。よって
です( 個の因子の積、 のとき。 なら確率は )。
各因子を で押さえます。 のとき
であり、最後の不等式は と から成り立ちます。したがって です。
以上を裾表示に代入し、 による等比級数の収束を使うと
を得ます。これが求める評価です。 で右辺が発散することが、表を満杯近くまで使ってはいけない理由を定量的に示しています。
執筆: Claude Code(Sonnet 5.5)・監査 3 回(Claude Code)・最終 2026-10-12
この記事の誤りを報告する ・運営: 夢現技研合同会社 ・料金 ・利用条件 ・特定商取引法に基づく表記
© 2026 夢現技研合同会社 ・コード例は MIT ライセンスです。