ChatGPT のような AI を使っていると、「なぜこんな答えが返ってくるのか」「設定を変えたら急に動かなくなったのはなぜか」と首をかしげる場面があります。この記事は、そうした疑問に答えるために、AI の内部で働いている数学をひと通り眺める回です。難しい証明を全部追う必要はありません。読み終えると、AI の不調や数字の見方について「たぶんこの理由だ」と見当をつけられるようになります。
LLM の内部は、線形代数 (埋め込み・注意機構・低ランク近似)、微分積分 (勾配・連鎖律・最適化)、確率統計 (尤度・交差エントロピー・ベイズ更新)の三つの言語でほぼ記述し尽くせます。この三つが「共通言語」です。
数学を学び直す目的は、モデルを自作することではありません。挙動を予測し、失敗を説明し、実験を設計する ためです。学習率を上げたら発散した、埋め込みの類似度が全部 0.7 くらいになる、検知精度 99% なのに現場では誤報だらけ——これらはすべて数式で説明でき、事前に見積もれます。
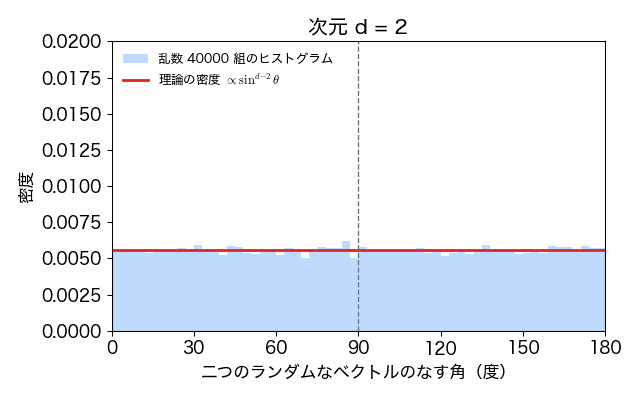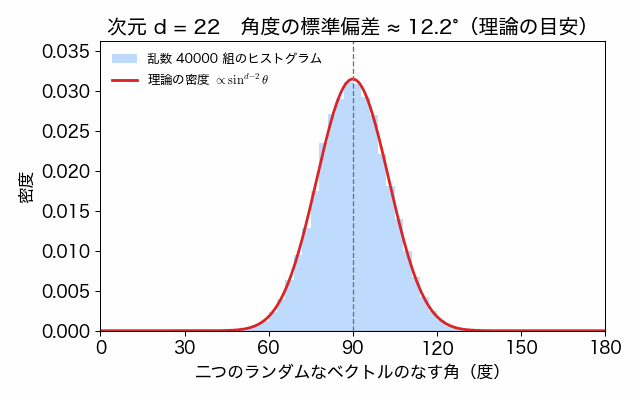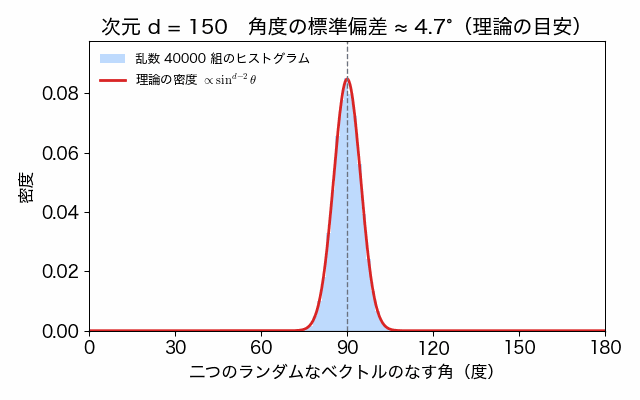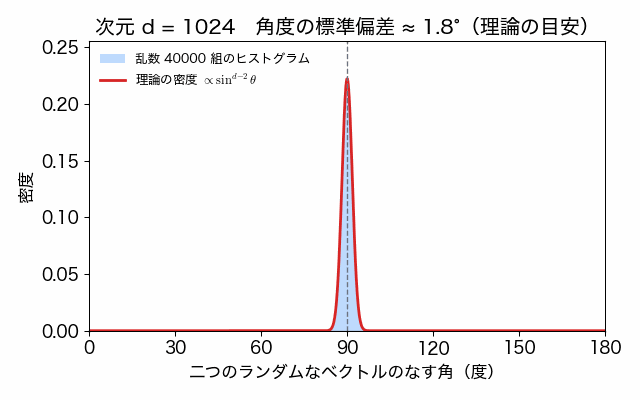
高次元空間では、無関係な二つの方向はほぼ直交します(命題 3.2 、系 3.5 )。「なぜ数千次元のベクトルに何十億もの概念を詰め込めるのか」は、この事実の帰結です。
勾配降下法が収束するかどうかは、学習率 η \eta η L L L 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L 補題 4.2 、例 4.4 )。ハイパーパラメータ調整は勘ではなく、この不等式の周りの探索です。
学習で最小化している交差エントロピー(予測が正解からどれだけ外れているかの尺度)は、KL ダイバージェンス(二つの確率分布の違いの尺度)の最小化と同じものです(命題 5.2 )。perplexity が「実質的な選択肢の数」を表すことも、この式から出ます。
数学を学ぶ副産物として得られる量化子の扱い (∀ ∃ \forall\exists ∀∃ ∃ ∀ \exists\forall ∃∀ 反例を作る習慣 は、仕様記述・障害分析・評価設計にそのまま転用できます。
特異値分解 : 行列を「回転・各軸方向の拡大・回転」の積に分ける分解。3.3 で使います。コーシー・シュワルツの不等式 : 二つのベクトルの内積の絶対値は、長さの積を超えないという不等式。コサイン類似度が − 1 -1 − 1 1 1 1 凸関数 : グラフの上の 2 点を結ぶ線分が、グラフより下に来ない関数(お椀の形)。→ 凸関数 勾配降下法 : 損失が減る向きへ少しずつ動くことを繰り返して、最小点を探す方法。→ 勾配降下法 エントロピー : 確率分布の「予測のしにくさ」を表す量。5.1 で定義を確認します。 前章 LLMとプログラミング で見たとおり、コードを書く作業の相当部分は、すでにモデルに任せられます。任せてよい範囲の目安は 委譲が得になる条件(命題 3.1)[LLMとプログラミング] に定式化しました。API を叩き、プロンプトを整え、出力を検収する。この範囲であれば、数学の知識はほとんど要りません。実際、それで十分に成果が出る局面は多くあります。
問題は、うまくいかなかったときです。
社内文書の検索を埋め込みベクトルで作ったら、どの質問にも同じ文書が上位に来る。
ファインチューニングを試したら、損失が数ステップで NaN になった。
異常検知モデルの精度は 99% と報告されているのに、現場の担当者は「9 割が誤報だ」と言う。
評価用データセットでは改善したのに、本番では悪化した。
これらはどれも、ツールの使い方の問題ではありません。空間の幾何、最適化の力学、確率の更新則 という、それぞれ別の数学的な原因があります。原因の名前を知らないと、対処は「パラメータをいろいろ変えて祈る」しかなくなります。逆に名前を知っていれば、原因の切り分けは数式一本で終わることがあります。学習率を半分にすべきか、データを増やすべきか、そもそも指標が間違っているのか——判断の根拠が手に入ります。
歴史的に見ても、この構図は新しくありません。18〜19 世紀の技術者は、蒸気機関を熱力学なしで作りました。効率を上げるには経験と勘に頼るしかなく、改良は試行錯誤でした。カルノーとクラウジウスが熱力学第二法則を定式化して初めて、「この機関の効率には理論上の上限がある」「その上限は温度比だけで決まる」と言えるようになりました。作れることと、限界を語れることは違います。
いま LLM を扱う私たちは、蒸気機関を作れるが熱力学を持たない技術者に似ています。幸い、AI の側の「熱力学」はすでに存在し、しかもその大半は大学 1〜2 年の数学です。新しい数学を発明する必要はなく、多くの人が一度は習って忘れたものを取り戻せば足ります。本章では、その「三つの言語」の中身を、実際に手を動かせる形で示します。
まず全体像を押さえます。LLM が文章を受け取ってパラメータを更新するまでの流れは、次の図のように分解できます。各段階に、対応する数学の分野を書き添えました。
LLM の一周と、各段階を支配する数学 三つの分野の役割を一言で言い分けると、こうなります。
分野 扱うもの LLM における現れ方 線形代数 「意味」を座標として表し、変換する 埋め込み、注意機構、低ランク近似(LoRA)、次元削減 微分積分 「少し動かしたらどう変わるか」を測る 勾配、連鎖律、逆伝播、学習率、収束と発散 確率統計 「もっともらしさ」と「自信」を測る 交差エントロピー、perplexity、温度、評価指標、ベイズ更新
以下、順に見ていきます。定理は完全な形で述べ、証明は行間を埋めます。手を動かせる箇所では数値を最後まで計算します。
埋め込み(embedding)とは、単語や文書を d d d 内積 が「意味の近さ」の代理になるからです。
定義 3.1 (内積とコサイン類似度 ) ↗
x , y ∈ R d \boldsymbol{x}, \boldsymbol{y} \in \mathbb{R}^d x , y ∈ R d ⟨ x , y ⟩ = ∑ i = 1 d x i y i \langle \boldsymbol{x}, \boldsymbol{y}\rangle = \sum_{i=1}^{d} x_i y_i ⟨ x , y ⟩ = ∑ i = 1 d x i y i ∥ x ∥ = ⟨ x , x ⟩ \|\boldsymbol{x}\| = \sqrt{\langle \boldsymbol{x},\boldsymbol{x}\rangle} ∥ x ∥ = ⟨ x , x ⟩ x ≠ 0 \boldsymbol{x} \ne \boldsymbol{0} x = 0 y ≠ 0 \boldsymbol{y}\ne\boldsymbol{0} y = 0
cos ( x , y ) = ⟨ x , y ⟩ ∥ x ∥ ∥ y ∥ \cos(\boldsymbol{x}, \boldsymbol{y}) = \frac{\langle \boldsymbol{x}, \boldsymbol{y}\rangle}{\|\boldsymbol{x}\|\,\|\boldsymbol{y}\|} cos ( x , y ) = ∥ x ∥ ∥ y ∥ ⟨ x , y ⟩ をコサイン類似度 と呼ぶ。コーシー・シュワルツの不等式により − 1 ≤ cos ( x , y ) ≤ 1 -1 \le \cos(\boldsymbol{x},\boldsymbol{y}) \le 1 − 1 ≤ cos ( x , y ) ≤ 1
注意機構(attention)が計算しているのも、本質的にはこの内積です。クエリベクトル q \boldsymbol{q} q k j \boldsymbol{k}_j k j ⟨ q , k j ⟩ \langle \boldsymbol{q}, \boldsymbol{k}_j\rangle ⟨ q , k j ⟩ d \sqrt{d} d d d d
ここで素朴な疑問が生じます。d = 768 d = 768 d = 768 d = 4096 d = 4096 d = 4096
答えは、高次元空間の幾何にあります。R 2 \mathbb{R}^2 R 2 R 1024 \mathbb{R}^{1024} R 1024
命題 3.2 (ランダムな二方向の内積 ) ✓
d ≥ 1 d \ge 1 d ≥ 1 u , v \boldsymbol{u}, \boldsymbol{v} u , v S d − 1 = { x ∈ R d : ∥ x ∥ = 1 } S^{d-1} = \{\boldsymbol{x}\in\mathbb{R}^d : \|\boldsymbol{x}\|=1\} S d − 1 = { x ∈ R d : ∥ x ∥ = 1 }
E [ ⟨ u , v ⟩ ] = 0 , Var [ ⟨ u , v ⟩ ] = 1 d \mathbb{E}[\langle \boldsymbol{u},\boldsymbol{v}\rangle] = 0, \qquad \operatorname{Var}[\langle \boldsymbol{u},\boldsymbol{v}\rangle] = \frac{1}{d} E [⟨ u , v ⟩] = 0 , Var [⟨ u , v ⟩] = d 1 が成り立つ。
この命題の証明の方針は、「二つのベクトルのどちらも球面上に偏りなく選んでいるのだから、片方の向きを座標軸に合わせて回してしまっても確率は変わらない」と見ることです。すると内積は、単に 1 本のベクトルの第 1 成分になり、その平均と分散だけを調べれば済みます。
証明(命題 3.2) 球面上の一様分布は回転不変です。すなわち任意の直交行列 Q Q Q Q u Q\boldsymbol{u} Q u v \boldsymbol{v} v u \boldsymbol{u} u v \boldsymbol{v} v v \boldsymbol{v} v e 1 \boldsymbol{e}_1 e 1 Q Q Q ⟨ u , v ⟩ \langle \boldsymbol{u},\boldsymbol{v}\rangle ⟨ u , v ⟩ ⟨ Q u , e 1 ⟩ = ( Q u ) 1 \langle Q\boldsymbol{u}, \boldsymbol{e}_1\rangle = (Q\boldsymbol{u})_1 ⟨ Q u , e 1 ⟩ = ( Q u ) 1 ⟨ u , v ⟩ \langle\boldsymbol{u},\boldsymbol{v}\rangle ⟨ u , v ⟩ u 1 u_1 u 1
平均について。u \boldsymbol{u} u − u -\boldsymbol{u} − u Q = − I Q = -I Q = − I u 1 u_1 u 1 − u 1 -u_1 − u 1 ∣ u 1 ∣ ≤ 1 |u_1|\le 1 ∣ u 1 ∣ ≤ 1 E [ u 1 ] = 0 \mathbb{E}[u_1] = 0 E [ u 1 ] = 0
分散について。∥ u ∥ = 1 \|\boldsymbol{u}\|=1 ∥ u ∥ = 1 ∑ i = 1 d u i 2 = 1 \sum_{i=1}^{d} u_i^2 = 1 ∑ i = 1 d u i 2 = 1 ∑ i = 1 d E [ u i 2 ] = 1 \sum_{i=1}^{d}\mathbb{E}[u_i^2] = 1 ∑ i = 1 d E [ u i 2 ] = 1 E [ u 1 2 ] = ⋯ = E [ u d 2 ] \mathbb{E}[u_1^2] = \cdots = \mathbb{E}[u_d^2] E [ u 1 2 ] = ⋯ = E [ u d 2 ] E [ u 1 2 ] = 1 / d \mathbb{E}[u_1^2] = 1/d E [ u 1 2 ] = 1/ d 0 0 0 1 / d 1/d 1/ d
∎ 標準偏差は 1 / d 1/\sqrt{d} 1/ d d = 1024 d = 1024 d = 1024 0.031 0.031 0.031 0.03 0.03 0.03
次元 d d d
ランダムな単位ベクトル 2 本のなす角の分布。次元 d が増えるほど 90 度付近に集まる(青は乱数 40000 組、赤は理論の密度)。 定理 3.3 (球面の測度集中 ) ※
d ≥ 2 d \ge 2 d ≥ 2 u \boldsymbol{u} u S d − 1 S^{d-1} S d − 1 t > 0 t > 0 t > 0
Pr [ ∣ u 1 ∣ ≥ t ] ≤ 2 e − d t 2 / 2 \Pr\bigl[\,|u_1| \ge t\,\bigr] \le 2 e^{-d t^2 / 2} Pr [ ∣ u 1 ∣ ≥ t ] ≤ 2 e − d t 2 /2 が成り立つ。
系 3.5 (ほぼ直交する方向の本数 ) △
d ≥ 2 d \ge 2 d ≥ 2 t ∈ ( 0 , 1 ) t \in (0,1) t ∈ ( 0 , 1 ) n n n
n < e d t 2 / 4 n < e^{d t^2 / 4} n < e d t 2 /4 を満たすならば、R d \mathbb{R}^d R d u 1 , … , u n \boldsymbol{u}_1,\ldots,\boldsymbol{u}_n u 1 , … , u n i ≠ j i \ne j i = j ∣ cos ( u i , u j ) ∣ < t |\cos(\boldsymbol{u}_i, \boldsymbol{u}_j)| < t ∣ cos ( u i , u j ) ∣ < t
証明(系 3.5) u 1 , … , u n \boldsymbol{u}_1,\ldots,\boldsymbol{u}_n u 1 , … , u n S d − 1 S^{d-1} S d − 1 i ≠ j i \ne j i = j 命題 3.2 の証明で見たとおり ⟨ u i , u j ⟩ \langle \boldsymbol{u}_i,\boldsymbol{u}_j\rangle ⟨ u i , u j ⟩ u 1 u_1 u 1 定理 3.3 より
Pr [ ∣ ⟨ u i , u j ⟩ ∣ ≥ t ] ≤ 2 e − d t 2 / 2 . \Pr\bigl[\,|\langle \boldsymbol{u}_i,\boldsymbol{u}_j\rangle| \ge t\,\bigr] \le 2e^{-dt^2/2}. Pr [ ∣ ⟨ u i , u j ⟩ ∣ ≥ t ] ≤ 2 e − d t 2 /2 . 「ある組 ( i , j ) (i,j) ( i , j ) t t t
( n 2 ) ⋅ 2 e − d t 2 / 2 = n ( n − 1 ) e − d t 2 / 2 < n 2 e − d t 2 / 2 \binom{n}{2}\cdot 2e^{-dt^2/2} = n(n-1)e^{-dt^2/2} < n^2 e^{-dt^2/2} ( 2 n ) ⋅ 2 e − d t 2 /2 = n ( n − 1 ) e − d t 2 /2 < n 2 e − d t 2 /2 です。仮定 n < e d t 2 / 4 n < e^{dt^2/4} n < e d t 2 /4 n 2 < e d t 2 / 2 n^2 < e^{dt^2/2} n 2 < e d t 2 /2 1 1 1 ∣ ⟨ u i , u j ⟩ ∣ < t |\langle\boldsymbol{u}_i,\boldsymbol{u}_j\rangle| < t ∣ ⟨ u i , u j ⟩ ∣ < t
∎ 例 3.6 (1024 次元に何本の「概念軸」が入るか )
系 3.5 に d = 1024 d = 1024 d = 1024 t t t
t = 0.1 t = 0.1 t = 0.1 e 1024 × 0.01 / 4 = e 2.56 ≈ 12.9 e^{1024 \times 0.01/4} = e^{2.56} \approx 12.9 e 1024 × 0.01/4 = e 2.56 ≈ 12.9 t = 0.2 t = 0.2 t = 0.2 e 1024 × 0.04 / 4 = e 10.24 ≈ 2.8 × 10 4 e^{1024 \times 0.04/4} = e^{10.24} \approx 2.8\times 10^{4} e 1024 × 0.04/4 = e 10.24 ≈ 2.8 × 1 0 4 t = 0.3 t = 0.3 t = 0.3 e 1024 × 0.09 / 4 = e 23.04 ≈ 1.0 × 10 10 e^{1024 \times 0.09/4} = e^{23.04} \approx 1.0\times 10^{10} e 1024 × 0.09/4 = e 23.04 ≈ 1.0 × 1 0 10 「コサイン類似度 0.3 0.3 0.3
同時に、この計算は実務上の警告 でもあります。上の見積もりは t t t t t t
もう一つ、実務に直結する定理を挙げます。行列の特異値分解 (SVD。行列を回転・拡大・回転に分ける分解)にもとづく最良近似の定理です。なお、定理に出てくるフロベニウスノルムは、行列の全成分を二乗して足し、平方根を取った値のことで、行列の「大きさ」を測る物差しです。
定理 3.7 (Eckart–Young–Mirsky の定理(フロベニウスノルム版) ) ※
A ∈ R m × n A \in \mathbb{R}^{m\times n} A ∈ R m × n r r r
A = ∑ i = 1 r σ i u i v i T , σ 1 ≥ σ 2 ≥ ⋯ ≥ σ r > 0 A = \sum_{i=1}^{r}\sigma_i \boldsymbol{u}_i \boldsymbol{v}_i^{\mathsf{T}}, \qquad \sigma_1 \ge \sigma_2 \ge \cdots \ge \sigma_r > 0 A = i = 1 ∑ r σ i u i v i T , σ 1 ≥ σ 2 ≥ ⋯ ≥ σ r > 0 とする({ u i } \{\boldsymbol{u}_i\} { u i } { v i } \{\boldsymbol{v}_i\} { v i } 1 ≤ k < r 1 \le k < r 1 ≤ k < r k k k A k = ∑ i = 1 k σ i u i v i T A_k = \sum_{i=1}^{k}\sigma_i\boldsymbol{u}_i\boldsymbol{v}_i^{\mathsf{T}} A k = ∑ i = 1 k σ i u i v i T k k k B ∈ R m × n B \in \mathbb{R}^{m\times n} B ∈ R m × n
∥ A − B ∥ F ≥ ∥ A − A k ∥ F = ∑ i = k + 1 r σ i 2 \|A - B\|_F \ \ge\ \|A - A_k\|_F = \sqrt{\sum_{i=k+1}^{r}\sigma_i^2} ∥ A − B ∥ F ≥ ∥ A − A k ∥ F = i = k + 1 ∑ r σ i 2 が成り立つ。ここで ∥ X ∥ F = ∑ i , j X i j 2 \|X\|_F = \sqrt{\sum_{i,j} X_{ij}^2} ∥ X ∥ F = ∑ i , j X ij 2
この定理が言っているのは、「k k k 階数 k k k だ、ということです。近似の誤差は、捨てた特異値の 2 乗和の平方根で正確に測れます。次元削減、レコメンド、ノイズ除去、そして LoRA による省パラメータ微調整は、すべてこの一つの事実の応用です。
例 3.9 (3×2 行列の最良ランク 1 近似を手で求める )
A = ( 1 1 1 1 1 − 1 ) A = \begin{pmatrix} 1 & 1 \\ 1 & 1 \\ 1 & -1 \end{pmatrix} A = 1 1 1 1 1 − 1 の最良ランク 1 近似を求めます。まず
A T A = ( 3 1 1 3 ) A^{\mathsf{T}}A = \begin{pmatrix} 3 & 1 \\ 1 & 3\end{pmatrix} A T A = ( 3 1 1 3 ) です(左上成分は 1 2 + 1 2 + 1 2 = 3 1^2+1^2+1^2 = 3 1 2 + 1 2 + 1 2 = 3 1 ⋅ 1 + 1 ⋅ 1 + 1 ⋅ ( − 1 ) = 1 1\cdot 1 + 1\cdot 1 + 1\cdot(-1) = 1 1 ⋅ 1 + 1 ⋅ 1 + 1 ⋅ ( − 1 ) = 1 ( 3 − λ ) 2 − 1 = 0 (3-\lambda)^2 - 1 = 0 ( 3 − λ ) 2 − 1 = 0 λ = 4 , 2 \lambda = 4, 2 λ = 4 , 2 v 1 = ( 1 , 1 ) T / 2 \boldsymbol{v}_1 = (1,1)^{\mathsf{T}}/\sqrt{2} v 1 = ( 1 , 1 ) T / 2 v 2 = ( 1 , − 1 ) T / 2 \boldsymbol{v}_2 = (1,-1)^{\mathsf{T}}/\sqrt{2} v 2 = ( 1 , − 1 ) T / 2 σ 1 = 4 = 2 \sigma_1 = \sqrt{4} = 2 σ 1 = 4 = 2 σ 2 = 2 \sigma_2 = \sqrt{2} σ 2 = 2
左特異ベクトルは u 1 = A v 1 / σ 1 \boldsymbol{u}_1 = A\boldsymbol{v}_1/\sigma_1 u 1 = A v 1 / σ 1
A v 1 = 1 2 ( 2 2 0 ) , u 1 = 1 2 ⋅ 1 2 ( 2 2 0 ) = 1 2 ( 1 1 0 ) . A\boldsymbol{v}_1 = \frac{1}{\sqrt{2}}\begin{pmatrix} 2 \\ 2 \\ 0\end{pmatrix}, \qquad
\boldsymbol{u}_1 = \frac{1}{2}\cdot\frac{1}{\sqrt{2}}\begin{pmatrix}2\\2\\0\end{pmatrix} = \frac{1}{\sqrt{2}}\begin{pmatrix}1\\1\\0\end{pmatrix}. A v 1 = 2 1 2 2 0 , u 1 = 2 1 ⋅ 2 1 2 2 0 = 2 1 1 1 0 . したがって
A 1 = σ 1 u 1 v 1 T = 2 ⋅ 1 2 ( 1 1 0 ) ⋅ 1 2 ( 1 1 ) = ( 1 1 1 1 0 0 ) . A_1 = \sigma_1 \boldsymbol{u}_1\boldsymbol{v}_1^{\mathsf{T}} = 2\cdot\frac{1}{\sqrt2}\begin{pmatrix}1\\1\\0\end{pmatrix}\cdot\frac{1}{\sqrt2}\begin{pmatrix}1 & 1\end{pmatrix} = \begin{pmatrix}1 & 1\\ 1& 1\\ 0 & 0\end{pmatrix}. A 1 = σ 1 u 1 v 1 T = 2 ⋅ 2 1 1 1 0 ⋅ 2 1 ( 1 1 ) = 1 1 0 1 1 0 . 誤差を確認します。
A − A 1 = ( 0 0 0 0 1 − 1 ) , ∥ A − A 1 ∥ F = 1 2 + ( − 1 ) 2 = 2 = σ 2 . A - A_1 = \begin{pmatrix}0&0\\0&0\\1&-1\end{pmatrix}, \qquad \|A-A_1\|_F = \sqrt{1^2+(-1)^2} = \sqrt2 = \sigma_2. A − A 1 = 0 0 1 0 0 − 1 , ∥ A − A 1 ∥ F = 1 2 + ( − 1 ) 2 = 2 = σ 2 . 定理 3.7 の主張どおり、誤差は捨てた特異値 σ 2 \sigma_2 σ 2 ∥ A ∥ F 2 = 6 = σ 1 2 + σ 2 2 = 4 + 2 \|A\|_F^2 = 6 = \sigma_1^2+\sigma_2^2 = 4 + 2 ∥ A ∥ F 2 = 6 = σ 1 2 + σ 2 2 = 4 + 2 4 / 6 ≈ 66.7 % 4/6 \approx 66.7\% 4/6 ≈ 66.7%
学習とは、損失関数 f f f 勾配降下法 x k + 1 = x k − η ∇ f ( x k ) \boldsymbol{x}_{k+1} = \boldsymbol{x}_k - \eta\nabla f(\boldsymbol{x}_k) x k + 1 = x k − η ∇ f ( x k ) η \eta η
定義 4.1 (L-平滑性 ) ↗
f : R n → R f:\mathbb{R}^n \to \mathbb{R} f : R n → R L > 0 L > 0 L > 0 x , y ∈ R n \boldsymbol{x},\boldsymbol{y}\in\mathbb{R}^n x , y ∈ R n
∥ ∇ f ( x ) − ∇ f ( y ) ∥ ≤ L ∥ x − y ∥ \|\nabla f(\boldsymbol{x}) - \nabla f(\boldsymbol{y})\| \le L\|\boldsymbol{x}-\boldsymbol{y}\| ∥∇ f ( x ) − ∇ f ( y ) ∥ ≤ L ∥ x − y ∥ が成り立つとき、f f f L L L L L L
L L L f f f L L L
補題 4.2 (降下補題と 1 ステップの減少量 ) ✓
f : R n → R f:\mathbb{R}^n\to\mathbb{R} f : R n → R L L L x , y \boldsymbol{x},\boldsymbol{y} x , y
f ( y ) ≤ f ( x ) + ⟨ ∇ f ( x ) , y − x ⟩ + L 2 ∥ y − x ∥ 2 f(\boldsymbol{y}) \le f(\boldsymbol{x}) + \langle \nabla f(\boldsymbol{x}), \boldsymbol{y}-\boldsymbol{x}\rangle + \frac{L}{2}\|\boldsymbol{y}-\boldsymbol{x}\|^2 f ( y ) ≤ f ( x ) + ⟨ ∇ f ( x ) , y − x ⟩ + 2 L ∥ y − x ∥ 2 が成り立つ。とくに y = x − η ∇ f ( x ) \boldsymbol{y} = \boldsymbol{x} - \eta\nabla f(\boldsymbol{x}) y = x − η ∇ f ( x )
f ( y ) ≤ f ( x ) − η ( 1 − L η 2 ) ∥ ∇ f ( x ) ∥ 2 f(\boldsymbol{y}) \le f(\boldsymbol{x}) - \eta\Bigl(1 - \frac{L\eta}{2}\Bigr)\|\nabla f(\boldsymbol{x})\|^2 f ( y ) ≤ f ( x ) − η ( 1 − 2 L η ) ∥∇ f ( x ) ∥ 2 となる。したがって ∇ f ( x ) ≠ 0 \nabla f(\boldsymbol{x}) \ne \boldsymbol{0} ∇ f ( x ) = 0 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L f ( y ) < f ( x ) f(\boldsymbol{y}) < f(\boldsymbol{x}) f ( y ) < f ( x ) η = 1 / L \eta = 1/L η = 1/ L η ( 1 − L η / 2 ) \eta(1-L\eta/2) η ( 1 − L η /2 ) 1 / ( 2 L ) 1/(2L) 1/ ( 2 L )
この補題の証明の方針は、2 点 x , y \boldsymbol{x}, \boldsymbol{y} x , y L L L
証明(補題 4.2) g ( t ) = f ( x + t ( y − x ) ) g(t) = f(\boldsymbol{x} + t(\boldsymbol{y}-\boldsymbol{x})) g ( t ) = f ( x + t ( y − x )) g g g [ 0 , 1 ] [0,1] [ 0 , 1 ] g ′ ( t ) = ⟨ ∇ f ( x + t ( y − x ) ) , y − x ⟩ g'(t) = \langle \nabla f(\boldsymbol{x}+t(\boldsymbol{y}-\boldsymbol{x})), \boldsymbol{y}-\boldsymbol{x}\rangle g ′ ( t ) = ⟨ ∇ f ( x + t ( y − x )) , y − x ⟩
f ( y ) − f ( x ) = g ( 1 ) − g ( 0 ) = ∫ 0 1 ⟨ ∇ f ( x + t ( y − x ) ) , y − x ⟩ d t . f(\boldsymbol{y}) - f(\boldsymbol{x}) = g(1)-g(0) = \int_0^1 \langle \nabla f(\boldsymbol{x}+t(\boldsymbol{y}-\boldsymbol{x})), \boldsymbol{y}-\boldsymbol{x}\rangle\,dt. f ( y ) − f ( x ) = g ( 1 ) − g ( 0 ) = ∫ 0 1 ⟨ ∇ f ( x + t ( y − x )) , y − x ⟩ d t . ここから ⟨ ∇ f ( x ) , y − x ⟩ = ∫ 0 1 ⟨ ∇ f ( x ) , y − x ⟩ d t \langle\nabla f(\boldsymbol{x}), \boldsymbol{y}-\boldsymbol{x}\rangle = \int_0^1 \langle \nabla f(\boldsymbol{x}), \boldsymbol{y}-\boldsymbol{x}\rangle dt ⟨ ∇ f ( x ) , y − x ⟩ = ∫ 0 1 ⟨ ∇ f ( x ) , y − x ⟩ d t
f ( y ) − f ( x ) − ⟨ ∇ f ( x ) , y − x ⟩ = ∫ 0 1 ⟨ ∇ f ( x + t ( y − x ) ) − ∇ f ( x ) , y − x ⟩ d t . f(\boldsymbol{y}) - f(\boldsymbol{x}) - \langle\nabla f(\boldsymbol{x}),\boldsymbol{y}-\boldsymbol{x}\rangle = \int_0^1 \langle \nabla f(\boldsymbol{x}+t(\boldsymbol{y}-\boldsymbol{x})) - \nabla f(\boldsymbol{x}),\ \boldsymbol{y}-\boldsymbol{x}\rangle\,dt. f ( y ) − f ( x ) − ⟨ ∇ f ( x ) , y − x ⟩ = ∫ 0 1 ⟨ ∇ f ( x + t ( y − x )) − ∇ f ( x ) , y − x ⟩ d t . 被積分関数にコーシー・シュワルツの不等式を使い、続いて 定義 4.1 の L L L x + t ( y − x ) \boldsymbol{x}+t(\boldsymbol{y}-\boldsymbol{x}) x + t ( y − x ) x \boldsymbol{x} x t ∥ y − x ∥ t\|\boldsymbol{y}-\boldsymbol{x}\| t ∥ y − x ∥
≤ ∫ 0 1 ∥ ∇ f ( x + t ( y − x ) ) − ∇ f ( x ) ∥ ∥ y − x ∥ d t ≤ ∫ 0 1 L t ∥ y − x ∥ 2 d t = L 2 ∥ y − x ∥ 2 . \le \int_0^1 \|\nabla f(\boldsymbol{x}+t(\boldsymbol{y}-\boldsymbol{x})) - \nabla f(\boldsymbol{x})\|\,\|\boldsymbol{y}-\boldsymbol{x}\|\,dt \le \int_0^1 L t\|\boldsymbol{y}-\boldsymbol{x}\|^2 dt = \frac{L}{2}\|\boldsymbol{y}-\boldsymbol{x}\|^2 . ≤ ∫ 0 1 ∥∇ f ( x + t ( y − x )) − ∇ f ( x ) ∥ ∥ y − x ∥ d t ≤ ∫ 0 1 L t ∥ y − x ∥ 2 d t = 2 L ∥ y − x ∥ 2 . これで第 1 の不等式が示せました。
次に y − x = − η ∇ f ( x ) \boldsymbol{y}-\boldsymbol{x} = -\eta\nabla f(\boldsymbol{x}) y − x = − η ∇ f ( x ) ⟨ ∇ f ( x ) , − η ∇ f ( x ) ⟩ = − η ∥ ∇ f ( x ) ∥ 2 \langle \nabla f(\boldsymbol{x}), -\eta\nabla f(\boldsymbol{x})\rangle = -\eta\|\nabla f(\boldsymbol{x})\|^2 ⟨ ∇ f ( x ) , − η ∇ f ( x )⟩ = − η ∥∇ f ( x ) ∥ 2 ∥ − η ∇ f ( x ) ∥ 2 = η 2 ∥ ∇ f ( x ) ∥ 2 \|{-\eta}\nabla f(\boldsymbol{x})\|^2 = \eta^2\|\nabla f(\boldsymbol{x})\|^2 ∥ − η ∇ f ( x ) ∥ 2 = η 2 ∥∇ f ( x ) ∥ 2
f ( y ) ≤ f ( x ) − η ∥ ∇ f ( x ) ∥ 2 + L η 2 2 ∥ ∇ f ( x ) ∥ 2 = f ( x ) − η ( 1 − L η 2 ) ∥ ∇ f ( x ) ∥ 2 . f(\boldsymbol{y}) \le f(\boldsymbol{x}) - \eta\|\nabla f(\boldsymbol{x})\|^2 + \frac{L\eta^2}{2}\|\nabla f(\boldsymbol{x})\|^2 = f(\boldsymbol{x}) - \eta\Bigl(1-\frac{L\eta}{2}\Bigr)\|\nabla f(\boldsymbol{x})\|^2 . f ( y ) ≤ f ( x ) − η ∥∇ f ( x ) ∥ 2 + 2 L η 2 ∥∇ f ( x ) ∥ 2 = f ( x ) − η ( 1 − 2 L η ) ∥∇ f ( x ) ∥ 2 . 係数 φ ( η ) = η − L η 2 / 2 \varphi(\eta) = \eta - L\eta^2/2 φ ( η ) = η − L η 2 /2 η \eta η φ ( η ) > 0 ⟺ 0 < η < 2 / L \varphi(\eta) > 0 \iff 0 < \eta < 2/L φ ( η ) > 0 ⟺ 0 < η < 2/ L φ ′ ( η ) = 1 − L η = 0 \varphi'(\eta) = 1 - L\eta = 0 φ ′ ( η ) = 1 − L η = 0 η = 1 / L \eta = 1/L η = 1/ L φ ( 1 / L ) = 1 / L − 1 / ( 2 L ) = 1 / ( 2 L ) \varphi(1/L) = 1/L - 1/(2L) = 1/(2L) φ ( 1/ L ) = 1/ L − 1/ ( 2 L ) = 1/ ( 2 L )
∎ 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L 2 / L 2/L 2/ L
学習率 η が 2/L より小さいとき 学習率 η が 2/L より大きいとき 損失が減りながら最小点へ収束する 振動しながら遠ざかる 学習率が閾値 2/L の内側にあるか外側にあるかで挙動が変わる 減少するだけでは足りません。「どれくらいの速さで最小値に近づくか」まで言えるのが、次の定理です。
定理 4.3 (勾配降下法の収束(凸・L-平滑の場合) ) ✓
f : R n → R f:\mathbb{R}^n\to\mathbb{R} f : R n → R L L L f ∗ = f ( x ∗ ) f^{*} = f(\boldsymbol{x}^{*}) f ∗ = f ( x ∗ ) x ∗ \boldsymbol{x}^{*} x ∗ η = 1 / L \eta = 1/L η = 1/ L x k + 1 = x k − η ∇ f ( x k ) \boldsymbol{x}_{k+1} = \boldsymbol{x}_k - \eta\nabla f(\boldsymbol{x}_k) x k + 1 = x k − η ∇ f ( x k ) K ≥ 1 K \ge 1 K ≥ 1
f ( x K ) − f ∗ ≤ L ∥ x 0 − x ∗ ∥ 2 2 K f(\boldsymbol{x}_K) - f^{*} \le \frac{L\|\boldsymbol{x}_0 - \boldsymbol{x}^{*}\|^2}{2K} f ( x K ) − f ∗ ≤ 2 K L ∥ x 0 − x ∗ ∥ 2 が成り立つ。
この定理の証明の方針は、最小点までの距離 ∥ x k − x ∗ ∥ 2 \|\boldsymbol{x}_k-\boldsymbol{x}^{*}\|^2 ∥ x k − x ∗ ∥ 2 f ( x k + 1 ) − f ∗ f(\boldsymbol{x}_{k+1})-f^{*} f ( x k + 1 ) − f ∗ k k k
証明(定理 4.3) g k = ∇ f ( x k ) \boldsymbol{g}_k = \nabla f(\boldsymbol{x}_k) g k = ∇ f ( x k )
ステップ 1(1 ステップの減少) 。補題 4.2 に η = 1 / L \eta = 1/L η = 1/ L
f ( x k + 1 ) ≤ f ( x k ) − 1 2 L ∥ g k ∥ 2 . f(\boldsymbol{x}_{k+1}) \le f(\boldsymbol{x}_k) - \frac{1}{2L}\|\boldsymbol{g}_k\|^2 . f ( x k + 1 ) ≤ f ( x k ) − 2 L 1 ∥ g k ∥ 2 . とくに f ( x 0 ) ≥ f ( x 1 ) ≥ ⋯ f(\boldsymbol{x}_0)\ge f(\boldsymbol{x}_1)\ge\cdots f ( x 0 ) ≥ f ( x 1 ) ≥ ⋯
ステップ 2(凸性) 。f f f x ∗ \boldsymbol{x}^{*} x ∗
f ( x ∗ ) ≥ f ( x k ) + ⟨ g k , x ∗ − x k ⟩ ⟺ f ( x k ) − f ∗ ≤ ⟨ g k , x k − x ∗ ⟩ . f(\boldsymbol{x}^{*}) \ge f(\boldsymbol{x}_k) + \langle \boldsymbol{g}_k, \boldsymbol{x}^{*}-\boldsymbol{x}_k\rangle
\quad\Longleftrightarrow\quad
f(\boldsymbol{x}_k) - f^{*} \le \langle \boldsymbol{g}_k, \boldsymbol{x}_k - \boldsymbol{x}^{*}\rangle . f ( x ∗ ) ≥ f ( x k ) + ⟨ g k , x ∗ − x k ⟩ ⟺ f ( x k ) − f ∗ ≤ ⟨ g k , x k − x ∗ ⟩ . ステップ 3(両者の結合) 。ステップ 1 の右辺の f ( x k ) f(\boldsymbol{x}_k) f ( x k )
f ( x k + 1 ) − f ∗ ≤ ⟨ g k , x k − x ∗ ⟩ − 1 2 L ∥ g k ∥ 2 . f(\boldsymbol{x}_{k+1}) - f^{*} \le \langle \boldsymbol{g}_k, \boldsymbol{x}_k-\boldsymbol{x}^{*}\rangle - \frac{1}{2L}\|\boldsymbol{g}_k\|^2 . f ( x k + 1 ) − f ∗ ≤ ⟨ g k , x k − x ∗ ⟩ − 2 L 1 ∥ g k ∥ 2 . ステップ 4(望遠鏡和にする) 。x k + 1 = x k − g k / L \boldsymbol{x}_{k+1} = \boldsymbol{x}_k - \boldsymbol{g}_k/L x k + 1 = x k − g k / L
∥ x k − x ∗ ∥ 2 − ∥ x k + 1 − x ∗ ∥ 2 = ∥ x k − x ∗ ∥ 2 − ∥ x k − x ∗ − g k L ∥ 2 = 2 L ⟨ g k , x k − x ∗ ⟩ − 1 L 2 ∥ g k ∥ 2 . \|\boldsymbol{x}_k-\boldsymbol{x}^{*}\|^2 - \|\boldsymbol{x}_{k+1}-\boldsymbol{x}^{*}\|^2
= \|\boldsymbol{x}_k-\boldsymbol{x}^{*}\|^2 - \Bigl\|\boldsymbol{x}_k - \boldsymbol{x}^{*} - \frac{\boldsymbol{g}_k}{L}\Bigr\|^2
= \frac{2}{L}\langle \boldsymbol{g}_k, \boldsymbol{x}_k-\boldsymbol{x}^{*}\rangle - \frac{1}{L^2}\|\boldsymbol{g}_k\|^2 . ∥ x k − x ∗ ∥ 2 − ∥ x k + 1 − x ∗ ∥ 2 = ∥ x k − x ∗ ∥ 2 − x k − x ∗ − L g k 2 = L 2 ⟨ g k , x k − x ∗ ⟩ − L 2 1 ∥ g k ∥ 2 . 両辺に L / 2 L/2 L /2
f ( x k + 1 ) − f ∗ ≤ L 2 ( ∥ x k − x ∗ ∥ 2 − ∥ x k + 1 − x ∗ ∥ 2 ) . f(\boldsymbol{x}_{k+1}) - f^{*} \le \frac{L}{2}\bigl(\|\boldsymbol{x}_k-\boldsymbol{x}^{*}\|^2 - \|\boldsymbol{x}_{k+1}-\boldsymbol{x}^{*}\|^2\bigr). f ( x k + 1 ) − f ∗ ≤ 2 L ( ∥ x k − x ∗ ∥ 2 − ∥ x k + 1 − x ∗ ∥ 2 ) . ステップ 5(総和と単調性) 。k = 0 , 1 , … , K − 1 k = 0,1,\ldots,K-1 k = 0 , 1 , … , K − 1
∑ k = 1 K ( f ( x k ) − f ∗ ) ≤ L 2 ( ∥ x 0 − x ∗ ∥ 2 − ∥ x K − x ∗ ∥ 2 ) ≤ L 2 ∥ x 0 − x ∗ ∥ 2 . \sum_{k=1}^{K}\bigl(f(\boldsymbol{x}_k)-f^{*}\bigr) \le \frac{L}{2}\bigl(\|\boldsymbol{x}_0-\boldsymbol{x}^{*}\|^2 - \|\boldsymbol{x}_K-\boldsymbol{x}^{*}\|^2\bigr) \le \frac{L}{2}\|\boldsymbol{x}_0-\boldsymbol{x}^{*}\|^2 . k = 1 ∑ K ( f ( x k ) − f ∗ ) ≤ 2 L ( ∥ x 0 − x ∗ ∥ 2 − ∥ x K − x ∗ ∥ 2 ) ≤ 2 L ∥ x 0 − x ∗ ∥ 2 . ステップ 1 の単調性より、左辺の各項は最後の項 f ( x K ) − f ∗ f(\boldsymbol{x}_K)-f^{*} f ( x K ) − f ∗ ≥ K ( f ( x K ) − f ∗ ) \ge K\bigl(f(\boldsymbol{x}_K)-f^{*}\bigr) ≥ K ( f ( x K ) − f ∗ ) K K K
∎ 誤差が O ( 1 / K ) O(1/K) O ( 1/ K )
例 4.4 (1 次元二次関数で学習率の閾値を確かめる )
f ( x ) = a 2 x 2 f(x) = \frac{a}{2}x^2 f ( x ) = 2 a x 2 a > 0 a > 0 a > 0 f ′ ( x ) = a x f'(x) = ax f ′ ( x ) = a x ∣ f ′ ( x ) − f ′ ( y ) ∣ = a ∣ x − y ∣ |f'(x)-f'(y)| = a|x-y| ∣ f ′ ( x ) − f ′ ( y ) ∣ = a ∣ x − y ∣ f f f L = a L = a L = a L L L 定義 4.1 )。勾配降下法は
x k + 1 = x k − η a x k = ( 1 − η a ) x k x_{k+1} = x_k - \eta a x_k = (1-\eta a)x_k x k + 1 = x k − η a x k = ( 1 − η a ) x k なので x k = ( 1 − η a ) k x 0 x_k = (1-\eta a)^k x_0 x k = ( 1 − η a ) k x 0 ∣ 1 − η a ∣ < 1 ⟺ 0 < η < 2 / a = 2 / L |1-\eta a| < 1 \iff 0 < \eta < 2/a = 2/L ∣1 − η a ∣ < 1 ⟺ 0 < η < 2/ a = 2/ L 補題 4.2 の条件と一致します。
具体的に a = 1 a = 1 a = 1 L = 1 L = 1 L = 1 η = 2 \eta = 2 η = 2 x 0 = 1 x_0 = 1 x 0 = 1
η = 1.0 \eta = 1.0 η = 1.0 k ≥ 1 k \ge 1 k ≥ 1 x k = 0 x_k = 0 x k = 0 η = 0.5 \eta = 0.5 η = 0.5 x k = 0.5 k x_k = 0.5^k x k = 0. 5 k x 10 ≈ 9.8 × 10 − 4 x_{10} \approx 9.8\times10^{-4} x 10 ≈ 9.8 × 1 0 − 4 η = 1.9 \eta = 1.9 η = 1.9 x k = ( − 0.9 ) k x_k = (-0.9)^k x k = ( − 0.9 ) k ∣ x 10 ∣ = 0.9 10 ≈ 0.349 |x_{10}| = 0.9^{10}\approx 0.349 ∣ x 10 ∣ = 0. 9 10 ≈ 0.349 η = 2.5 \eta = 2.5 η = 2.5 x k = ( − 1.5 ) k x_k = (-1.5)^k x k = ( − 1.5 ) k ∣ x 10 ∣ = 1.5 10 ≈ 57.7 |x_{10}| = 1.5^{10} \approx 57.7 ∣ x 10 ∣ = 1. 5 10 ≈ 57.7 ∣ x 30 ∣ ≈ 1.9 × 10 5 |x_{30}| \approx 1.9\times10^{5} ∣ x 30 ∣ ≈ 1.9 × 1 0 5 η = 2.5 \eta = 2.5 η = 2.5 f ( x k ) = x k 2 / 2 f(x_k) = x_k^2/2 f ( x k ) = x k 2 /2 inf になり、そこから NaN が伝播します。「学習開始直後に損失が NaN になる」障害の多くは、この単純な力学で説明できます。対処の第一手は学習率を下げること、第二手は勾配クリッピングで実効的な ∥ g k ∥ \|\boldsymbol{g}_k\| ∥ g k ∥
もう一つの柱が連鎖律です。合成関数 f = f T ∘ ⋯ ∘ f 1 f = f_T\circ\cdots\circ f_1 f = f T ∘ ⋯ ∘ f 1
∂ f ∂ x = J T J T − 1 ⋯ J 1 \frac{\partial f}{\partial \boldsymbol{x}} = J_T J_{T-1}\cdots J_1 ∂ x ∂ f = J T J T − 1 ⋯ J 1 になります。この積を右から順に計算するか、左から順に計算するかで、必要な計算量が大きく変わります。損失はスカラーなので、出力側(左)から掛けていけば、常に「行ベクトル × 行列」の計算で済みます。これが逆伝播(backpropagation)であり、パラメータが何億個あっても、勾配の計算コストが順伝播 1 回分の定数倍に収まる理由です。
たとえば各 J t J_t J t 1000 × 1000 1000\times1000 1000 × 1000 J T J_T J T 1 × 1000 1\times1000 1 × 1000 1000 2 1000^2 100 0 2 1000 3 1000^3 100 0 3
x f1 f2 f3 L 順伝播:左から右へ値を計算する(実線) 逆伝播:損失 L から勾配を左へ戻す(破線) 各段で「行ベクトル × ヤコビ行列」だけを計算する 順伝播は入力から出力へ、逆伝播は損失から入力へ向かう ヤコビ行列の積という見方は、勾配消失・勾配爆発の理解にも直結します。各層の J t J_t J t 残差接続 (y = x + F ( x ) \boldsymbol{y} = \boldsymbol{x} + F(\boldsymbol{x}) y = x + F ( x ) I + J F I + J_F I + J F
LLM の出力は、次のトークンについての確率分布です。学習で最小化しているのは、正解分布との交差エントロピーです。
定義 5.1 (交差エントロピーと KL ダイバージェンス ) ↗
有限集合 X \mathcal{X} X p = ( p x ) x ∈ X p = (p_x)_{x\in\mathcal{X}} p = ( p x ) x ∈ X q = ( q x ) x ∈ X q = (q_x)_{x\in\mathcal{X}} q = ( q x ) x ∈ X
H ( p ) = − ∑ x p x log p x , H ( p , q ) = − ∑ x p x log q x , D ( p ∥ q ) = ∑ x p x log p x q x H(p) = -\sum_{x} p_x\log p_x, \qquad
H(p,q) = -\sum_{x} p_x \log q_x, \qquad
D(p\,\|\,q) = \sum_{x} p_x\log\frac{p_x}{q_x} H ( p ) = − x ∑ p x log p x , H ( p , q ) = − x ∑ p x log q x , D ( p ∥ q ) = x ∑ p x log q x p x をそれぞれエントロピー 、交差エントロピー 、KL ダイバージェンス と呼ぶ。p x = 0 p_x = 0 p x = 0 0 0 0 p x > 0 p_x > 0 p x > 0 q x = 0 q_x = 0 q x = 0 D ( p ∥ q ) = + ∞ D(p\|q) = +\infty D ( p ∥ q ) = + ∞ e e e H ( p , q ) = H ( p ) + D ( p ∥ q ) H(p,q) = H(p) + D(p\|q) H ( p , q ) = H ( p ) + D ( p ∥ q )
命題 5.2 (ギブスの不等式 ) ✓
上の記法のもとで、D ( p ∥ q ) ≥ 0 D(p\,\|\,q) \ge 0 D ( p ∥ q ) ≥ 0 p x > 0 p_x > 0 p x > 0 x x x p x = q x p_x = q_x p x = q x H ( p , q ) ≥ H ( p ) H(p,q)\ge H(p) H ( p , q ) ≥ H ( p )
証明(命題 5.2) p x > 0 p_x > 0 p x > 0 x x x q x = 0 q_x = 0 q x = 0 D ( p ∥ q ) = + ∞ > 0 D(p\|q)=+\infty > 0 D ( p ∥ q ) = + ∞ > 0 p x > 0 ⇒ q x > 0 p_x>0 \Rightarrow q_x>0 p x > 0 ⇒ q x > 0 S = { x : p x > 0 } S = \{x : p_x > 0\} S = { x : p x > 0 }
t > 0 t > 0 t > 0 log t ≤ t − 1 \log t \le t - 1 log t ≤ t − 1 ψ ( t ) = t − 1 − log t \psi(t) = t-1-\log t ψ ( t ) = t − 1 − log t ψ ′ ( t ) = 1 − 1 / t \psi'(t) = 1 - 1/t ψ ′ ( t ) = 1 − 1/ t t = 1 t=1 t = 1 ψ ( 1 ) = 0 \psi(1)=0 ψ ( 1 ) = 0 t = 1 t=1 t = 1 t = q x / p x t = q_x/p_x t = q x / p x
− D ( p ∥ q ) = ∑ x ∈ S p x log q x p x ≤ ∑ x ∈ S p x ( q x p x − 1 ) = ∑ x ∈ S q x − ∑ x ∈ S p x ≤ 1 − 1 = 0. -D(p\|q) = \sum_{x\in S} p_x\log\frac{q_x}{p_x} \le \sum_{x\in S} p_x\Bigl(\frac{q_x}{p_x}-1\Bigr) = \sum_{x\in S} q_x - \sum_{x\in S} p_x \le 1 - 1 = 0 . − D ( p ∥ q ) = x ∈ S ∑ p x log p x q x ≤ x ∈ S ∑ p x ( p x q x − 1 ) = x ∈ S ∑ q x − x ∈ S ∑ p x ≤ 1 − 1 = 0. 最後の不等号では ∑ x ∈ S q x ≤ ∑ x ∈ X q x = 1 \sum_{x\in S} q_x \le \sum_{x\in\mathcal{X}} q_x = 1 ∑ x ∈ S q x ≤ ∑ x ∈ X q x = 1 ∑ x ∈ S p x = 1 \sum_{x\in S}p_x = 1 ∑ x ∈ S p x = 1 D ( p ∥ q ) ≥ 0 D(p\|q)\ge 0 D ( p ∥ q ) ≥ 0
等号成立を調べます。等号には二つの不等号が同時に等号になることが必要で、第 1 の不等号の等号条件は各 x ∈ S x\in S x ∈ S q x / p x = 1 q_x/p_x = 1 q x / p x = 1 ∑ x ∉ S q x = 0 \sum_{x\notin S} q_x = 0 ∑ x ∈ / S q x = 0 x ∈ S x\in S x ∈ S p x = q x p_x=q_x p x = q x ∑ x ∈ S q x = 1 \sum_{x\in S}q_x = 1 ∑ x ∈ S q x = 1 D ( p ∥ q ) = 0 D(p\|q)=0 D ( p ∥ q ) = 0 定義 5.1 の等式 H ( p , q ) = H ( p ) + D ( p ∥ q ) H(p,q) = H(p)+D(p\|q) H ( p , q ) = H ( p ) + D ( p ∥ q ) H ( p , q ) ≥ H ( p ) H(p,q)\ge H(p) H ( p , q ) ≥ H ( p )
∎ この命題は、実務的には次の意味を持ちます。交差エントロピーの最小化は、KL ダイバージェンスの最小化と同じ です。H ( p ) H(p) H ( p ) D ( p ∥ q ) D(p\|q) D ( p ∥ q ) H ( p ) H(p) H ( p )
例 5.3 (perplexity を手で計算する )
perplexity は P P L = exp ( 1 N ∑ i = 1 N − log q ( x i ) ) \mathrm{PPL} = \exp\bigl(\frac{1}{N}\sum_{i=1}^{N} -\log q(x_i)\bigr) PPL = exp ( N 1 ∑ i = 1 N − log q ( x i ) ) 0.5 , 0.25 , 0.1 , 0.05 0.5,\ 0.25,\ 0.1,\ 0.05 0.5 , 0.25 , 0.1 , 0.05
− log 0.5 = 0.6931 , − log 0.25 = 1.3863 , − log 0.1 = 2.3026 , − log 0.05 = 2.9957. -\log 0.5 = 0.6931,\quad -\log 0.25 = 1.3863,\quad -\log 0.1 = 2.3026,\quad -\log 0.05 = 2.9957 . − log 0.5 = 0.6931 , − log 0.25 = 1.3863 , − log 0.1 = 2.3026 , − log 0.05 = 2.9957. 和は 7.3777 7.3777 7.3777 1.8444 1.8444 1.8444 P P L = e 1.8444 ≈ 6.32 \mathrm{PPL} = e^{1.8444} \approx 6.32 PPL = e 1.8444 ≈ 6.32
この 6.32 6.32 6.32 V V V − log ( 1 / V ) = log V -\log(1/V) = \log V − log ( 1/ V ) = log V P P L = V \mathrm{PPL} = V PPL = V 実効的な選択肢の数 を表す量だとわかります。損失が 0.1 下がることの意味も、e 0.1 ≈ 1.105 e^{0.1}\approx 1.105 e 0.1 ≈ 1.105
もう一つ、AI システムの評価で必ず必要になるのがベイズの更新則です。
例 5.4 (検知率 99%、誤検知率 1% のモデルが出す警告の信頼度 )
不正取引を検知するモデルを考えます。事前確率(実際に不正である割合)を Pr [ D ] = 0.001 \Pr[D] = 0.001 Pr [ D ] = 0.001 Pr [ + ∣ D ] = 0.99 \Pr[+\mid D] = 0.99 Pr [ + ∣ D ] = 0.99 Pr [ + ∣ ¬ D ] = 0.01 \Pr[+\mid \lnot D] = 0.01 Pr [ + ∣ ¬ D ] = 0.01 Pr [ D ∣ + ] \Pr[D\mid +] Pr [ D ∣ + ]
ベイズの定理より
Pr [ D ∣ + ] = Pr [ + ∣ D ] Pr [ D ] Pr [ + ∣ D ] Pr [ D ] + Pr [ + ∣ ¬ D ] Pr [ ¬ D ] . \Pr[D\mid +] = \frac{\Pr[+\mid D]\Pr[D]}{\Pr[+\mid D]\Pr[D] + \Pr[+\mid\lnot D]\Pr[\lnot D]} . Pr [ D ∣ + ] = Pr [ + ∣ D ] Pr [ D ] + Pr [ + ∣ ¬ D ] Pr [ ¬ D ] Pr [ + ∣ D ] Pr [ D ] . 分子は 0.99 × 0.001 = 0.00099 0.99\times 0.001 = 0.00099 0.99 × 0.001 = 0.00099 0.01 × 0.999 = 0.00999 0.01\times0.999 = 0.00999 0.01 × 0.999 = 0.00999
Pr [ D ∣ + ] = 0.00099 0.00099 + 0.00999 = 0.00099 0.01098 ≈ 0.0902. \Pr[D\mid+] = \frac{0.00099}{0.00099+0.00999} = \frac{0.00099}{0.01098} \approx 0.0902 . Pr [ D ∣ + ] = 0.00099 + 0.00999 0.00099 = 0.01098 0.00099 ≈ 0.0902. すなわち約 9%。警告 11 件のうち本物は 1 件です。現場の「9 割が誤報」という感覚は正しく、モデルの「精度 99%」という報告も(別の意味で)正しい。両者が食い違うのは、事前確率 0.001 0.001 0.001
改善の方向も式が教えてくれます。分母を支配しているのは Pr [ + ∣ ¬ D ] Pr [ ¬ D ] \Pr[+\mid\lnot D]\Pr[\lnot D] Pr [ + ∣ ¬ D ] Pr [ ¬ D ] 0.99 0.99 0.99 0.999 0.999 0.999 0.0909 0.0909 0.0909 0.01 0.01 0.01 0.001 0.001 0.001 Pr [ D ∣ + ] = 0.00099 / ( 0.00099 + 0.000999 ) ≈ 0.498 \Pr[D\mid+] = 0.00099/(0.00099+0.000999) \approx 0.498 Pr [ D ∣ + ] = 0.00099/ ( 0.00099 + 0.000999 ) ≈ 0.498 どの数字を改善すべきか が、この計算だけで決まります。同じ形の比較を、LLM への作業委譲の文脈で行ったのが 偽陽性率と成功率、どちらを改善すべきか(例 7.3)[LLMとプログラミング] です。
ここまでは「AI を理解するための数学」でした。しかし数学を学び直す効用は、内容そのものだけではありません。主張を正確に述べる訓練 が、そのまま仕様記述と障害分析の能力になります(仕様を述べること自体が避けられない情報量を持つ、という見方は 仕様の記述長の下界(命題 6.2)[AI時代のITエンジニアの生存戦略] にまとめました)。
もっとも実利の大きい訓練が、量化子(∀ \forall ∀ ∃ \exists ∃
二つの論理式は、∃ δ \exists\delta ∃ δ ∀ a \forall a ∀ a δ \delta δ a a a δ \delta δ a a a
この構造は、システムの仕様にそのまま現れます。
「すべての リクエストに対し、ある サーバが 200ms 以内に応答する」——リクエストごとに応答するサーバが違ってよい。
「ある サーバが存在し、すべての リクエストに 200ms 以内に応答する」——単一のサーバで全負荷を捌ける。
後者は前者よりはるかに強い主張です。SLA、権限設計(「すべてのユーザにあるロールが割り当てられる」と「あるロールがすべてのユーザに割り当てられる」)、リトライ設計など、量化子の順序を取り違えると設計が壊れる場所は無数にあります。日本語は語順が緩く、両者を同じ文で書けてしまいます。だからこそ、論理式に直して確認する習慣が効きます。
もう一つ、数学が鍛えるのは反例を作る習慣 です。例 6.2 で行ったのは「仮定を一つ落としたら何が壊れるか」を具体的に示す作業でした。この作業は、AI システムの評価設計と同じ形をしています。「このプロンプトはうまく動く」という主張に対し、反例(動かない入力)を系統的に探す。境界値、空入力、極端に長い入力、想定外の言語。LLM の出力に対しては、この反例探しがそのまま もっともらしい誤り(定義 7.1)[LLMとプログラミング] の検出になります。数学の演習で身につく「主張を疑って最小の反例を作る」思考は、そのままテストケース設計になります。
最後に、実務家向けの現実的な道筋を示します。目標は「教科書を通読すること」ではなく、上で見たような計算を自力でできること です。
順序 分野 最低限の到達点 到達を確認する問い 1 線形代数 行列積・ノルム・内積・固有値・特異値分解を計算できる 例 3.9 を見ずに解けるか2 確率統計 条件付き確率・ベイズの定理・期待値と分散・尤度 例 5.4 の改善方針を自分で導けるか3 微分積分 偏微分・勾配・連鎖律・テイラー展開の 2 次まで 補題 4.2 の 2 / L 2/L 2/ L 4 論理・集合 量化子の順序、否定の取り方、反例の構成 定義 6.1 の二つの式の違いを人に説明できるか
順序に理由があります。線形代数が最初なのは、埋め込み・注意機構・低ランク近似という「今日から使える」応用が最も多いからです。確率統計を 2 番目に置いたのは、評価と意思決定に直結し、しかも 例 5.4 のように誤解が高くつくからです。微分積分は学習の内部に踏み込むときに必要になります。論理は最後に置きましたが、実は最初から効いています。
学び方について、判断を一つ添えます。証明を読むだけでなく、手で計算する時間を確保するのがよいでしょう。 例 3.9 の 3 × 2 3\times2 3 × 2
A = np. array ( [[ 1.0 , 1.0 ] ,
U, s, Vt = np.linalg. svd ( A , full_matrices = False )
print ( s ) # [2. 1.41421356]
A1 = s[ 0 ] * np. outer ( U [ :, 0 ] , Vt [ 0 , : ])
print ( np. round ( A1 , 6 )) # [[1. 1.] [1. 1.] [0. 0.]]
print ( np.linalg. norm ( A - A1 )) # 1.41421356... = sigma_2
手計算の結果と一致しました。この「手で解く → コードで検算する」往復が、もっとも定着します。
AI 時代に価値を出し続けるための全体戦略は AI時代のITエンジニアの生存戦略 にまとめました。自動化がどこで頭打ちになるか、その上限を与えるのが 自動化の上限(系 3.2)[AI時代のITエンジニアの生存戦略] です。数学はその中の一本の柱です。モデルを作る人になるためではなく、モデルの出力を疑い、説明し、制御する側に立つため の投資だと考えてください。
演習 8.1 易
d = 768 d = 768 d = 768 u , v \boldsymbol{u},\boldsymbol{v} u , v Pr [ ∣ cos ( u , v ) ∣ ≥ 0.1 ] \Pr[|\cos(\boldsymbol{u},\boldsymbol{v})| \ge 0.1] Pr [ ∣ cos ( u , v ) ∣ ≥ 0.1 ] 定理 3.3 から得られる上界と比較せよ。
解答 単位ベクトルなのでコサイン類似度は内積そのものです。命題 3.2 より分散は 1 / 768 1/768 1/768 1 / 768 ≈ 0.0361 1/\sqrt{768} \approx 0.0361 1/ 768 ≈ 0.0361
チェビシェフの不等式は、平均 0 0 0 σ 2 \sigma^2 σ 2 X X X Pr [ ∣ X ∣ ≥ t ] ≤ σ 2 / t 2 \Pr[|X|\ge t]\le \sigma^2/t^2 Pr [ ∣ X ∣ ≥ t ] ≤ σ 2 / t 2 t = 0.1 t = 0.1 t = 0.1
Pr [ ∣ ⟨ u , v ⟩ ∣ ≥ 0.1 ] ≤ 1 / 768 0.01 = 1 7.68 ≈ 0.130. \Pr[|\langle\boldsymbol{u},\boldsymbol{v}\rangle|\ge 0.1] \le \frac{1/768}{0.01} = \frac{1}{7.68} \approx 0.130 . Pr [ ∣ ⟨ u , v ⟩ ∣ ≥ 0.1 ] ≤ 0.01 1/768 = 7.68 1 ≈ 0.130. 一方 定理 3.3 からは
2 e − 768 × 0.01 / 2 = 2 e − 3.84 ≈ 2 × 0.02147 ≈ 0.0429 2e^{-768\times 0.01/2} = 2e^{-3.84} \approx 2\times 0.02147 \approx 0.0429 2 e − 768 × 0.01/2 = 2 e − 3.84 ≈ 2 × 0.02147 ≈ 0.0429 です。指数型の評価のほうが 3 倍ほど強い上界を与えます。差は t t t t = 0.3 t=0.3 t = 0.3 0.0145 0.0145 0.0145 2 e − 34.56 ≈ 2 × 10 − 15 2e^{-34.56}\approx 2\times10^{-15} 2 e − 34.56 ≈ 2 × 1 0 − 15
演習 8.2 標準
f ( x ) = a 2 x 2 f(x) = \frac{a}{2}x^2 f ( x ) = 2 a x 2 a > 0 a>0 a > 0 η \eta η a a a η \eta η a = 4 a = 4 a = 4 η = 0.1 \eta = 0.1 η = 0.1 ∣ x 10 / x 0 ∣ |x_{10}/x_0| ∣ x 10 / x 0 ∣ a = 4 a = 4 a = 4 η = 0.5 \eta = 0.5 η = 0.5
解答 (1) 例 4.4 と同じ計算です。f ′ ( x ) = a x f'(x) = ax f ′ ( x ) = a x x k + 1 = ( 1 − η a ) x k x_{k+1} = (1-\eta a)x_k x k + 1 = ( 1 − η a ) x k x k = ( 1 − η a ) k x 0 x_k = (1-\eta a)^k x_0 x k = ( 1 − η a ) k x 0 x 0 ≠ 0 x_0\ne0 x 0 = 0 x k → 0 x_k\to0 x k → 0 ∣ 1 − η a ∣ < 1 |1-\eta a| < 1 ∣1 − η a ∣ < 1 0 < η < 2 / a 0 < \eta < 2/a 0 < η < 2/ a f f f L = a L = a L = a L L L 補題 4.2 の 0 < η < 2 / L 0<\eta<2/L 0 < η < 2/ L
(2) 1 − η a = 1 − 0.1 × 4 = 0.6 1-\eta a = 1 - 0.1\times 4 = 0.6 1 − η a = 1 − 0.1 × 4 = 0.6
∣ x 10 x 0 ∣ = 0.6 10 = 0.0060466 … ≈ 6.0 × 10 − 3 . \left|\frac{x_{10}}{x_0}\right| = 0.6^{10} = 0.0060466\ldots \approx 6.0\times10^{-3} . x 0 x 10 = 0. 6 10 = 0.0060466 … ≈ 6.0 × 1 0 − 3 . 損失は f ∝ x 2 f\propto x^2 f ∝ x 2 0.6 20 ≈ 3.66 × 10 − 5 0.6^{20}\approx 3.66\times10^{-5} 0. 6 20 ≈ 3.66 × 1 0 − 5
(3) 1 − η a = 1 − 0.5 × 4 = − 1 1-\eta a = 1 - 0.5\times4 = -1 1 − η a = 1 − 0.5 × 4 = − 1 x k = ( − 1 ) k x 0 x_k = (-1)^k x_0 x k = ( − 1 ) k x 0 η = 2 / a \eta = 2/a η = 2/ a x 0 x_0 x 0 − x 0 -x_0 − x 0 補題 4.2 の減少量の係数 η ( 1 − L η / 2 ) \eta(1-L\eta/2) η ( 1 − L η /2 ) 0.5 × ( 1 − 4 × 0.5 / 2 ) = 0.5 × 0 = 0 0.5\times(1-4\times0.5/2) = 0.5\times 0 = 0 0.5 × ( 1 − 4 × 0.5/2 ) = 0.5 × 0 = 0 0 0 0
演習 8.3 標準
あるモデルの検証損失(平均交差エントロピー、単位は nat)が 2.0 2.0 2.0 50,000 50{,}000 50 , 000 2.0 2.0 2.0 1.9 1.9 1.9
解答 (1) P P L = e 2.0 = 7.389 … ≈ 7.39 \mathrm{PPL} = e^{2.0} = 7.389\ldots \approx 7.39 PPL = e 2.0 = 7.389 … ≈ 7.39
(2) 一様分布では各トークンの確率が 1 / 50000 1/50000 1/50000 − log ( 1 / 50000 ) = log 50000 -\log(1/50000) = \log 50000 − log ( 1/50000 ) = log 50000 log 50000 = log 5 + 4 log 10 = 1.6094 + 9.2103 = 10.8197 \log 50000 = \log 5 + 4\log 10 = 1.6094 + 9.2103 = 10.8197 log 50000 = log 5 + 4 log 10 = 1.6094 + 9.2103 = 10.8197 e 10.8197 = 50000 e^{10.8197} = 50000 e 10.8197 = 50000 定義 5.1 の記法でいえば、これは q q q H ( p , q ) H(p,q) H ( p , q ) 50000 50000 50000 7.39 7.39 7.39
(3) P P L \mathrm{PPL} PPL e 1.9 / e 2.0 = e − 0.1 = 0.9048 e^{1.9}/e^{2.0} = e^{-0.1} = 0.9048 e 1.9 / e 2.0 = e − 0.1 = 0.9048 9.5 % 9.5\% 9.5% Δ \Delta Δ e − Δ e^{-\Delta} e − Δ
演習 8.4 難
X = { 0 , 1 } \mathcal{X}=\{0,1\} X = { 0 , 1 } p = ( 0.5 , 0.5 ) p = (0.5,\,0.5) p = ( 0.5 , 0.5 ) q = ( 0.9 , 0.1 ) q = (0.9,\,0.1) q = ( 0.9 , 0.1 ) D ( p ∥ q ) D(p\|q) D ( p ∥ q ) D ( q ∥ p ) D(q\|p) D ( q ∥ p ) D ( p ∥ q ) D(p\|q) D ( p ∥ q )
解答 (1) 定義 5.1 に従って計算します。
D ( p ∥ q ) = 0.5 log 0.5 0.9 + 0.5 log 0.5 0.1 = 0.5 × ( − 0.5878 ) + 0.5 × 1.6094 = − 0.2939 + 0.8047 = 0.5108. D(p\|q) = 0.5\log\frac{0.5}{0.9} + 0.5\log\frac{0.5}{0.1} = 0.5\times(-0.5878) + 0.5\times 1.6094 = -0.2939+0.8047 = 0.5108 . D ( p ∥ q ) = 0.5 log 0.9 0.5 + 0.5 log 0.1 0.5 = 0.5 × ( − 0.5878 ) + 0.5 × 1.6094 = − 0.2939 + 0.8047 = 0.5108. D ( q ∥ p ) = 0.9 log 0.9 0.5 + 0.1 log 0.1 0.5 = 0.9 × 0.5878 + 0.1 × ( − 1.6094 ) = 0.5290 − 0.1609 = 0.3681. D(q\|p) = 0.9\log\frac{0.9}{0.5} + 0.1\log\frac{0.1}{0.5} = 0.9\times 0.5878 + 0.1\times(-1.6094) = 0.5290 - 0.1609 = 0.3681 . D ( q ∥ p ) = 0.9 log 0.5 0.9 + 0.1 log 0.5 0.1 = 0.9 × 0.5878 + 0.1 × ( − 1.6094 ) = 0.5290 − 0.1609 = 0.3681. 0.5108 ≠ 0.3681 0.5108 \ne 0.3681 0.5108 = 0.3681 命題 5.2 と整合します。
(2) D ( p ∥ q ) = ∑ x p x log ( p x / q x ) D(p\|q) = \sum_x p_x\log(p_x/q_x) D ( p ∥ q ) = ∑ x p x log ( p x / q x ) q q q p x p_x p x q x q_x q x log ( p x / q x ) \log(p_x/q_x) log ( p x / q x ) p x = 0 p_x = 0 p x = 0 q x q_x q x 0 0 0 D ( p ∥ q ) D(p\|q) D ( p ∥ q ) p p p q q q p p p q q q
言語モデルの通常の学習は交差エントロピー H ( p , q ) H(p,q) H ( p , q ) 命題 5.2 で見たとおり H ( p , q ) = H ( p ) + D ( p ∥ q ) H(p,q) = H(p) + D(p\|q) H ( p , q ) = H ( p ) + D ( p ∥ q ) D ( p ∥ q ) D(p\|q) D ( p ∥ q ) D ( q ∥ p ) D(q\|p) D ( q ∥ p ) q q q p p p
G. Strang, Introduction to Linear Algebra , 5th ed., Wellesley-Cambridge Press, 2016 — 第 7 章(特異値分解と低ランク近似)。
G. H. Golub and C. F. Van Loan, Matrix Computations , 4th ed., Johns Hopkins University Press, 2013 — 第 2 章(行列ノルムと最良低ランク近似)。
S. Boyd and L. Vandenberghe, Convex Optimization , Cambridge University Press, 2004 — 第 9 章(無制約最小化と降下法)。全文が著者サイトで公開されています: https://web.stanford.edu/~boyd/cvxbook/
T. M. Cover and J. A. Thomas, Elements of Information Theory , 2nd ed., Wiley, 2006 — 第 2 章(エントロピー、相対エントロピー、相互情報量)。
R. Vershynin, High-Dimensional Probability: An Introduction with Applications in Data Science , Cambridge University Press, 2018 — 第 3 章(球面と高次元分布における測度集中)。
I. Goodfellow, Y. Bengio, and A. Courville, Deep Learning , MIT Press, 2016 — 第 2〜4 章(線形代数・確率論・数値計算の基礎)。オンライン版: https://www.deeplearningbook.org/
E. J. Hu et al., “LoRA: Low-Rank Adaptation of Large Language Models”, arXiv:2106.09685 (2021). https://arxiv.org/abs/2106.09685