霧の中で山を下りるとき、見えるのは足もとの傾きだけです。それでも「いま一番急に下っている向きへ少し進む」ことを繰り返せば、谷底に近づけそうです。機械学習で損失を小さくする学習は、まさにこれをしています。この記事では、その向きがなぜ「一番急」と言えるのか、一歩をどれだけ大きくしてよいのか、データが多いときにどう安く計算するのかを、式と数値例で確かめます。読み終えると、学習率を決める理屈と、学習が遅くなる原因を自分で説明できるようになります。
勾配 ∇ f ( w ) \nabla f(\boldsymbol{w}) ∇ f ( w ) f f f f f f − ∇ f ( w ) / ∥ ∇ f ( w ) ∥ -\nabla f(\boldsymbol{w})/\|\nabla f(\boldsymbol{w})\| − ∇ f ( w ) /∥∇ f ( w ) ∥ 定理 3.2 )。証明の要はコーシー・シュワルツの不等式です。
学習率 η \eta η L L L L L L 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L η = 1 / L \eta = 1/L η = 1/ L T T T min k ∥ ∇ f ( w k ) ∥ 2 ≤ 2 L ( f ( w 0 ) − f ⋆ ) / T \min_k \|\nabla f(\boldsymbol{w}_k)\|^2 \le 2L\bigl(f(\boldsymbol{w}_0) - f_\star\bigr)/T min k ∥∇ f ( w k ) ∥ 2 ≤ 2 L ( f ( w 0 ) − f ⋆ ) / T 定理 4.5 )。
二次関数では収束の速さがヘッセ行列の条件数 κ \kappa κ ( κ − 1 ) / ( κ + 1 ) (\kappa-1)/(\kappa+1) ( κ − 1 ) / ( κ + 1 ) 命題 5.1 )。
ロジスティック回帰の損失は ∇ f ( w ) = 1 N X T ( p − y ) \nabla f(\boldsymbol{w}) = \frac{1}{N}X^{\mathsf{T}}(\boldsymbol{p} - \boldsymbol{y}) ∇ f ( w ) = N 1 X T ( p − y ) 命題 6.1 )。ここから L = λ max ( X T X ) / ( 4 N ) L = \lambda_{\max}(X^{\mathsf{T}}X)/(4N) L = λ m a x ( X T X ) / ( 4 N )
確率的勾配降下法は、この勾配を B B B 1 / B 1/B 1/ B 命題 7.2 )。「安いが揺れる勾配」を大量に使うという発想が、大規模学習を成り立たせています。
ロジスティック回帰 : 二値の正解を、シグモイド関数で確率に直して予測する手法。§1 と §6 の題材です。→ ロジスティック回帰 シグモイド関数 : 任意の実数を 0 と 1 の間の値に押し込む関数 1 / ( 1 + e − z ) 1/(1+e^{-z}) 1/ ( 1 + e − z ) シグモイド関数 交差エントロピー誤差 : 予測確率と正解のずれを測る損失で、負の対数尤度にあたります。→ 交差エントロピー誤差 凸関数 : グラフ上の 2 点を結ぶ線分が、グラフより下に来ない関数。極小点が最小点になります。→ 凸関数 ヘッセ行列と半正定値 : ヘッセ行列は 2 階の偏微分を並べた正方行列で、曲がり具合を表します。対称行列 H H H v \boldsymbol{v} v ⟨ v , H v ⟩ ≥ 0 \langle \boldsymbol{v}, H\boldsymbol{v}\rangle \ge 0 ⟨ v , H v ⟩ ≥ 0 不偏性 : 推定量の期待値が、推定したい値にちょうど一致すること。 線形回帰と最小二乗法 では、二乗誤差 f ( w ) = 1 2 ∥ X w − y ∥ 2 f(\boldsymbol{w}) = \frac{1}{2}\|X\boldsymbol{w} - \boldsymbol{y}\|^2 f ( w ) = 2 1 ∥ X w − y ∥ 2 w \boldsymbol{w} w 正規方程式(定理 3.3)[線形回帰と最小二乗法] X T X w = X T y X^{\mathsf{T}}X\boldsymbol{w} = X^{\mathsf{T}}\boldsymbol{y} X T X w = X T y X T X X^{\mathsf{T}}X X T X w ⋆ = ( X T X ) − 1 X T y \boldsymbol{w}_\star = (X^{\mathsf{T}}X)^{-1}X^{\mathsf{T}}\boldsymbol{y} w ⋆ = ( X T X ) − 1 X T y
ロジスティック回帰 では事情が変わります。負の対数尤度を最小にする条件は
∑ i = 1 N ( σ ( ⟨ w , x i ⟩ ) − y i ) x i = 0 , σ ( z ) = 1 1 + e − z \sum_{i=1}^{N}\Bigl(\sigma(\langle \boldsymbol{w}, \boldsymbol{x}_i\rangle) - y_i\Bigr)\boldsymbol{x}_i = \boldsymbol{0},
\qquad \sigma(z) = \frac{1}{1 + e^{-z}} i = 1 ∑ N ( σ (⟨ w , x i ⟩) − y i ) x i = 0 , σ ( z ) = 1 + e − z 1 でした(交差エントロピー誤差の勾配(定理 5.1)[ロジスティック回帰] )。左辺には未知数 w \boldsymbol{w} w w \boldsymbol{w} w N = 3 N = 3 N = 3
では諦めるのかというと、そうではありません。方針を変えます。一発で答えを当てるのをやめて、今いる点より少しだけ良い点へ動くことを繰り返す のです。この発想は 1847 年にコーシーが連立方程式の数値解法として書いた短い論文にすでに現れています。彼は「関数 u u u u u u
現代の深層学習でも、事情は本質的に同じです。ニューラルネットワークの損失関数は数百万個のパラメータについて非線形で、停留点の条件を解くことなど到底できません。できるのは「今の点での勾配を計算し、その逆向きに少し動く」ことだけです。したがってこの章の問いは次の二つに絞られます。
なぜ勾配の逆向き なのか。他の向きではいけないのか。
どれだけ 動けばよいのか。動きすぎるとどうなるのか。
以下ではこの二つに、多変数関数のテイラー展開(定理 9.10[多変数関数の微分と偏微分] )を使って正面から答えます。
多変数関数の微分については多変数関数の微分と偏微分 で扱っており、全微分可能性は 定義 4.1[多変数関数の微分と偏微分] で定義しました。ここではこの章で使う形に整理し直しておきます。鍵は「偏微分を並べたもの」ではなく「1 次近似の係数」として勾配を捉えることです。
定義 2.1 (全微分可能性と勾配 ) ↗
U ⊂ R n U \subset \mathbb{R}^n U ⊂ R n f : U → R f : U \to \mathbb{R} f : U → R w ∈ U \boldsymbol{w} \in U w ∈ U g ∈ R n \boldsymbol{g} \in \mathbb{R}^n g ∈ R n
f ( w + h ) = f ( w ) + ⟨ g , h ⟩ + r ( h ) , lim h → 0 r ( h ) ∥ h ∥ = 0 f(\boldsymbol{w} + \boldsymbol{h}) = f(\boldsymbol{w}) + \langle \boldsymbol{g}, \boldsymbol{h}\rangle + r(\boldsymbol{h}),
\qquad \lim_{\boldsymbol{h}\to\boldsymbol{0}}\frac{r(\boldsymbol{h})}{\|\boldsymbol{h}\|} = 0 f ( w + h ) = f ( w ) + ⟨ g , h ⟩ + r ( h ) , h → 0 lim ∥ h ∥ r ( h ) = 0 が成り立つとき、f f f w \boldsymbol{w} w 全微分可能 であるといい、g \boldsymbol{g} g f f f w \boldsymbol{w} w 勾配 と呼んで ∇ f ( w ) \nabla f(\boldsymbol{w}) ∇ f ( w ) ⟨ ⋅ , ⋅ ⟩ \langle \cdot,\cdot\rangle ⟨ ⋅ , ⋅ ⟩ R n \mathbb{R}^n R n ∥ ⋅ ∥ \|\cdot\| ∥ ⋅ ∥
このとき g \boldsymbol{g} g j j j ∂ f / ∂ w j ( w ) \partial f/\partial w_j(\boldsymbol{w}) ∂ f / ∂ w j ( w )
∇ f ( w ) = ( ∂ f ∂ w 1 ( w ) , … , ∂ f ∂ w n ( w ) ) T . \nabla f(\boldsymbol{w}) = \left(\frac{\partial f}{\partial w_1}(\boldsymbol{w}),\ \ldots,\ \frac{\partial f}{\partial w_n}(\boldsymbol{w})\right)^{\mathsf{T}}. ∇ f ( w ) = ( ∂ w 1 ∂ f ( w ) , … , ∂ w n ∂ f ( w ) ) T . 「1 次近似の係数」という読み方を強調しておきます。定義 2.1 が言っているのは、w \boldsymbol{w} w
f ( w + h ) ≈ f ( w ) + ⟨ ∇ f ( w ) , h ⟩ f(\boldsymbol{w} + \boldsymbol{h}) \approx f(\boldsymbol{w}) + \langle \nabla f(\boldsymbol{w}), \boldsymbol{h}\rangle f ( w + h ) ≈ f ( w ) + ⟨ ∇ f ( w ) , h ⟩ という線形 の式で f f f ∥ h ∥ \|\boldsymbol{h}\| ∥ h ∥ 0 0 0
定義 2.3 (方向微分 ) ↗
u ∈ R n \boldsymbol{u} \in \mathbb{R}^n u ∈ R n ∥ u ∥ = 1 \|\boldsymbol{u}\| = 1 ∥ u ∥ = 1
D u f ( w ) = lim t → 0 f ( w + t u ) − f ( w ) t D_{\boldsymbol{u}}f(\boldsymbol{w}) = \lim_{t \to 0}\frac{f(\boldsymbol{w} + t\boldsymbol{u}) - f(\boldsymbol{w})}{t} D u f ( w ) = t → 0 lim t f ( w + t u ) − f ( w ) が存在するとき、これを f f f w \boldsymbol{w} w u \boldsymbol{u} u 方向微分 と呼びます。「u \boldsymbol{u} u f f f
例 2.4 (二乗誤差の勾配を定義から求める )
X ∈ R N × n X \in \mathbb{R}^{N\times n} X ∈ R N × n y ∈ R N \boldsymbol{y}\in\mathbb{R}^N y ∈ R N f ( w ) = 1 2 ∥ X w − y ∥ 2 f(\boldsymbol{w}) = \frac{1}{2}\|X\boldsymbol{w} - \boldsymbol{y}\|^2 f ( w ) = 2 1 ∥ X w − y ∥ 2 定義 2.1 の形に整理して勾配を読み取ります。
r = X w − y \boldsymbol{r} = X\boldsymbol{w} - \boldsymbol{y} r = X w − y X ( w + h ) − y = r + X h X(\boldsymbol{w}+\boldsymbol{h}) - \boldsymbol{y} = \boldsymbol{r} + X\boldsymbol{h} X ( w + h ) − y = r + X h
f ( w + h ) = 1 2 ⟨ r + X h , r + X h ⟩ = 1 2 ∥ r ∥ 2 + ⟨ r , X h ⟩ + 1 2 ∥ X h ∥ 2 = f ( w ) + ⟨ X T r , h ⟩ + 1 2 ∥ X h ∥ 2 . \begin{aligned}
f(\boldsymbol{w}+\boldsymbol{h})
&= \tfrac{1}{2}\langle \boldsymbol{r} + X\boldsymbol{h},\ \boldsymbol{r} + X\boldsymbol{h}\rangle \\
&= \tfrac{1}{2}\|\boldsymbol{r}\|^2 + \langle \boldsymbol{r}, X\boldsymbol{h}\rangle + \tfrac{1}{2}\|X\boldsymbol{h}\|^2 \\
&= f(\boldsymbol{w}) + \langle X^{\mathsf{T}}\boldsymbol{r},\ \boldsymbol{h}\rangle + \tfrac{1}{2}\|X\boldsymbol{h}\|^2.
\end{aligned} f ( w + h ) = 2 1 ⟨ r + X h , r + X h ⟩ = 2 1 ∥ r ∥ 2 + ⟨ r , X h ⟩ + 2 1 ∥ X h ∥ 2 = f ( w ) + ⟨ X T r , h ⟩ + 2 1 ∥ X h ∥ 2 . 3 行目では内積の随伴の性質 ⟨ a , X h ⟩ = ⟨ X T a , h ⟩ \langle \boldsymbol{a}, X\boldsymbol{h}\rangle = \langle X^{\mathsf{T}}\boldsymbol{a}, \boldsymbol{h}\rangle ⟨ a , X h ⟩ = ⟨ X T a , h ⟩ 内積空間 を参照)。最後の項は作用素ノルム ∥ X ∥ 2 \|X\|_2 ∥ X ∥ 2 1 2 ∥ X h ∥ 2 ≤ 1 2 ∥ X ∥ 2 2 ∥ h ∥ 2 \frac{1}{2}\|X\boldsymbol{h}\|^2 \le \frac{1}{2}\|X\|_2^2\|\boldsymbol{h}\|^2 2 1 ∥ X h ∥ 2 ≤ 2 1 ∥ X ∥ 2 2 ∥ h ∥ 2
1 2 ∥ X h ∥ 2 ∥ h ∥ ≤ 1 2 ∥ X ∥ 2 2 ∥ h ∥ ⟶ 0 ( h → 0 ) \frac{\frac{1}{2}\|X\boldsymbol{h}\|^2}{\|\boldsymbol{h}\|} \le \frac{1}{2}\|X\|_2^2\,\|\boldsymbol{h}\| \longrightarrow 0 \quad (\boldsymbol{h}\to\boldsymbol{0}) ∥ h ∥ 2 1 ∥ X h ∥ 2 ≤ 2 1 ∥ X ∥ 2 2 ∥ h ∥ ⟶ 0 ( h → 0 ) となり、確かに o ( ∥ h ∥ ) o(\|\boldsymbol{h}\|) o ( ∥ h ∥ ) 定義 2.1 の g \boldsymbol{g} g X T r X^{\mathsf{T}}\boldsymbol{r} X T r
∇ f ( w ) = X T ( X w − y ) = X T X w − X T y . \nabla f(\boldsymbol{w}) = X^{\mathsf{T}}(X\boldsymbol{w} - \boldsymbol{y}) = X^{\mathsf{T}}X\boldsymbol{w} - X^{\mathsf{T}}\boldsymbol{y}. ∇ f ( w ) = X T ( X w − y ) = X T X w − X T y . これを 0 \boldsymbol{0} 0 w \boldsymbol{w} w 一次式 だったからだ、と言い直せます。
「勾配は最も急な坂の方向を指す」という言い方をよく聞きます。これは比喩ではなく、証明できる主張です。まず方向微分と勾配を結びつけます。
命題 3.1 (方向微分は勾配との内積 ) ✓
f f f w \boldsymbol{w} w u \boldsymbol{u} u D u f ( w ) D_{\boldsymbol{u}}f(\boldsymbol{w}) D u f ( w )
D u f ( w ) = ⟨ ∇ f ( w ) , u ⟩ D_{\boldsymbol{u}}f(\boldsymbol{w}) = \langle \nabla f(\boldsymbol{w}), \boldsymbol{u}\rangle D u f ( w ) = ⟨ ∇ f ( w ) , u ⟩ が成り立ちます。
証明(命題 3.1) 定義 2.1 の式で h = t u \boldsymbol{h} = t\boldsymbol{u} h = t u t ≠ 0 t \ne 0 t = 0
f ( w + t u ) − f ( w ) = ⟨ ∇ f ( w ) , t u ⟩ + r ( t u ) = t ⟨ ∇ f ( w ) , u ⟩ + r ( t u ) f(\boldsymbol{w} + t\boldsymbol{u}) - f(\boldsymbol{w}) = \langle \nabla f(\boldsymbol{w}), t\boldsymbol{u}\rangle + r(t\boldsymbol{u}) = t\,\langle \nabla f(\boldsymbol{w}), \boldsymbol{u}\rangle + r(t\boldsymbol{u}) f ( w + t u ) − f ( w ) = ⟨ ∇ f ( w ) , t u ⟩ + r ( t u ) = t ⟨ ∇ f ( w ) , u ⟩ + r ( t u ) です(内積の双線形性を使いました)。両辺を t t t
f ( w + t u ) − f ( w ) t = ⟨ ∇ f ( w ) , u ⟩ + r ( t u ) t . \frac{f(\boldsymbol{w} + t\boldsymbol{u}) - f(\boldsymbol{w})}{t} = \langle \nabla f(\boldsymbol{w}), \boldsymbol{u}\rangle + \frac{r(t\boldsymbol{u})}{t}. t f ( w + t u ) − f ( w ) = ⟨ ∇ f ( w ) , u ⟩ + t r ( t u ) . ここで ∥ t u ∥ = ∣ t ∣ ∥ u ∥ = ∣ t ∣ \|t\boldsymbol{u}\| = |t|\,\|\boldsymbol{u}\| = |t| ∥ t u ∥ = ∣ t ∣ ∥ u ∥ = ∣ t ∣
∣ r ( t u ) t ∣ = ∣ r ( t u ) ∣ ∥ t u ∥ \left|\frac{r(t\boldsymbol{u})}{t}\right| = \frac{|r(t\boldsymbol{u})|}{\|t\boldsymbol{u}\|} t r ( t u ) = ∥ t u ∥ ∣ r ( t u ) ∣ であり、定義 2.1 の剰余条件よりこれは t → 0 t \to 0 t → 0 0 0 0 t → 0 t\to 0 t → 0 ⟨ ∇ f ( w ) , u ⟩ \langle \nabla f(\boldsymbol{w}), \boldsymbol{u}\rangle ⟨ ∇ f ( w ) , u ⟩ D u f ( w ) D_{\boldsymbol{u}}f(\boldsymbol{w}) D u f ( w )
∎ 命題 3.1 によって、「どの向きに進むと f f f u \boldsymbol{u} u ⟨ ∇ f ( w ) , u ⟩ \langle \nabla f(\boldsymbol{w}), \boldsymbol{u}\rangle ⟨ ∇ f ( w ) , u ⟩
次の定理の証明は、0 ≤ ∥ α u + a ∥ 2 0 \le \|\alpha\boldsymbol{u}+\boldsymbol{a}\|^2 0 ≤ ∥ α u + a ∥ 2 α u \alpha\boldsymbol{u} α u a \boldsymbol{a} a 0 0 0
定理 3.2 (最急降下方向 ) ✓
f f f w \boldsymbol{w} w ∇ f ( w ) ≠ 0 \nabla f(\boldsymbol{w}) \ne \boldsymbol{0} ∇ f ( w ) = 0 u \boldsymbol{u} u R n \mathbb{R}^n R n
D u f ( w ) ≥ − ∥ ∇ f ( w ) ∥ D_{\boldsymbol{u}}f(\boldsymbol{w}) \ \ge\ -\|\nabla f(\boldsymbol{w})\| D u f ( w ) ≥ − ∥∇ f ( w ) ∥ が常に成り立ち、等号が成立するのは
u = − ∇ f ( w ) ∥ ∇ f ( w ) ∥ \boldsymbol{u} = -\frac{\nabla f(\boldsymbol{w})}{\|\nabla f(\boldsymbol{w})\|} u = − ∥∇ f ( w ) ∥ ∇ f ( w ) のとき、かつそのときに限ります。すなわち f f f D u f ( w ) ≤ ∥ ∇ f ( w ) ∥ D_{\boldsymbol{u}}f(\boldsymbol{w}) \le \|\nabla f(\boldsymbol{w})\| D u f ( w ) ≤ ∥∇ f ( w ) ∥ u = ∇ f ( w ) / ∥ ∇ f ( w ) ∥ \boldsymbol{u} = \nabla f(\boldsymbol{w})/\|\nabla f(\boldsymbol{w})\| u = ∇ f ( w ) /∥∇ f ( w ) ∥
証明(定理 3.2) a = ∇ f ( w ) \boldsymbol{a} = \nabla f(\boldsymbol{w}) a = ∇ f ( w ) α = ∥ a ∥ > 0 \alpha = \|\boldsymbol{a}\| > 0 α = ∥ a ∥ > 0 ∥ u ∥ = 1 \|\boldsymbol{u}\| = 1 ∥ u ∥ = 1 u \boldsymbol{u} u
0 ≤ ∥ α u + a ∥ 2 = α 2 ∥ u ∥ 2 + 2 α ⟨ u , a ⟩ + ∥ a ∥ 2 = 2 α 2 + 2 α ⟨ a , u ⟩ 0 \le \bigl\| \alpha\boldsymbol{u} + \boldsymbol{a} \bigr\|^2
= \alpha^2\|\boldsymbol{u}\|^2 + 2\alpha\langle \boldsymbol{u}, \boldsymbol{a}\rangle + \|\boldsymbol{a}\|^2
= 2\alpha^2 + 2\alpha\,\langle \boldsymbol{a}, \boldsymbol{u}\rangle 0 ≤ α u + a 2 = α 2 ∥ u ∥ 2 + 2 α ⟨ u , a ⟩ + ∥ a ∥ 2 = 2 α 2 + 2 α ⟨ a , u ⟩ が成り立ちます(∥ u ∥ = 1 \|\boldsymbol{u}\|=1 ∥ u ∥ = 1 ∥ a ∥ = α \|\boldsymbol{a}\|=\alpha ∥ a ∥ = α 2 α > 0 2\alpha > 0 2 α > 0
⟨ a , u ⟩ ≥ − α = − ∥ ∇ f ( w ) ∥ . \langle \boldsymbol{a}, \boldsymbol{u}\rangle \ge -\alpha = -\|\nabla f(\boldsymbol{w})\|. ⟨ a , u ⟩ ≥ − α = − ∥∇ f ( w ) ∥. 命題 3.1 より左辺は D u f ( w ) D_{\boldsymbol{u}}f(\boldsymbol{w}) D u f ( w )
等号成立を調べます。上の計算で等号が成り立つのは ∥ α u + a ∥ 2 = 0 \|\alpha\boldsymbol{u} + \boldsymbol{a}\|^2 = 0 ∥ α u + a ∥ 2 = 0 α u + a = 0 \alpha\boldsymbol{u} + \boldsymbol{a} = \boldsymbol{0} α u + a = 0 0 0 0 u = − a / α \boldsymbol{u} = -\boldsymbol{a}/\alpha u = − a / α u \boldsymbol{u} u ∥ u ∥ = ∥ a ∥ / α = 1 \|\boldsymbol{u}\| = \|\boldsymbol{a}\|/\alpha = 1 ∥ u ∥ = ∥ a ∥/ α = 1
⟨ a , − a / α ⟩ = − ∥ a ∥ 2 α = − α \langle \boldsymbol{a}, -\boldsymbol{a}/\alpha\rangle = -\frac{\|\boldsymbol{a}\|^2}{\alpha} = -\alpha ⟨ a , − a / α ⟩ = − α ∥ a ∥ 2 = − α なので実際に等号を与えます。上界の主張は u \boldsymbol{u} u − u -\boldsymbol{u} − u
∎ 定理 3.2 の証明で使ったのはコーシー・シュワルツの不等式の等号条件そのものです(∥ α u + a ∥ 2 ≥ 0 \|\alpha\boldsymbol{u}+\boldsymbol{a}\|^2 \ge 0 ∥ α u + a ∥ 2 ≥ 0 内積が最大になるのはベクトルが平行なとき という事実に尽きます。
系 3.3 (勾配は等高線に直交する ) ✓
f f f w \boldsymbol{w} w ∇ f ( w ) ≠ 0 \nabla f(\boldsymbol{w}) \ne \boldsymbol{0} ∇ f ( w ) = 0 u \boldsymbol{u} u ⟨ ∇ f ( w ) , u ⟩ = 0 \langle \nabla f(\boldsymbol{w}), \boldsymbol{u}\rangle = 0 ⟨ ∇ f ( w ) , u ⟩ = 0 u ⊥ ∇ f ( w ) \boldsymbol{u} \perp \nabla f(\boldsymbol{w}) u ⊥ ∇ f ( w ) D u f ( w ) = 0 D_{\boldsymbol{u}}f(\boldsymbol{w}) = 0 D u f ( w ) = 0
証明(系 3.3) 命題 3.1 より D u f ( w ) = ⟨ ∇ f ( w ) , u ⟩ D_{\boldsymbol{u}}f(\boldsymbol{w}) = \langle \nabla f(\boldsymbol{w}), \boldsymbol{u}\rangle D u f ( w ) = ⟨ ∇ f ( w ) , u ⟩ 0 0 0 0 0 0
∎ D u f ( w ) = 0 D_{\boldsymbol{u}}f(\boldsymbol{w}) = 0 D u f ( w ) = 0 f f f f f f 系 3.3 は、勾配が等高線と直交することを意味します。後で描く図では、この直交性が重要な役割を果たします。
方向が決まったので、次は歩幅です。
定義 4.1 (勾配降下法 ) ↗
f : R n → R f : \mathbb{R}^n \to \mathbb{R} f : R n → R C 1 C^1 C 1 w 0 ∈ R n \boldsymbol{w}_0 \in \mathbb{R}^n w 0 ∈ R n ( η k ) k ≥ 0 (\eta_k)_{k\ge 0} ( η k ) k ≥ 0
w k + 1 = w k − η k ∇ f ( w k ) ( k = 0 , 1 , 2 , … ) \boldsymbol{w}_{k+1} = \boldsymbol{w}_k - \eta_k \nabla f(\boldsymbol{w}_k) \qquad (k = 0, 1, 2, \ldots) w k + 1 = w k − η k ∇ f ( w k ) ( k = 0 , 1 , 2 , … ) で定まる点列 ( w k ) (\boldsymbol{w}_k) ( w k ) 勾配降下法 (最急降下法)と呼び、η k \eta_k η k 学習率 (ステップ幅)と呼びます。η k = η \eta_k = \eta η k = η k k k
勾配降下法の 1 反復 定理 3.2 が保証しているのは「向きが正しい」ことだけで、η \eta η t → 0 t \to 0 t → 0 η \eta η
定義 4.2 (L-平滑(勾配のリプシッツ連続性) ) ↗
f : R n → R f : \mathbb{R}^n \to \mathbb{R} f : R n → R C 1 C^1 C 1 L > 0 L > 0 L > 0
∥ ∇ f ( u ) − ∇ f ( v ) ∥ ≤ L ∥ u − v ∥ ( ∀ u , v ∈ R n ) \|\nabla f(\boldsymbol{u}) - \nabla f(\boldsymbol{v})\| \le L\,\|\boldsymbol{u} - \boldsymbol{v}\|
\qquad (\forall\, \boldsymbol{u}, \boldsymbol{v} \in \mathbb{R}^n) ∥∇ f ( u ) − ∇ f ( v ) ∥ ≤ L ∥ u − v ∥ ( ∀ u , v ∈ R n ) が成り立つとき、f f f L L L L L L
L L L L L L L L L
補題の証明の方針は次のとおりです。u \boldsymbol{u} u v \boldsymbol{v} v f f f ∇ f ( u ) \nabla f(\boldsymbol{u}) ∇ f ( u ) L L L
補題 4.3 (降下補題 ) ✓
f : R n → R f : \mathbb{R}^n \to \mathbb{R} f : R n → R C 1 C^1 C 1 L L L u , v ∈ R n \boldsymbol{u}, \boldsymbol{v} \in \mathbb{R}^n u , v ∈ R n
f ( v ) ≤ f ( u ) + ⟨ ∇ f ( u ) , v − u ⟩ + L 2 ∥ v − u ∥ 2 f(\boldsymbol{v}) \le f(\boldsymbol{u}) + \langle \nabla f(\boldsymbol{u}),\ \boldsymbol{v} - \boldsymbol{u}\rangle + \frac{L}{2}\|\boldsymbol{v} - \boldsymbol{u}\|^2 f ( v ) ≤ f ( u ) + ⟨ ∇ f ( u ) , v − u ⟩ + 2 L ∥ v − u ∥ 2 が成り立ちます。
証明(補題 4.3) d = v − u \boldsymbol{d} = \boldsymbol{v} - \boldsymbol{u} d = v − u φ ( t ) = f ( u + t d ) \varphi(t) = f(\boldsymbol{u} + t\boldsymbol{d}) φ ( t ) = f ( u + t d ) t ∈ [ 0 , 1 ] t \in [0,1] t ∈ [ 0 , 1 ] f f f C 1 C^1 C 1 t ↦ u + t d t \mapsto \boldsymbol{u}+t\boldsymbol{d} t ↦ u + t d φ \varphi φ [ 0 , 1 ] [0,1] [ 0 , 1 ] C 1 C^1 C 1
φ ′ ( t ) = ⟨ ∇ f ( u + t d ) , d ⟩ . \varphi'(t) = \langle \nabla f(\boldsymbol{u} + t\boldsymbol{d}),\ \boldsymbol{d}\rangle . φ ′ ( t ) = ⟨ ∇ f ( u + t d ) , d ⟩ . 微分積分学の基本定理(積分の基本定理 )を φ \varphi φ
f ( v ) − f ( u ) = φ ( 1 ) − φ ( 0 ) = ∫ 0 1 ⟨ ∇ f ( u + t d ) , d ⟩ d t . f(\boldsymbol{v}) - f(\boldsymbol{u}) = \varphi(1) - \varphi(0) = \int_0^1 \langle \nabla f(\boldsymbol{u} + t\boldsymbol{d}),\ \boldsymbol{d}\rangle \,dt . f ( v ) − f ( u ) = φ ( 1 ) − φ ( 0 ) = ∫ 0 1 ⟨ ∇ f ( u + t d ) , d ⟩ d t . ここから 1 次近似の分 ⟨ ∇ f ( u ) , d ⟩ = ∫ 0 1 ⟨ ∇ f ( u ) , d ⟩ d t \langle \nabla f(\boldsymbol{u}), \boldsymbol{d}\rangle = \int_0^1 \langle \nabla f(\boldsymbol{u}), \boldsymbol{d}\rangle\,dt ⟨ ∇ f ( u ) , d ⟩ = ∫ 0 1 ⟨ ∇ f ( u ) , d ⟩ d t
f ( v ) − f ( u ) − ⟨ ∇ f ( u ) , d ⟩ = ∫ 0 1 ⟨ ∇ f ( u + t d ) − ∇ f ( u ) , d ⟩ d t . f(\boldsymbol{v}) - f(\boldsymbol{u}) - \langle \nabla f(\boldsymbol{u}), \boldsymbol{d}\rangle
= \int_0^1 \bigl\langle \nabla f(\boldsymbol{u} + t\boldsymbol{d}) - \nabla f(\boldsymbol{u}),\ \boldsymbol{d}\bigr\rangle\,dt . f ( v ) − f ( u ) − ⟨ ∇ f ( u ) , d ⟩ = ∫ 0 1 ⟨ ∇ f ( u + t d ) − ∇ f ( u ) , d ⟩ d t . 被積分関数をコーシー・シュワルツの不等式で押さえ、続いて 定義 4.2 の L L L u + t d \boldsymbol{u}+t\boldsymbol{d} u + t d u \boldsymbol{u} u ∥ ( u + t d ) − u ∥ = t ∥ d ∥ \|(\boldsymbol{u}+t\boldsymbol{d}) - \boldsymbol{u}\| = t\|\boldsymbol{d}\| ∥ ( u + t d ) − u ∥ = t ∥ d ∥ t ≥ 0 t \ge 0 t ≥ 0
⟨ ∇ f ( u + t d ) − ∇ f ( u ) , d ⟩ ≤ ∥ ∇ f ( u + t d ) − ∇ f ( u ) ∥ ∥ d ∥ ≤ L t ∥ d ∥ 2 . \bigl\langle \nabla f(\boldsymbol{u} + t\boldsymbol{d}) - \nabla f(\boldsymbol{u}),\ \boldsymbol{d}\bigr\rangle
\le \bigl\|\nabla f(\boldsymbol{u} + t\boldsymbol{d}) - \nabla f(\boldsymbol{u})\bigr\|\,\|\boldsymbol{d}\|
\le L t \|\boldsymbol{d}\|^2 . ⟨ ∇ f ( u + t d ) − ∇ f ( u ) , d ⟩ ≤ ∇ f ( u + t d ) − ∇ f ( u ) ∥ d ∥ ≤ L t ∥ d ∥ 2 . これを積分すると
∫ 0 1 L t ∥ d ∥ 2 d t = L ∥ d ∥ 2 ∫ 0 1 t d t = L 2 ∥ d ∥ 2 \int_0^1 L t\|\boldsymbol{d}\|^2\,dt = L\|\boldsymbol{d}\|^2 \int_0^1 t\,dt = \frac{L}{2}\|\boldsymbol{d}\|^2 ∫ 0 1 L t ∥ d ∥ 2 d t = L ∥ d ∥ 2 ∫ 0 1 t d t = 2 L ∥ d ∥ 2 となり、主張の不等式が得られます。
∎ 補題 4.3 は「f f f L 2 ∥ d ∥ 2 \frac{L}{2}\|\boldsymbol{d}\|^2 2 L ∥ d ∥ 2 平均値の定理とテイラーの定理 の 定理 5.3[平均値の定理とテイラーの定理] )の 2 次の剰余項を、2 階微分の存在を仮定せずに L L L
系 4.4 (1 ステップの減少量 ) ✓
f f f C 1 C^1 C 1 L L L w ′ = w − η ∇ f ( w ) \boldsymbol{w}' = \boldsymbol{w} - \eta\nabla f(\boldsymbol{w}) w ′ = w − η ∇ f ( w )
f ( w ′ ) ≤ f ( w ) − η ( 1 − L η 2 ) ∥ ∇ f ( w ) ∥ 2 f(\boldsymbol{w}') \le f(\boldsymbol{w}) - \eta\left(1 - \frac{L\eta}{2}\right)\bigl\|\nabla f(\boldsymbol{w})\bigr\|^2 f ( w ′ ) ≤ f ( w ) − η ( 1 − 2 L η ) ∇ f ( w ) 2 が成り立ちます。とくに ∇ f ( w ) ≠ 0 \nabla f(\boldsymbol{w}) \ne \boldsymbol{0} ∇ f ( w ) = 0 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L f ( w ′ ) < f ( w ) f(\boldsymbol{w}') < f(\boldsymbol{w}) f ( w ′ ) < f ( w ) η ( 1 − L η / 2 ) ∥ ∇ f ( w ) ∥ 2 \eta(1 - L\eta/2)\|\nabla f(\boldsymbol{w})\|^2 η ( 1 − L η /2 ) ∥∇ f ( w ) ∥ 2 η = 1 / L \eta = 1/L η = 1/ L 1 2 L ∥ ∇ f ( w ) ∥ 2 \dfrac{1}{2L}\|\nabla f(\boldsymbol{w})\|^2 2 L 1 ∥∇ f ( w ) ∥ 2
証明(系 4.4) 補題 4.3 で u = w \boldsymbol{u} = \boldsymbol{w} u = w v = w ′ = w − η ∇ f ( w ) \boldsymbol{v} = \boldsymbol{w}' = \boldsymbol{w} - \eta\nabla f(\boldsymbol{w}) v = w ′ = w − η ∇ f ( w ) v − u = − η ∇ f ( w ) \boldsymbol{v} - \boldsymbol{u} = -\eta\nabla f(\boldsymbol{w}) v − u = − η ∇ f ( w )
⟨ ∇ f ( w ) , v − u ⟩ = − η ∥ ∇ f ( w ) ∥ 2 , L 2 ∥ v − u ∥ 2 = L η 2 2 ∥ ∇ f ( w ) ∥ 2 \langle \nabla f(\boldsymbol{w}), \boldsymbol{v}-\boldsymbol{u}\rangle = -\eta\|\nabla f(\boldsymbol{w})\|^2,
\qquad
\frac{L}{2}\|\boldsymbol{v}-\boldsymbol{u}\|^2 = \frac{L\eta^2}{2}\|\nabla f(\boldsymbol{w})\|^2 ⟨ ∇ f ( w ) , v − u ⟩ = − η ∥∇ f ( w ) ∥ 2 , 2 L ∥ v − u ∥ 2 = 2 L η 2 ∥∇ f ( w ) ∥ 2 であり、代入して ∥ ∇ f ( w ) ∥ 2 \|\nabla f(\boldsymbol{w})\|^2 ∥∇ f ( w ) ∥ 2
η ( 1 − L η / 2 ) > 0 \eta(1 - L\eta/2) > 0 η ( 1 − L η /2 ) > 0 η > 0 \eta > 0 η > 0 1 − L η / 2 > 0 1 - L\eta/2 > 0 1 − L η /2 > 0 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L ∥ ∇ f ( w ) ∥ 2 > 0 \|\nabla f(\boldsymbol{w})\|^2 > 0 ∥∇ f ( w ) ∥ 2 > 0 f ( w ) f(\boldsymbol{w}) f ( w )
最後に ψ ( η ) = η − L η 2 / 2 \psi(\eta) = \eta - L\eta^2/2 ψ ( η ) = η − L η 2 /2 ψ ′ ( η ) = 1 − L η = 0 \psi'(\eta) = 1 - L\eta = 0 ψ ′ ( η ) = 1 − L η = 0 η = 1 / L \eta = 1/L η = 1/ L ψ ( 1 / L ) = 1 / L − 1 / ( 2 L ) = 1 / ( 2 L ) \psi(1/L) = 1/L - 1/(2L) = 1/(2L) ψ ( 1/ L ) = 1/ L − 1/ ( 2 L ) = 1/ ( 2 L )
∎ 学習率の意味がはっきりしました。η \eta η L L L η ≥ 2 / L \eta \ge 2/L η ≥ 2/ L 補題 4.3 の右辺が f ( w ) f(\boldsymbol{w}) f ( w )
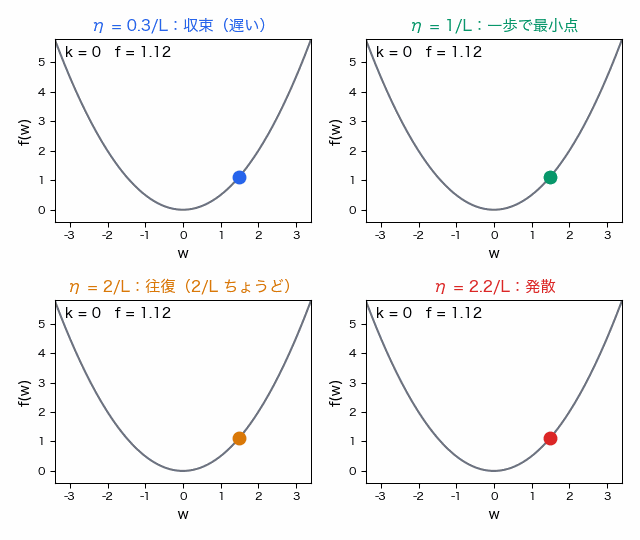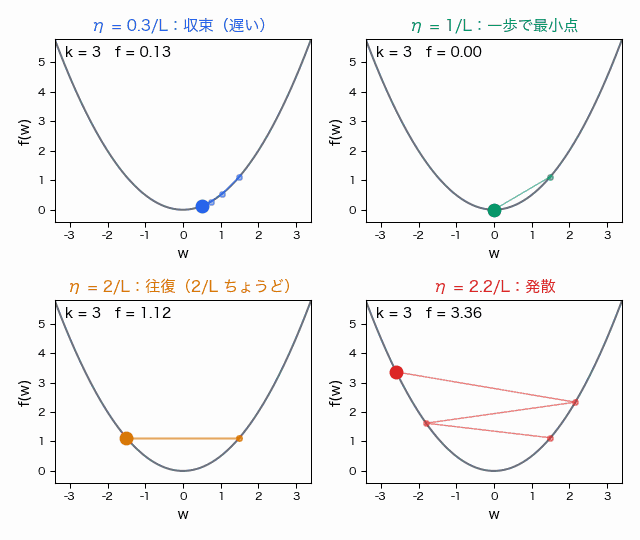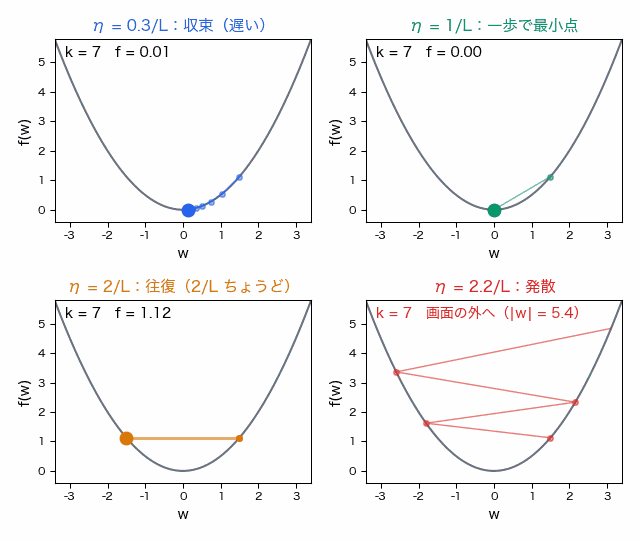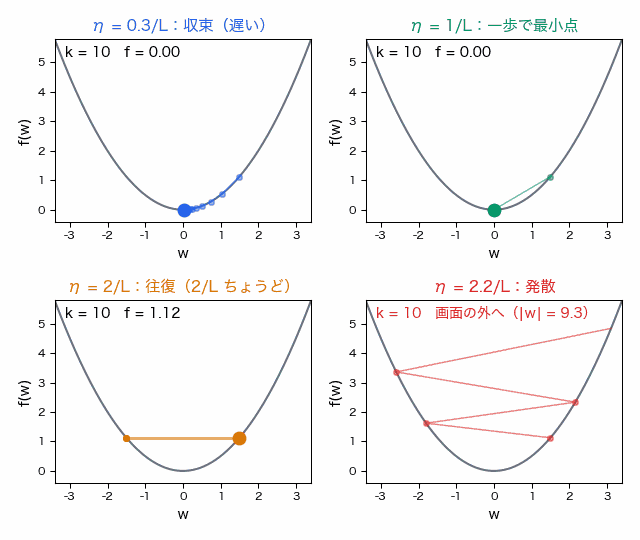
放物線 f ( w ) = L 2 w 2 f(w) = \frac{L}{2}w^2 f ( w ) = 2 L w 2 L = 1 L = 1 L = 1 w 0 = 1.5 w_0 = 1.5 w 0 = 1.5 η = 2 / L \eta = 2/L η = 2/ L
放物線の上での勾配降下法。η を 0.3/L、1/L、2/L、2.2/L にしたときの点の動き 次の定理の証明は、数え上げの議論です。η = 1 / L \eta = 1/L η = 1/ L f f f f f f f ( w 0 ) − f ⋆ f(\boldsymbol{w}_0) - f_\star f ( w 0 ) − f ⋆ f ( w k ) f(\boldsymbol{w}_k) f ( w k )
定理 4.5 (勾配降下法の停留点への収束 ) ✓
f : R n → R f : \mathbb{R}^n \to \mathbb{R} f : R n → R C 1 C^1 C 1 L L L f ⋆ = inf w f ( w ) > − ∞ f_\star = \inf_{\boldsymbol{w}} f(\boldsymbol{w}) > -\infty f ⋆ = inf w f ( w ) > − ∞ η = 1 / L \eta = 1/L η = 1/ L w k + 1 = w k − 1 L ∇ f ( w k ) \boldsymbol{w}_{k+1} = \boldsymbol{w}_k - \frac{1}{L}\nabla f(\boldsymbol{w}_k) w k + 1 = w k − L 1 ∇ f ( w k )
数列 ( f ( w k ) ) k ≥ 0 \bigl(f(\boldsymbol{w}_k)\bigr)_{k\ge 0} ( f ( w k ) ) k ≥ 0
任意の T ≥ 1 T \ge 1 T ≥ 1 min 0 ≤ k ≤ T − 1 ∥ ∇ f ( w k ) ∥ 2 ≤ 2 L ( f ( w 0 ) − f ⋆ ) T . \min_{0 \le k \le T-1}\bigl\|\nabla f(\boldsymbol{w}_k)\bigr\|^2 \ \le\ \frac{2L\bigl(f(\boldsymbol{w}_0) - f_\star\bigr)}{T}. 0 ≤ k ≤ T − 1 min ∇ f ( w k ) 2 ≤ T 2 L ( f ( w 0 ) − f ⋆ ) .
∑ k = 0 ∞ ∥ ∇ f ( w k ) ∥ 2 < ∞ \displaystyle\sum_{k=0}^{\infty}\bigl\|\nabla f(\boldsymbol{w}_k)\bigr\|^2 < \infty k = 0 ∑ ∞ ∇ f ( w k ) 2 < ∞ ∥ ∇ f ( w k ) ∥ → 0 \|\nabla f(\boldsymbol{w}_k)\| \to 0 ∥∇ f ( w k ) ∥ → 0 k → ∞ k \to \infty k → ∞ 証明(定理 4.5) 系 4.4 に η = 1 / L \eta = 1/L η = 1/ L k k k
f ( w k + 1 ) ≤ f ( w k ) − 1 2 L ∥ ∇ f ( w k ) ∥ 2 f(\boldsymbol{w}_{k+1}) \le f(\boldsymbol{w}_k) - \frac{1}{2L}\bigl\|\nabla f(\boldsymbol{w}_k)\bigr\|^2 f ( w k + 1 ) ≤ f ( w k ) − 2 L 1 ∇ f ( w k ) 2 を得ます。以下この不等式を「1 ステップ不等式」と呼びます。右辺の第 2 項は非正なので f ( w k + 1 ) ≤ f ( w k ) f(\boldsymbol{w}_{k+1}) \le f(\boldsymbol{w}_k) f ( w k + 1 ) ≤ f ( w k ) f ( w k ) ≥ f ⋆ f(\boldsymbol{w}_k) \ge f_\star f ( w k ) ≥ f ⋆ ( f ( w k ) ) \bigl(f(\boldsymbol{w}_k)\bigr) ( f ( w k ) )
この 1 ステップ不等式を移項して k = 0 , 1 , … , T − 1 k = 0, 1, \ldots, T-1 k = 0 , 1 , … , T − 1
1 2 L ∑ k = 0 T − 1 ∥ ∇ f ( w k ) ∥ 2 ≤ ∑ k = 0 T − 1 ( f ( w k ) − f ( w k + 1 ) ) = f ( w 0 ) − f ( w T ) ≤ f ( w 0 ) − f ⋆ \frac{1}{2L}\sum_{k=0}^{T-1}\bigl\|\nabla f(\boldsymbol{w}_k)\bigr\|^2
\ \le\ \sum_{k=0}^{T-1}\bigl(f(\boldsymbol{w}_k) - f(\boldsymbol{w}_{k+1})\bigr)
= f(\boldsymbol{w}_0) - f(\boldsymbol{w}_T)
\ \le\ f(\boldsymbol{w}_0) - f_\star 2 L 1 k = 0 ∑ T − 1 ∇ f ( w k ) 2 ≤ k = 0 ∑ T − 1 ( f ( w k ) − f ( w k + 1 ) ) = f ( w 0 ) − f ( w T ) ≤ f ( w 0 ) − f ⋆ を得ます(最後の不等号は f ( w T ) ≥ f ⋆ f(\boldsymbol{w}_T) \ge f_\star f ( w T ) ≥ f ⋆ T T T
min 0 ≤ k ≤ T − 1 ∥ ∇ f ( w k ) ∥ 2 ≤ 1 T ∑ k = 0 T − 1 ∥ ∇ f ( w k ) ∥ 2 ≤ 2 L ( f ( w 0 ) − f ⋆ ) T \min_{0\le k\le T-1}\bigl\|\nabla f(\boldsymbol{w}_k)\bigr\|^2
\le \frac{1}{T}\sum_{k=0}^{T-1}\bigl\|\nabla f(\boldsymbol{w}_k)\bigr\|^2
\le \frac{2L\bigl(f(\boldsymbol{w}_0)-f_\star\bigr)}{T} 0 ≤ k ≤ T − 1 min ∇ f ( w k ) 2 ≤ T 1 k = 0 ∑ T − 1 ∇ f ( w k ) 2 ≤ T 2 L ( f ( w 0 ) − f ⋆ ) となり 2 が示せました。
3 も同じ不等式から出ます。上の評価は T T T 2 L ( f ( w 0 ) − f ⋆ ) 2L(f(\boldsymbol{w}_0)-f_\star) 2 L ( f ( w 0 ) − f ⋆ ) ∑ k ∥ ∇ f ( w k ) ∥ 2 \sum_k \|\nabla f(\boldsymbol{w}_k)\|^2 ∑ k ∥∇ f ( w k ) ∥ 2 級数と収束判定 )。収束する級数の一般項は 0 0 0 ∥ ∇ f ( w k ) ∥ 2 → 0 \|\nabla f(\boldsymbol{w}_k)\|^2 \to 0 ∥∇ f ( w k ) ∥ 2 → 0 ∥ ∇ f ( w k ) ∥ → 0 \|\nabla f(\boldsymbol{w}_k)\| \to 0 ∥∇ f ( w k ) ∥ → 0
∎ 二次関数は、勾配降下法の挙動を完全に手計算で追える唯一の例です。しかも一般の f f f
命題 5.1 (二次関数に対する勾配降下法 ) ✓
A ∈ R n × n A \in \mathbb{R}^{n\times n} A ∈ R n × n b ∈ R n \boldsymbol{b} \in \mathbb{R}^n b ∈ R n
f ( w ) = 1 2 ⟨ w , A w ⟩ − ⟨ b , w ⟩ f(\boldsymbol{w}) = \tfrac{1}{2}\langle \boldsymbol{w}, A\boldsymbol{w}\rangle - \langle \boldsymbol{b}, \boldsymbol{w}\rangle f ( w ) = 2 1 ⟨ w , A w ⟩ − ⟨ b , w ⟩ とします。A A A 0 < λ 1 ≤ λ 2 ≤ ⋯ ≤ λ n 0 < \lambda_1 \le \lambda_2 \le \cdots \le \lambda_n 0 < λ 1 ≤ λ 2 ≤ ⋯ ≤ λ n κ = λ n / λ 1 \kappa = \lambda_n/\lambda_1 κ = λ n / λ 1 w ⋆ = A − 1 b \boldsymbol{w}_\star = A^{-1}\boldsymbol{b} w ⋆ = A − 1 b η > 0 \eta > 0 η > 0 w k + 1 = w k − η ∇ f ( w k ) \boldsymbol{w}_{k+1} = \boldsymbol{w}_k - \eta\nabla f(\boldsymbol{w}_k) w k + 1 = w k − η ∇ f ( w k )
w k − w ⋆ = ( I − η A ) k ( w 0 − w ⋆ ) \boldsymbol{w}_k - \boldsymbol{w}_\star = (I - \eta A)^k(\boldsymbol{w}_0 - \boldsymbol{w}_\star) w k − w ⋆ = ( I − η A ) k ( w 0 − w ⋆ ) ρ ( η ) = max ( ∣ 1 − η λ 1 ∣ , ∣ 1 − η λ n ∣ ) \rho(\eta) = \max\bigl(|1-\eta\lambda_1|,\ |1-\eta\lambda_n|\bigr) ρ ( η ) = max ( ∣1 − η λ 1 ∣ , ∣1 − η λ n ∣ ) ∥ w k − w ⋆ ∥ ≤ ρ ( η ) k ∥ w 0 − w ⋆ ∥ \|\boldsymbol{w}_k - \boldsymbol{w}_\star\| \le \rho(\eta)^k\|\boldsymbol{w}_0 - \boldsymbol{w}_\star\| ∥ w k − w ⋆ ∥ ≤ ρ ( η ) k ∥ w 0 − w ⋆ ∥ すべての 初期値 w 0 \boldsymbol{w}_0 w 0 w k → w ⋆ \boldsymbol{w}_k \to \boldsymbol{w}_\star w k → w ⋆ 0 < η < 2 / λ n 0 < \eta < 2/\lambda_n 0 < η < 2/ λ n ρ ( η ) \rho(\eta) ρ ( η ) η ⋆ = 2 λ 1 + λ n \eta_\star = \dfrac{2}{\lambda_1 + \lambda_n} η ⋆ = λ 1 + λ n 2 ρ ( η ⋆ ) = λ n − λ 1 λ n + λ 1 = κ − 1 κ + 1 . \rho(\eta_\star) = \frac{\lambda_n - \lambda_1}{\lambda_n + \lambda_1} = \frac{\kappa - 1}{\kappa + 1}. ρ ( η ⋆ ) = λ n + λ 1 λ n − λ 1 = κ + 1 κ − 1 . 証明(命題 5.1) まず勾配を求めます。例 2.4 と同じ要領で f ( w + h ) f(\boldsymbol{w}+\boldsymbol{h}) f ( w + h ) A A A
f ( w + h ) = f ( w ) + ⟨ A w − b , h ⟩ + 1 2 ⟨ h , A h ⟩ f(\boldsymbol{w}+\boldsymbol{h}) = f(\boldsymbol{w}) + \langle A\boldsymbol{w} - \boldsymbol{b},\ \boldsymbol{h}\rangle + \tfrac{1}{2}\langle \boldsymbol{h}, A\boldsymbol{h}\rangle f ( w + h ) = f ( w ) + ⟨ A w − b , h ⟩ + 2 1 ⟨ h , A h ⟩ となり、最後の項は ∥ h ∥ 2 \|\boldsymbol{h}\|^2 ∥ h ∥ 2 o ( ∥ h ∥ ) o(\|\boldsymbol{h}\|) o ( ∥ h ∥ ) ∇ f ( w ) = A w − b \nabla f(\boldsymbol{w}) = A\boldsymbol{w} - \boldsymbol{b} ∇ f ( w ) = A w − b 0 \boldsymbol{0} 0 A A A w = A − 1 b = w ⋆ \boldsymbol{w} = A^{-1}\boldsymbol{b} = \boldsymbol{w}_\star w = A − 1 b = w ⋆
1 の証明。 b = A w ⋆ \boldsymbol{b} = A\boldsymbol{w}_\star b = A w ⋆ ∇ f ( w k ) = A w k − A w ⋆ = A ( w k − w ⋆ ) \nabla f(\boldsymbol{w}_k) = A\boldsymbol{w}_k - A\boldsymbol{w}_\star = A(\boldsymbol{w}_k - \boldsymbol{w}_\star) ∇ f ( w k ) = A w k − A w ⋆ = A ( w k − w ⋆ ) e k = w k − w ⋆ \boldsymbol{e}_k = \boldsymbol{w}_k - \boldsymbol{w}_\star e k = w k − w ⋆
e k + 1 = w k − η A e k − w ⋆ = ( I − η A ) e k \boldsymbol{e}_{k+1} = \boldsymbol{w}_k - \eta A\boldsymbol{e}_k - \boldsymbol{w}_\star = (I - \eta A)\boldsymbol{e}_k e k + 1 = w k − η A e k − w ⋆ = ( I − η A ) e k なので、k k k e k = ( I − η A ) k e 0 \boldsymbol{e}_k = (I-\eta A)^k\boldsymbol{e}_0 e k = ( I − η A ) k e 0
2 の証明。 A A A スペクトル定理 (実対称行列の直交対角化(系 4.3)[スペクトル定理] )により、正規直交基底からなる固有ベクトル q 1 , … , q n \boldsymbol{q}_1,\ldots,\boldsymbol{q}_n q 1 , … , q n A q i = λ i q i A\boldsymbol{q}_i = \lambda_i\boldsymbol{q}_i A q i = λ i q i I − η A I - \eta A I − η A 1 − η λ i 1 - \eta\lambda_i 1 − η λ i e 0 = ∑ i c i q i \boldsymbol{e}_0 = \sum_i c_i \boldsymbol{q}_i e 0 = ∑ i c i q i
e k = ∑ i = 1 n ( 1 − η λ i ) k c i q i , ∥ e k ∥ 2 = ∑ i = 1 n ( 1 − η λ i ) 2 k c i 2 \boldsymbol{e}_k = \sum_{i=1}^{n} (1-\eta\lambda_i)^k c_i \boldsymbol{q}_i,
\qquad
\|\boldsymbol{e}_k\|^2 = \sum_{i=1}^{n}(1-\eta\lambda_i)^{2k}c_i^2 e k = i = 1 ∑ n ( 1 − η λ i ) k c i q i , ∥ e k ∥ 2 = i = 1 ∑ n ( 1 − η λ i ) 2 k c i 2 です(2 番目の等式は正規直交性から)。m ( η ) = max i ∣ 1 − η λ i ∣ m(\eta) = \max_i |1-\eta\lambda_i| m ( η ) = max i ∣1 − η λ i ∣ ∥ e k ∥ 2 ≤ m ( η ) 2 k ∑ i c i 2 = m ( η ) 2 k ∥ e 0 ∥ 2 \|\boldsymbol{e}_k\|^2 \le m(\eta)^{2k}\sum_i c_i^2 = m(\eta)^{2k}\|\boldsymbol{e}_0\|^2 ∥ e k ∥ 2 ≤ m ( η ) 2 k ∑ i c i 2 = m ( η ) 2 k ∥ e 0 ∥ 2
m ( η ) = ρ ( η ) m(\eta) = \rho(\eta) m ( η ) = ρ ( η ) λ ↦ ∣ 1 − η λ ∣ \lambda \mapsto |1-\eta\lambda| λ ↦ ∣1 − η λ ∣ λ i \lambda_i λ i [ λ 1 , λ n ] [\lambda_1, \lambda_n] [ λ 1 , λ n ] max i ∣ 1 − η λ i ∣ = max ( ∣ 1 − η λ 1 ∣ , ∣ 1 − η λ n ∣ ) \max_i|1-\eta\lambda_i| = \max(|1-\eta\lambda_1|, |1-\eta\lambda_n|) max i ∣1 − η λ i ∣ = max ( ∣1 − η λ 1 ∣ , ∣1 − η λ n ∣ )
収束条件を示します。0 < η < 2 / λ n 0 < \eta < 2/\lambda_n 0 < η < 2/ λ n i i i 0 < η λ i ≤ η λ n < 2 0 < \eta\lambda_i \le \eta\lambda_n < 2 0 < η λ i ≤ η λ n < 2 − 1 < 1 − η λ i < 1 -1 < 1-\eta\lambda_i < 1 − 1 < 1 − η λ i < 1 ρ ( η ) < 1 \rho(\eta) < 1 ρ ( η ) < 1 ∥ e k ∥ → 0 \|\boldsymbol{e}_k\| \to 0 ∥ e k ∥ → 0 η ≥ 2 / λ n \eta \ge 2/\lambda_n η ≥ 2/ λ n 1 − η λ n ≤ − 1 1 - \eta\lambda_n \le -1 1 − η λ n ≤ − 1 e 0 = q n \boldsymbol{e}_0 = \boldsymbol{q}_n e 0 = q n w 0 = w ⋆ + q n \boldsymbol{w}_0 = \boldsymbol{w}_\star + \boldsymbol{q}_n w 0 = w ⋆ + q n ∥ e k ∥ = ∣ 1 − η λ n ∣ k ≥ 1 \|\boldsymbol{e}_k\| = |1-\eta\lambda_n|^k \ge 1 ∥ e k ∥ = ∣1 − η λ n ∣ k ≥ 1 0 \boldsymbol{0} 0
3 の証明。 η \eta η 0 0 0 ∣ 1 − η λ 1 ∣ |1-\eta\lambda_1| ∣1 − η λ 1 ∣ η = 1 / λ 1 \eta = 1/\lambda_1 η = 1/ λ 1 ∣ 1 − η λ n ∣ |1-\eta\lambda_n| ∣1 − η λ n ∣ η = 1 / λ n ≤ 1 / λ 1 \eta = 1/\lambda_n \le 1/\lambda_1 η = 1/ λ n ≤ 1/ λ 1 ρ \rho ρ 1 − η λ 1 > 0 1-\eta\lambda_1 > 0 1 − η λ 1 > 0 1 − η λ n < 0 1-\eta\lambda_n < 0 1 − η λ n < 0
1 − η λ 1 = − ( 1 − η λ n ) ⟺ 2 = η ( λ 1 + λ n ) ⟺ η = 2 λ 1 + λ n 1 - \eta\lambda_1 = -(1-\eta\lambda_n) \iff 2 = \eta(\lambda_1+\lambda_n) \iff \eta = \frac{2}{\lambda_1+\lambda_n} 1 − η λ 1 = − ( 1 − η λ n ) ⟺ 2 = η ( λ 1 + λ n ) ⟺ η = λ 1 + λ n 2 です。実際、η \eta η ρ ( η ) = 1 − η λ 1 \rho(\eta) = 1-\eta\lambda_1 ρ ( η ) = 1 − η λ 1 η \eta η ρ ( η ) = η λ n − 1 \rho(\eta) = \eta\lambda_n - 1 ρ ( η ) = η λ n − 1
ρ ( η ⋆ ) = 1 − 2 λ 1 λ 1 + λ n = λ n − λ 1 λ n + λ 1 \rho(\eta_\star) = 1 - \frac{2\lambda_1}{\lambda_1+\lambda_n} = \frac{\lambda_n-\lambda_1}{\lambda_n+\lambda_1} ρ ( η ⋆ ) = 1 − λ 1 + λ n 2 λ 1 = λ n + λ 1 λ n − λ 1 で、分子分母を λ 1 \lambda_1 λ 1 ( κ − 1 ) / ( κ + 1 ) (\kappa-1)/(\kappa+1) ( κ − 1 ) / ( κ + 1 )
∎ 命題 5.1 の 2 は 系 4.4 と正確に整合します。二次関数 f f f ∇ f ( u ) − ∇ f ( v ) = A ( u − v ) \nabla f(\boldsymbol{u}) - \nabla f(\boldsymbol{v}) = A(\boldsymbol{u}-\boldsymbol{v}) ∇ f ( u ) − ∇ f ( v ) = A ( u − v ) L L L L = ∥ A ∥ 2 = λ n L = \|A\|_2 = \lambda_n L = ∥ A ∥ 2 = λ n 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L 0 < η < 2 / λ n 0 < \eta < 2/\lambda_n 0 < η < 2/ λ n
命題 5.1 の 3 が伝えているのは深刻な事実です。誤差を ε \varepsilon ε
k ≈ ln ( 1 / ε ) ln ( 1 / ρ ( η ⋆ ) ) ≈ κ 2 ln 1 ε k \approx \frac{\ln(1/\varepsilon)}{\ln\bigl(1/\rho(\eta_\star)\bigr)} \approx \frac{\kappa}{2}\ln\frac{1}{\varepsilon} k ≈ ln ( 1/ ρ ( η ⋆ ) ) ln ( 1/ ε ) ≈ 2 κ ln ε 1 です(κ \kappa κ ln κ + 1 κ − 1 ≈ 2 / κ \ln\frac{\kappa+1}{\kappa-1} \approx 2/\kappa ln κ − 1 κ + 1 ≈ 2/ κ 条件数に比例して遅くなる わけです。κ = 10 4 \kappa = 10^4 κ = 1 0 4 1 / 1000 1/1000 1/1000
細長い等高線の上でのジグザグ。勾配は等高線に直交するため、最小点の方向とは大きくずれる 図は f ( w 1 , w 2 ) = 1 2 ( w 1 2 + 25 w 2 2 ) f(w_1, w_2) = \frac{1}{2}(w_1^2 + 25 w_2^2) f ( w 1 , w 2 ) = 2 1 ( w 1 2 + 25 w 2 2 ) A = d i a g ( 1 , 25 ) A = \mathrm{diag}(1, 25) A = diag ( 1 , 25 ) κ = 25 \kappa = 25 κ = 25 w 0 = ( 5 , 1 ) T \boldsymbol{w}_0 = (5, 1)^{\mathsf{T}} w 0 = ( 5 , 1 ) T η ⋆ = 2 / 26 = 1 / 13 \eta_\star = 2/26 = 1/13 η ⋆ = 2/26 = 1/13 系 3.3 のとおり勾配は等高線に直交するので、細長い谷では勾配がほとんど「谷を横切る向き」を指し、「谷に沿って最小点へ向かう向き」の成分はごくわずかしか含みません。その結果、上下に激しく振動しながら少しずつ右から左へ進むことになります。
この例では w 1 w_1 w 1 1 − η λ 1 = 12 / 13 1-\eta\lambda_1 = 12/13 1 − η λ 1 = 12/13 w 2 w_2 w 2 1 − η λ n = − 12 / 13 1-\eta\lambda_n = -12/13 1 − η λ n = − 12/13 w 2 w_2 w 2 12 / 13 ≈ 0.923 12/13 \approx 0.923 12/13 ≈ 0.923 f f f ( 12 / 13 ) 2 = 144 / 169 ≈ 0.852 (12/13)^2 = 144/169 \approx 0.852 ( 12/13 ) 2 = 144/169 ≈ 0.852 f f f 10 − 6 10^{-6} 1 0 − 6 ln ( 10 − 6 ) / ln ( 144 / 169 ) ≈ 86.3 \ln(10^{-6})/\ln(144/169) \approx 86.3 ln ( 1 0 − 6 ) / ln ( 144/169 ) ≈ 86.3
例 5.2 (学習率を上げすぎると何が起きるか )
同じ f ( w 1 , w 2 ) = 1 2 ( w 1 2 + 25 w 2 2 ) f(w_1,w_2) = \frac{1}{2}(w_1^2 + 25w_2^2) f ( w 1 , w 2 ) = 2 1 ( w 1 2 + 25 w 2 2 ) f f f L = λ n = 25 L = \lambda_n = 25 L = λ n = 25 0 < η < 2 / 25 = 0.08 0 < \eta < 2/25 = 0.08 0 < η < 2/25 = 0.08
A = np. diag ( [ 1.0 , 25.0 ] ) # f(w) = (1/2) * w^T A w
def run ( eta , n_iter= 50 , w0= ( 5.0 , 1.0 ) ) :
w = np. array ( w0 , dtype = float )
for eta in ( 0.04 , 1 / 13 , 0.08 , 0.09 ):
print ( f "eta = {eta :.4f } f(w_50) = { run ( eta ) :.3e } " )
出力はおよそ次のようになります。
学習率 η \eta η 位置づけ 50 回後の f f f 0.04 = 1 / L 0.04 = 1/L 0.04 = 1/ L 降下補題が勧める値 2.11 × 10 − 1 2.11 \times 10^{-1} 2.11 × 1 0 − 1 1 / 13 ≈ 0.0769 1/13 \approx 0.0769 1/13 ≈ 0.0769 命題 5.1 の最適値8.35 × 10 − 3 8.35 \times 10^{-3} 8.35 × 1 0 − 3 0.08 = 2 / L 0.08 = 2/L 0.08 = 2/ L 安全圏の境界 1.25 × 10 1 1.25 \times 10^{1} 1.25 × 1 0 1 0.09 0.09 0.09 安全圏の外 6.14 × 10 10 6.14 \times 10^{10} 6.14 × 1 0 10
読み取れることが三つあります。第一に、η = 1 / L = 0.04 \eta = 1/L = 0.04 η = 1/ L = 0.04 1 − η λ n = 0 1-\eta\lambda_n = 0 1 − η λ n = 0 w 2 w_2 w 2 w 1 w_1 w 1 0.96 0.96 0.96 0.96 50 ≈ 0.130 0.96^{50} \approx 0.130 0.9 6 50 ≈ 0.130 η = 2 / L = 0.08 \eta = 2/L = 0.08 η = 2/ L = 0.08 1 − η λ n = − 1 1-\eta\lambda_n = -1 1 − η λ n = − 1 w 2 w_2 w 2 ± 1 \pm 1 ± 1 f f f f f f 12.5 12.5 12.5 η = 0.09 \eta = 0.09 η = 0.09 ∣ 1 − η λ n ∣ = 1.25 > 1 |1-\eta\lambda_n| = 1.25 > 1 ∣1 − η λ n ∣ = 1.25 > 1 w 2 w_2 w 2 1.25 50 ≈ 7.0 × 10 4 1.25^{50} \approx 7.0\times 10^4 1.2 5 50 ≈ 7.0 × 1 0 4
学習率を上げすぎた学習の損失が「途中から急上昇して NaN になる」典型的な失敗は、これと同じことが起きています。
実務では L L L 10 − 1 , 10 − 2 , 10 − 3 , … 10^{-1}, 10^{-2}, 10^{-3}, \ldots 1 0 − 1 , 1 0 − 2 , 1 0 − 3 , … 例 5.2 の表が示すとおり、安全圏の上限ぎりぎりは性能が最良でも安定でもありません。
道具が揃ったので、§1 で立ち往生した問題に戻ります。記号を決めます。x i ∈ R n \boldsymbol{x}_i \in \mathbb{R}^n x i ∈ R n y i ∈ { 0 , 1 } y_i \in \{0,1\} y i ∈ { 0 , 1 } i = 1 , … , N i = 1,\ldots,N i = 1 , … , N X ∈ R N × n X \in \mathbb{R}^{N\times n} X ∈ R N × n i i i x i T \boldsymbol{x}_i^{\mathsf{T}} x i T y = ( y 1 , … , y N ) T \boldsymbol{y} = (y_1,\ldots,y_N)^{\mathsf{T}} y = ( y 1 , … , y N ) T シグモイド関数 σ ( z ) = 1 / ( 1 + e − z ) \sigma(z) = 1/(1+e^{-z}) σ ( z ) = 1/ ( 1 + e − z ) p i ( w ) = σ ( ⟨ w , x i ⟩ ) p_i(\boldsymbol{w}) = \sigma(\langle \boldsymbol{w}, \boldsymbol{x}_i\rangle) p i ( w ) = σ (⟨ w , x i ⟩) p ( w ) = ( p 1 , … , p N ) T \boldsymbol{p}(\boldsymbol{w}) = (p_1,\ldots,p_N)^{\mathsf{T}} p ( w ) = ( p 1 , … , p N ) T 交差エントロピー誤差
f ( w ) = − 1 N ∑ i = 1 N [ y i log p i ( w ) + ( 1 − y i ) log ( 1 − p i ( w ) ) ] f(\boldsymbol{w}) = -\frac{1}{N}\sum_{i=1}^{N}\Bigl[\, y_i \log p_i(\boldsymbol{w}) + (1-y_i)\log\bigl(1 - p_i(\boldsymbol{w})\bigr) \Bigr] f ( w ) = − N 1 i = 1 ∑ N [ y i log p i ( w ) + ( 1 − y i ) log ( 1 − p i ( w ) ) ] です。
命題 6.1 (ロジスティック損失の勾配・ヘッセ行列・平滑性 ) ✓
上の f f f
f f f R n \mathbb{R}^n R n C ∞ C^\infty C ∞ ∇ f ( w ) = 1 N ∑ i = 1 N ( p i ( w ) − y i ) x i = 1 N X T ( p ( w ) − y ) . \nabla f(\boldsymbol{w}) = \frac{1}{N}\sum_{i=1}^{N}\bigl(p_i(\boldsymbol{w}) - y_i\bigr)\boldsymbol{x}_i = \frac{1}{N}X^{\mathsf{T}}\bigl(\boldsymbol{p}(\boldsymbol{w}) - \boldsymbol{y}\bigr). ∇ f ( w ) = N 1 i = 1 ∑ N ( p i ( w ) − y i ) x i = N 1 X T ( p ( w ) − y ) . ヘッセ行列は S ( w ) = d i a g ( p 1 ( 1 − p 1 ) , … , p N ( 1 − p N ) ) S(\boldsymbol{w}) = \mathrm{diag}\bigl(p_1(1-p_1), \ldots, p_N(1-p_N)\bigr) S ( w ) = diag ( p 1 ( 1 − p 1 ) , … , p N ( 1 − p N ) ) ∇ 2 f ( w ) = 1 N ∑ i = 1 N p i ( 1 − p i ) x i x i T = 1 N X T S ( w ) X \nabla^2 f(\boldsymbol{w}) = \frac{1}{N}\sum_{i=1}^{N} p_i(1-p_i)\,\boldsymbol{x}_i\boldsymbol{x}_i^{\mathsf{T}} = \frac{1}{N}X^{\mathsf{T}}S(\boldsymbol{w})X ∇ 2 f ( w ) = N 1 i = 1 ∑ N p i ( 1 − p i ) x i x i T = N 1 X T S ( w ) X w \boldsymbol{w} w f f f 凸関数 で、停留点はすべて大域最小点です。
f f f L L L L = λ max ( X T X ) 4 N L = \dfrac{\lambda_{\max}(X^{\mathsf{T}}X)}{4N} L = 4 N λ m a x ( X T X ) 証明(命題 6.1) まずシグモイド関数の微分を確かめます。σ ( z ) = ( 1 + e − z ) − 1 \sigma(z) = (1+e^{-z})^{-1} σ ( z ) = ( 1 + e − z ) − 1
σ ′ ( z ) = − ( 1 + e − z ) − 2 ⋅ ( − e − z ) = e − z ( 1 + e − z ) 2 = 1 1 + e − z ⋅ e − z 1 + e − z = σ ( z ) ( 1 − σ ( z ) ) \sigma'(z) = -\,(1+e^{-z})^{-2}\cdot(-e^{-z}) = \frac{e^{-z}}{(1+e^{-z})^{2}} = \frac{1}{1+e^{-z}}\cdot\frac{e^{-z}}{1+e^{-z}} = \sigma(z)\bigl(1-\sigma(z)\bigr) σ ′ ( z ) = − ( 1 + e − z ) − 2 ⋅ ( − e − z ) = ( 1 + e − z ) 2 e − z = 1 + e − z 1 ⋅ 1 + e − z e − z = σ ( z ) ( 1 − σ ( z ) ) です(最後は 1 − σ ( z ) = e − z / ( 1 + e − z ) 1-\sigma(z) = e^{-z}/(1+e^{-z}) 1 − σ ( z ) = e − z / ( 1 + e − z ) σ \sigma σ R \mathbb{R} R C ∞ C^\infty C ∞ 0 < σ < 1 0 < \sigma < 1 0 < σ < 1 log \log log C ∞ C^\infty C ∞
1 の証明。 1 サンプル分の損失を ℓ ( z , y ) = − y log σ ( z ) − ( 1 − y ) log ( 1 − σ ( z ) ) \ell(z, y) = -y\log\sigma(z) - (1-y)\log(1-\sigma(z)) ℓ ( z , y ) = − y log σ ( z ) − ( 1 − y ) log ( 1 − σ ( z )) z z z ( log σ ) ′ = σ ′ / σ = 1 − σ \bigl(\log\sigma\bigr)' = \sigma'/\sigma = 1-\sigma ( log σ ) ′ = σ ′ / σ = 1 − σ ( log ( 1 − σ ) ) ′ = − σ ′ / ( 1 − σ ) = − σ \bigl(\log(1-\sigma)\bigr)' = -\sigma'/(1-\sigma) = -\sigma ( log ( 1 − σ ) ) ′ = − σ ′ / ( 1 − σ ) = − σ
∂ ℓ ∂ z ( z , y ) = − y ( 1 − σ ( z ) ) + ( 1 − y ) σ ( z ) = − y + y σ ( z ) + σ ( z ) − y σ ( z ) = σ ( z ) − y . \frac{\partial \ell}{\partial z}(z,y) = -y(1-\sigma(z)) + (1-y)\sigma(z) = -y + y\sigma(z) + \sigma(z) - y\sigma(z) = \sigma(z) - y . ∂ z ∂ ℓ ( z , y ) = − y ( 1 − σ ( z )) + ( 1 − y ) σ ( z ) = − y + y σ ( z ) + σ ( z ) − y σ ( z ) = σ ( z ) − y . 途中の y σ y\sigma y σ z i ( w ) = ⟨ w , x i ⟩ z_i(\boldsymbol{w}) = \langle \boldsymbol{w}, \boldsymbol{x}_i\rangle z i ( w ) = ⟨ w , x i ⟩ w \boldsymbol{w} w ∇ w z i = x i \nabla_{\boldsymbol{w}} z_i = \boldsymbol{x}_i ∇ w z i = x i
∇ f ( w ) = 1 N ∑ i = 1 N ∂ ℓ ∂ z ( z i , y i ) ∇ w z i = 1 N ∑ i = 1 N ( p i − y i ) x i . \nabla f(\boldsymbol{w}) = \frac{1}{N}\sum_{i=1}^{N}\frac{\partial \ell}{\partial z}(z_i, y_i)\,\nabla_{\boldsymbol{w}}z_i = \frac{1}{N}\sum_{i=1}^{N}\bigl(p_i - y_i\bigr)\boldsymbol{x}_i . ∇ f ( w ) = N 1 i = 1 ∑ N ∂ z ∂ ℓ ( z i , y i ) ∇ w z i = N 1 i = 1 ∑ N ( p i − y i ) x i . ∑ i c i x i = X T c \sum_i c_i\boldsymbol{x}_i = X^{\mathsf{T}}\boldsymbol{c} ∑ i c i x i = X T c
2 の証明。 1 をもう一度 w \boldsymbol{w} w p i = σ ( z i ) p_i = \sigma(z_i) p i = σ ( z i ) w \boldsymbol{w} w ∇ w p i = σ ′ ( z i ) x i = p i ( 1 − p i ) x i \nabla_{\boldsymbol{w}} p_i = \sigma'(z_i)\boldsymbol{x}_i = p_i(1-p_i)\boldsymbol{x}_i ∇ w p i = σ ′ ( z i ) x i = p i ( 1 − p i ) x i ∇ f = 1 N ∑ i ( p i − y i ) x i \nabla f = \frac{1}{N}\sum_i (p_i-y_i)\boldsymbol{x}_i ∇ f = N 1 ∑ i ( p i − y i ) x i x i ( ∇ w p i ) T = p i ( 1 − p i ) x i x i T \boldsymbol{x}_i\bigl(\nabla_{\boldsymbol{w}} p_i\bigr)^{\mathsf{T}} = p_i(1-p_i)\boldsymbol{x}_i\boldsymbol{x}_i^{\mathsf{T}} x i ( ∇ w p i ) T = p i ( 1 − p i ) x i x i T
半正定値性を確かめます。任意の v ∈ R n \boldsymbol{v} \in \mathbb{R}^n v ∈ R n
⟨ v , ∇ 2 f ( w ) v ⟩ = 1 N ∑ i = 1 N p i ( 1 − p i ) ⟨ x i , v ⟩ 2 ≥ 0 \bigl\langle \boldsymbol{v},\ \nabla^2 f(\boldsymbol{w})\boldsymbol{v}\bigr\rangle
= \frac{1}{N}\sum_{i=1}^{N} p_i(1-p_i)\,\bigl\langle \boldsymbol{x}_i, \boldsymbol{v}\bigr\rangle^{2}
\ \ge\ 0 ⟨ v , ∇ 2 f ( w ) v ⟩ = N 1 i = 1 ∑ N p i ( 1 − p i ) ⟨ x i , v ⟩ 2 ≥ 0 です(v T x i x i T v = ⟨ x i , v ⟩ 2 \boldsymbol{v}^{\mathsf{T}}\boldsymbol{x}_i\boldsymbol{x}_i^{\mathsf{T}}\boldsymbol{v} = \langle\boldsymbol{x}_i,\boldsymbol{v}\rangle^2 v T x i x i T v = ⟨ x i , v ⟩ 2 0 < p i < 1 0 < p_i < 1 0 < p i < 1 p i ( 1 − p i ) > 0 p_i(1-p_i) > 0 p i ( 1 − p i ) > 0 C 2 C^2 C 2 f f f ∇ f ( w ) = 0 \nabla f(\boldsymbol{w}) = \boldsymbol{0} ∇ f ( w ) = 0 凸関数では停留点と大域最小点が一致する(定理 4.2)[なぜ機械学習に数学が必要か] )。
3 の証明。 t ∈ ( 0 , 1 ) t \in (0,1) t ∈ ( 0 , 1 ) t ( 1 − t ) = 1 4 − ( t − 1 2 ) 2 ≤ 1 4 t(1-t) = \frac{1}{4} - \bigl(t-\frac{1}{2}\bigr)^2 \le \frac{1}{4} t ( 1 − t ) = 4 1 − ( t − 2 1 ) 2 ≤ 4 1
⟨ v , ∇ 2 f ( w ) v ⟩ ≤ 1 4 N ∑ i = 1 N ⟨ x i , v ⟩ 2 = 1 4 N ∥ X v ∥ 2 = 1 4 N ⟨ v , X T X v ⟩ ≤ λ max ( X T X ) 4 N ∥ v ∥ 2 \bigl\langle \boldsymbol{v}, \nabla^2 f(\boldsymbol{w})\boldsymbol{v}\bigr\rangle
\le \frac{1}{4N}\sum_{i=1}^{N}\langle \boldsymbol{x}_i,\boldsymbol{v}\rangle^2
= \frac{1}{4N}\|X\boldsymbol{v}\|^2
= \frac{1}{4N}\bigl\langle \boldsymbol{v}, X^{\mathsf{T}}X\boldsymbol{v}\bigr\rangle
\le \frac{\lambda_{\max}(X^{\mathsf{T}}X)}{4N}\|\boldsymbol{v}\|^2 ⟨ v , ∇ 2 f ( w ) v ⟩ ≤ 4 N 1 i = 1 ∑ N ⟨ x i , v ⟩ 2 = 4 N 1 ∥ X v ∥ 2 = 4 N 1 ⟨ v , X T X v ⟩ ≤ 4 N λ m a x ( X T X ) ∥ v ∥ 2 となります。最後の不等号は、対称半正定値行列 X T X X^{\mathsf{T}}X X T X 固有値と固有ベクトル )によります。∇ 2 f ( w ) \nabla^2 f(\boldsymbol{w}) ∇ 2 f ( w ) ∥ ∇ 2 f ( w ) ∥ 2 ≤ λ max ( X T X ) / ( 4 N ) \|\nabla^2 f(\boldsymbol{w})\|_2 \le \lambda_{\max}(X^{\mathsf{T}}X)/(4N) ∥ ∇ 2 f ( w ) ∥ 2 ≤ λ m a x ( X T X ) / ( 4 N ) w \boldsymbol{w} w ∇ f \nabla f ∇ f L = λ max ( X T X ) / ( 4 N ) L = \lambda_{\max}(X^{\mathsf{T}}X)/(4N) L = λ m a x ( X T X ) / ( 4 N )
∎ 命題 6.1 の 2 と 3 を合わせると、ロジスティック回帰の学習は「凸で L L L 定理 4.5 がそのまま使える設定だと分かります。しかも L L L η = 4 N / λ max ( X T X ) \eta = 4N/\lambda_{\max}(X^{\mathsf{T}}X) η = 4 N / λ m a x ( X T X )
例 6.2 (4 点のデータで 2 ステップ手計算する )
手で最後まで追えるように、特徴量を 1 次元(バイアス項なし)にします。データを
( x 1 , y 1 ) = ( − 2 , 0 ) , ( x 2 , y 2 ) = ( − 1 , 0 ) , ( x 3 , y 3 ) = ( 1 , 1 ) , ( x 4 , y 4 ) = ( 2 , 1 ) (x_1,y_1) = (-2, 0),\quad (x_2,y_2) = (-1, 0),\quad (x_3,y_3) = (1, 1),\quad (x_4,y_4) = (2, 1) ( x 1 , y 1 ) = ( − 2 , 0 ) , ( x 2 , y 2 ) = ( − 1 , 0 ) , ( x 3 , y 3 ) = ( 1 , 1 ) , ( x 4 , y 4 ) = ( 2 , 1 ) とします。N = 4 N = 4 N = 4 ∑ i x i 2 = 4 + 1 + 1 + 4 = 10 \sum_i x_i^2 = 4+1+1+4 = 10 ∑ i x i 2 = 4 + 1 + 1 + 4 = 10 命題 6.1 の 3 より
L = 1 4 N ∑ i = 1 4 x i 2 = 10 16 = 0.625 , η = 1 L = 1.6. L = \frac{1}{4N}\sum_{i=1}^{4}x_i^2 = \frac{10}{16} = 0.625,
\qquad \eta = \frac{1}{L} = 1.6 . L = 4 N 1 i = 1 ∑ 4 x i 2 = 16 10 = 0.625 , η = L 1 = 1.6. 初期値 w 0 = 0 w_0 = 0 w 0 = 0 すべての i i i p i = σ ( 0 ) = 0.5 p_i = \sigma(0) = 0.5 p i = σ ( 0 ) = 0.5 f ( 0 ) = − log 0.5 = 0.693147 f(0) = -\log 0.5 = 0.693147 f ( 0 ) = − log 0.5 = 0.693147
∇ f ( 0 ) = 1 4 [ ( 0.5 − 0 ) ( − 2 ) + ( 0.5 − 0 ) ( − 1 ) + ( 0.5 − 1 ) ( 1 ) + ( 0.5 − 1 ) ( 2 ) ] = − 3 4 = − 0.75. \nabla f(0) = \frac{1}{4}\Bigl[(0.5-0)(-2) + (0.5-0)(-1) + (0.5-1)(1) + (0.5-1)(2)\Bigr] = \frac{-3}{4} = -0.75 . ∇ f ( 0 ) = 4 1 [ ( 0.5 − 0 ) ( − 2 ) + ( 0.5 − 0 ) ( − 1 ) + ( 0.5 − 1 ) ( 1 ) + ( 0.5 − 1 ) ( 2 ) ] = 4 − 3 = − 0.75. 負なので w w w w 1 = 0 − 1.6 × ( − 0.75 ) = 1.2 w_1 = 0 - 1.6\times(-0.75) = 1.2 w 1 = 0 − 1.6 × ( − 0.75 ) = 1.2
1 ステップ後。 z i = 1.2 x i z_i = 1.2x_i z i = 1.2 x i − 2.4 , − 1.2 , 1.2 , 2.4 -2.4,\ -1.2,\ 1.2,\ 2.4 − 2.4 , − 1.2 , 1.2 , 2.4 σ ( 2.4 ) = 1 / ( 1 + e − 2.4 ) = 1 / 1.090718 = 0.916827 \sigma(2.4) = 1/(1+e^{-2.4}) = 1/1.090718 = 0.916827 σ ( 2.4 ) = 1/ ( 1 + e − 2.4 ) = 1/1.090718 = 0.916827 σ ( 1.2 ) = 1 / ( 1 + e − 1.2 ) = 1 / 1.301194 = 0.768525 \sigma(1.2) = 1/(1+e^{-1.2}) = 1/1.301194 = 0.768525 σ ( 1.2 ) = 1/ ( 1 + e − 1.2 ) = 1/1.301194 = 0.768525 σ ( − z ) = 1 − σ ( z ) \sigma(-z) = 1-\sigma(z) σ ( − z ) = 1 − σ ( z ) σ ( − 1.2 ) = 0.231475 \sigma(-1.2) = 0.231475 σ ( − 1.2 ) = 0.231475 σ ( − 2.4 ) = 0.083173 \sigma(-2.4) = 0.083173 σ ( − 2.4 ) = 0.083173 − log σ ( z ) = log ( 1 + e − z ) -\log\sigma(z) = \log(1+e^{-z}) − log σ ( z ) = log ( 1 + e − z )
f ( 1.2 ) = 1 4 [ log ( 1 + e − 2.4 ) ⋅ 2 + log ( 1 + e − 1.2 ) ⋅ 2 ] = 2 ( 0.086836 ) + 2 ( 0.263282 ) 4 = 0.175059. f(1.2) = \frac{1}{4}\Bigl[\log(1+e^{-2.4})\cdot 2 + \log(1+e^{-1.2})\cdot 2\Bigr]
= \frac{2(0.086836) + 2(0.263282)}{4} = 0.175059 . f ( 1.2 ) = 4 1 [ log ( 1 + e − 2.4 ) ⋅ 2 + log ( 1 + e − 1.2 ) ⋅ 2 ] = 4 2 ( 0.086836 ) + 2 ( 0.263282 ) = 0.175059. (4 点とも正しく分類されているので、各点の損失は log ( 1 + e − ∣ z i ∣ ) \log(1+e^{-|z_i|}) log ( 1 + e − ∣ z i ∣ )
∇ f ( 1.2 ) = 1 4 [ ( 0.083173 ) ( − 2 ) + ( 0.231475 ) ( − 1 ) + ( 0.768525 − 1 ) ( 1 ) + ( 0.916827 − 1 ) ( 2 ) ] = − 0.795642 4 = − 0.198911. \nabla f(1.2) = \frac{1}{4}\Bigl[(0.083173)(-2) + (0.231475)(-1) + (0.768525-1)(1) + (0.916827-1)(2)\Bigr] = \frac{-0.795642}{4} = -0.198911 . ∇ f ( 1.2 ) = 4 1 [ ( 0.083173 ) ( − 2 ) + ( 0.231475 ) ( − 1 ) + ( 0.768525 − 1 ) ( 1 ) + ( 0.916827 − 1 ) ( 2 ) ] = 4 − 0.795642 = − 0.198911. よって w 2 = 1.2 + 1.6 × 0.198911 = 1.518257 w_2 = 1.2 + 1.6\times 0.198911 = 1.518257 w 2 = 1.2 + 1.6 × 0.198911 = 1.518257
2 ステップ後。 z i = ± 1.518257 , ± 3.036514 z_i = \pm 1.518257,\ \pm 3.036514 z i = ± 1.518257 , ± 3.036514 log ( 1 + e − 1.518257 ) = 0.198107 \log(1+e^{-1.518257}) = 0.198107 log ( 1 + e − 1.518257 ) = 0.198107 log ( 1 + e − 3.036514 ) = 0.046885 \log(1+e^{-3.036514}) = 0.046885 log ( 1 + e − 3.036514 ) = 0.046885
f ( 1.518257 ) = 2 ( 0.046885 ) + 2 ( 0.198107 ) 4 = 0.122496. f(1.518257) = \frac{2(0.046885) + 2(0.198107)}{4} = 0.122496 . f ( 1.518257 ) = 4 2 ( 0.046885 ) + 2 ( 0.198107 ) = 0.122496. 損失は 0.693147 → 0.175059 → 0.122496 0.693147 \to 0.175059 \to 0.122496 0.693147 → 0.175059 → 0.122496 系 4.4 が保証したとおりです。
命題 6.1 の勾配の式をもう一度見てください。1 回の更新のために N N N p i p_i p i x i \boldsymbol{x}_i x i O ( N n ) O(Nn) O ( N n ) N = 10 8 N = 10^{8} N = 1 0 8 定理 4.5 の O ( 1 / T ) O(1/T) O ( 1/ T ) 10 11 10^{11} 1 0 11
ここで発想を変えます。f f f N N N 平均 です。平均を正確に計算する代わりに、少数のサンプルで推定 すればどうでしょうか。世論調査で全有権者に聞かずに 1000 人の標本で支持率を推定するのと同じ考え方です。
定義 7.1 (確率的勾配降下法とミニバッチ ) ↗
目的関数が C 1 C^1 C 1
f ( w ) = 1 N ∑ i = 1 N f i ( w ) f(\boldsymbol{w}) = \frac{1}{N}\sum_{i=1}^{N} f_i(\boldsymbol{w}) f ( w ) = N 1 i = 1 ∑ N f i ( w ) の形をしているとします。各反復 k k k i k i_k i k { 1 , … , N } \{1,\ldots,N\} { 1 , … , N }
w k + 1 = w k − η k ∇ f i k ( w k ) \boldsymbol{w}_{k+1} = \boldsymbol{w}_k - \eta_k \nabla f_{i_k}(\boldsymbol{w}_k) w k + 1 = w k − η k ∇ f i k ( w k ) と更新する方法を確率的勾配降下法 (SGD)と呼びます。より一般に、B B B i k , 1 , … , i k , B i_{k,1},\ldots,i_{k,B} i k , 1 , … , i k , B
g B ( w k ) = 1 B ∑ j = 1 B ∇ f i k , j ( w k ) , w k + 1 = w k − η k g B ( w k ) \boldsymbol{g}_B(\boldsymbol{w}_k) = \frac{1}{B}\sum_{j=1}^{B}\nabla f_{i_{k,j}}(\boldsymbol{w}_k),
\qquad
\boldsymbol{w}_{k+1} = \boldsymbol{w}_k - \eta_k\,\boldsymbol{g}_B(\boldsymbol{w}_k) g B ( w k ) = B 1 j = 1 ∑ B ∇ f i k , j ( w k ) , w k + 1 = w k − η k g B ( w k ) とする方法をミニバッチ勾配降下法 と呼び、B B B バッチサイズ といいます。B = 1 B = 1 B = 1 B = N B = N B = N
この方法が意味を持つのは、次の二つの性質があるからです。
命題 7.2 (ミニバッチ勾配の不偏性と分散 ) ✓
定義 7.1 の設定で、w ∈ R n \boldsymbol{w} \in \mathbb{R}^n w ∈ R n i 1 , … , i B i_1,\ldots,i_B i 1 , … , i B { 1 , … , N } \{1,\ldots,N\} { 1 , … , N }
σ 2 ( w ) = 1 N ∑ i = 1 N ∥ ∇ f i ( w ) − ∇ f ( w ) ∥ 2 \sigma^2(\boldsymbol{w}) = \frac{1}{N}\sum_{i=1}^{N}\bigl\|\nabla f_i(\boldsymbol{w}) - \nabla f(\boldsymbol{w})\bigr\|^2 σ 2 ( w ) = N 1 i = 1 ∑ N ∇ f i ( w ) − ∇ f ( w ) 2 とおきます。このとき
E [ g B ( w ) ] = ∇ f ( w ) \mathbb{E}\bigl[\boldsymbol{g}_B(\boldsymbol{w})\bigr] = \nabla f(\boldsymbol{w}) E [ g B ( w ) ] = ∇ f ( w ) E [ ∥ g B ( w ) − ∇ f ( w ) ∥ 2 ] = σ 2 ( w ) B \mathbb{E}\bigl[\bigl\|\boldsymbol{g}_B(\boldsymbol{w}) - \nabla f(\boldsymbol{w})\bigr\|^2\bigr] = \dfrac{\sigma^2(\boldsymbol{w})}{B} E [ g B ( w ) − ∇ f ( w ) 2 ] = B σ 2 ( w ) が成り立ちます。
証明(命題 7.2) 1 の証明。 添字 i j i_j i j j j j 期待値(定義 4.1)[確率変数と期待値] )から
E [ ∇ f i j ( w ) ] = ∑ i = 1 N Pr [ i j = i ] ∇ f i ( w ) = ∑ i = 1 N 1 N ∇ f i ( w ) = ∇ f ( w ) \mathbb{E}\bigl[\nabla f_{i_j}(\boldsymbol{w})\bigr] = \sum_{i=1}^{N}\Pr[i_j = i]\,\nabla f_i(\boldsymbol{w}) = \sum_{i=1}^{N}\frac{1}{N}\nabla f_i(\boldsymbol{w}) = \nabla f(\boldsymbol{w}) E [ ∇ f i j ( w ) ] = i = 1 ∑ N Pr [ i j = i ] ∇ f i ( w ) = i = 1 ∑ N N 1 ∇ f i ( w ) = ∇ f ( w ) です。期待値の線形性より
E [ g B ( w ) ] = 1 B ∑ j = 1 B E [ ∇ f i j ( w ) ] = 1 B ⋅ B ∇ f ( w ) = ∇ f ( w ) . \mathbb{E}[\boldsymbol{g}_B(\boldsymbol{w})] = \frac{1}{B}\sum_{j=1}^{B}\mathbb{E}\bigl[\nabla f_{i_j}(\boldsymbol{w})\bigr] = \frac{1}{B}\cdot B\,\nabla f(\boldsymbol{w}) = \nabla f(\boldsymbol{w}). E [ g B ( w )] = B 1 j = 1 ∑ B E [ ∇ f i j ( w ) ] = B 1 ⋅ B ∇ f ( w ) = ∇ f ( w ) . 2 の証明。 ξ j = ∇ f i j ( w ) − ∇ f ( w ) \boldsymbol{\xi}_j = \nabla f_{i_j}(\boldsymbol{w}) - \nabla f(\boldsymbol{w}) ξ j = ∇ f i j ( w ) − ∇ f ( w ) E [ ξ j ] = 0 \mathbb{E}[\boldsymbol{\xi}_j] = \boldsymbol{0} E [ ξ j ] = 0 i 1 , … , i B i_1,\ldots,i_B i 1 , … , i B ξ 1 , … , ξ B \boldsymbol{\xi}_1,\ldots,\boldsymbol{\xi}_B ξ 1 , … , ξ B
E [ ∥ ξ j ∥ 2 ] = 1 N ∑ i = 1 N ∥ ∇ f i ( w ) − ∇ f ( w ) ∥ 2 = σ 2 ( w ) \mathbb{E}\bigl[\|\boldsymbol{\xi}_j\|^2\bigr] = \frac{1}{N}\sum_{i=1}^{N}\bigl\|\nabla f_i(\boldsymbol{w}) - \nabla f(\boldsymbol{w})\bigr\|^2 = \sigma^2(\boldsymbol{w}) E [ ∥ ξ j ∥ 2 ] = N 1 i = 1 ∑ N ∇ f i ( w ) − ∇ f ( w ) 2 = σ 2 ( w ) です。g B ( w ) − ∇ f ( w ) = 1 B ∑ j ξ j \boldsymbol{g}_B(\boldsymbol{w}) - \nabla f(\boldsymbol{w}) = \frac{1}{B}\sum_j \boldsymbol{\xi}_j g B ( w ) − ∇ f ( w ) = B 1 ∑ j ξ j
E [ ∥ 1 B ∑ j = 1 B ξ j ∥ 2 ] = 1 B 2 ∑ j = 1 B ∑ l = 1 B E [ ⟨ ξ j , ξ l ⟩ ] \mathbb{E}\left[\Bigl\|\frac{1}{B}\sum_{j=1}^{B}\boldsymbol{\xi}_j\Bigr\|^2\right]
= \frac{1}{B^2}\sum_{j=1}^{B}\sum_{l=1}^{B}\mathbb{E}\bigl[\langle \boldsymbol{\xi}_j, \boldsymbol{\xi}_l\rangle\bigr] E [ B 1 j = 1 ∑ B ξ j 2 ] = B 2 1 j = 1 ∑ B l = 1 ∑ B E [ ⟨ ξ j , ξ l ⟩ ] を得ます。j ≠ l j \ne l j = l ξ j \boldsymbol{\xi}_j ξ j ξ l \boldsymbol{\xi}_l ξ l E [ ⟨ ξ j , ξ l ⟩ ] = ⟨ E [ ξ j ] , E [ ξ l ] ⟩ = 0 \mathbb{E}[\langle \boldsymbol{\xi}_j,\boldsymbol{\xi}_l\rangle] = \langle \mathbb{E}[\boldsymbol{\xi}_j], \mathbb{E}[\boldsymbol{\xi}_l]\rangle = 0 E [⟨ ξ j , ξ l ⟩] = ⟨ E [ ξ j ] , E [ ξ l ]⟩ = 0 E [ ξ j ] = 0 \mathbb{E}[\boldsymbol{\xi}_j] = \boldsymbol{0} E [ ξ j ] = 0 j = l j = l j = l B B B
1 B 2 ∑ j = 1 B E [ ∥ ξ j ∥ 2 ] = 1 B 2 ⋅ B σ 2 ( w ) = σ 2 ( w ) B \frac{1}{B^2}\sum_{j=1}^{B}\mathbb{E}\bigl[\|\boldsymbol{\xi}_j\|^2\bigr] = \frac{1}{B^2}\cdot B\,\sigma^2(\boldsymbol{w}) = \frac{\sigma^2(\boldsymbol{w})}{B} B 2 1 j = 1 ∑ B E [ ∥ ξ j ∥ 2 ] = B 2 1 ⋅ B σ 2 ( w ) = B σ 2 ( w ) となります。
∎ 命題 7.2 は「ミニバッチ勾配は平均としては正しく、誤差の大きさは σ / B \sigma/\sqrt{B} σ / B 大数の法則と中心極限定理 )と同じ 1 / B 1/\sqrt{B} 1/ B B B B
例 7.3 (同じ計算予算で何歩進めるか )
N = 10 6 N = 10^6 N = 1 0 6 10 7 10^7 1 0 7
方法 1 歩のコスト 歩数 勾配の誤差の目安 勾配降下法(B = N B = N B = N 10 6 10^6 1 0 6 10 10 10 0 0 0 ミニバッチ(B = 100 B = 100 B = 100 100 100 100 10 5 10^5 1 0 5 σ / 10 \sigma/10 σ /10 SGD(B = 1 B = 1 B = 1 1 1 1 10 7 10^7 1 0 7 σ \sigma σ
勾配降下法は誤差ゼロの方向に 10 歩しか進めません。命題 5.1 で見たように、条件数が 100 程度の問題では 10 歩ではほとんど何も起きません。一方 SGD は方向が毎回大きくぶれますが 10 7 10^7 1 0 7
実際に使われるのは中間の B = 32 B = 32 B = 32 1024 1024 1024 B B B
勾配の情報だけを使う手法はここで打ち止めではありません。過去の更新方向を慣性として足すモーメンタム法、座標ごとに学習率を調整する AdaGrad や Adam などは、いずれも 定義 4.1 の一行を書き換えたものです。注意 3.4 で触れたとおり、これらは「どのノルムで最急降下を測るか」を暗黙に変えている、と解釈できます。次章のニューラルネットワークと逆伝播 では、この ∇ f ( w ) \nabla f(\boldsymbol{w}) ∇ f ( w ) 効率よく計算する 方法、すなわち連鎖律の巧妙な使い方を扱います。
演習 8.1 易
f ( w 1 , w 2 ) = w 1 2 + w 1 w 2 + w 2 2 f(w_1, w_2) = w_1^2 + w_1w_2 + w_2^2 f ( w 1 , w 2 ) = w 1 2 + w 1 w 2 + w 2 2 w = ( 1 , 2 ) T \boldsymbol{w} = (1,2)^{\mathsf{T}} w = ( 1 , 2 ) T
∇ f ( w ) \nabla f(\boldsymbol{w}) ∇ f ( w ) w \boldsymbol{w} w η ∥ ∇ f ( w ) ∥ \eta\|\nabla f(\boldsymbol{w})\| η ∥∇ f ( w ) ∥ w − η ∇ f ( w ) \boldsymbol{w} - \eta\nabla f(\boldsymbol{w}) w − η ∇ f ( w ) f f f η \eta η η \eta η 解答 1. 偏微分すると ∂ f / ∂ w 1 = 2 w 1 + w 2 \partial f/\partial w_1 = 2w_1 + w_2 ∂ f / ∂ w 1 = 2 w 1 + w 2 ∂ f / ∂ w 2 = w 1 + 2 w 2 \partial f/\partial w_2 = w_1 + 2w_2 ∂ f / ∂ w 2 = w 1 + 2 w 2
∇ f ( 1 , 2 ) = ( 2 ⋅ 1 + 2 , 1 + 2 ⋅ 2 ) T = ( 4 , 5 ) T , ∥ ∇ f ( 1 , 2 ) ∥ = 16 + 25 = 41 . \nabla f(1,2) = (2\cdot 1 + 2,\ 1 + 2\cdot 2)^{\mathsf{T}} = (4, 5)^{\mathsf{T}},
\qquad \|\nabla f(1,2)\| = \sqrt{16+25} = \sqrt{41}. ∇ f ( 1 , 2 ) = ( 2 ⋅ 1 + 2 , 1 + 2 ⋅ 2 ) T = ( 4 , 5 ) T , ∥∇ f ( 1 , 2 ) ∥ = 16 + 25 = 41 . 定理 3.2 より最急降下方向は − ∇ f / ∥ ∇ f ∥ = − ( 4 , 5 ) T / 41 -\nabla f/\|\nabla f\| = -(4,5)^{\mathsf{T}}/\sqrt{41} − ∇ f /∥∇ f ∥ = − ( 4 , 5 ) T / 41 − 41 ≈ − 6.403 -\sqrt{41} \approx -6.403 − 41 ≈ − 6.403
2. u = 1 − 4 η u = 1-4\eta u = 1 − 4 η v = 2 − 5 η v = 2-5\eta v = 2 − 5 η
u 2 = 1 − 8 η + 16 η 2 , u v = ( 1 − 4 η ) ( 2 − 5 η ) = 2 − 13 η + 20 η 2 , v 2 = 4 − 20 η + 25 η 2 \begin{aligned}
u^2 &= 1 - 8\eta + 16\eta^2, \\
uv &= (1-4\eta)(2-5\eta) = 2 - 13\eta + 20\eta^2, \\
v^2 &= 4 - 20\eta + 25\eta^2
\end{aligned} u 2 uv v 2 = 1 − 8 η + 16 η 2 , = ( 1 − 4 η ) ( 2 − 5 η ) = 2 − 13 η + 20 η 2 , = 4 − 20 η + 25 η 2 なので
g ( η ) = f ( 1 − 4 η , 2 − 5 η ) = u 2 + u v + v 2 = 7 − 41 η + 61 η 2 . g(\eta) = f(1-4\eta,\ 2-5\eta) = u^2 + uv + v^2 = 7 - 41\eta + 61\eta^2 . g ( η ) = f ( 1 − 4 η , 2 − 5 η ) = u 2 + uv + v 2 = 7 − 41 η + 61 η 2 . η = 0 \eta = 0 η = 0 g ( 0 ) = 7 = f ( 1 , 2 ) g(0) = 7 = f(1,2) g ( 0 ) = 7 = f ( 1 , 2 ) g ′ ( η ) = − 41 + 122 η = 0 g'(\eta) = -41 + 122\eta = 0 g ′ ( η ) = − 41 + 122 η = 0 η = 41 / 122 ≈ 0.336 \eta = 41/122 \approx 0.336 η = 41/122 ≈ 0.336 g g g
g ( 41 122 ) = 7 − 41 2 122 + 61 ⋅ 41 2 122 2 = 7 − 1681 122 + 1681 244 = 7 − 1681 244 = 27 244 ≈ 0.1107. g\!\left(\frac{41}{122}\right) = 7 - \frac{41^2}{122} + \frac{61\cdot 41^2}{122^2} = 7 - \frac{1681}{122} + \frac{1681}{244} = 7 - \frac{1681}{244} = \frac{27}{244} \approx 0.1107 . g ( 122 41 ) = 7 − 122 4 1 2 + 12 2 2 61 ⋅ 4 1 2 = 7 − 122 1681 + 244 1681 = 7 − 244 1681 = 244 27 ≈ 0.1107. 参考までに、f ( w ) = 1 2 ⟨ w , A w ⟩ f(\boldsymbol{w}) = \frac{1}{2}\langle \boldsymbol{w}, A\boldsymbol{w}\rangle f ( w ) = 2 1 ⟨ w , A w ⟩ A = ( 2 1 1 2 ) A = \begin{pmatrix}2 & 1\\ 1 & 2\end{pmatrix} A = ( 2 1 1 2 ) 命題 5.1 の固有値は λ 1 = 1 \lambda_1 = 1 λ 1 = 1 λ 2 = 3 \lambda_2 = 3 λ 2 = 3 η ⋆ = 2 / ( 1 + 3 ) = 0.5 \eta_\star = 2/(1+3) = 0.5 η ⋆ = 2/ ( 1 + 3 ) = 0.5 41 / 122 41/122 41/122
演習 8.2 標準
f : R n → R f : \mathbb{R}^n\to\mathbb{R} f : R n → R C 1 C^1 C 1 L L L
∇ f ( w k ) ≠ 0 \nabla f(\boldsymbol{w}_k) \ne \boldsymbol{0} ∇ f ( w k ) = 0 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L f ( w k + 1 ) < f ( w k ) f(\boldsymbol{w}_{k+1}) < f(\boldsymbol{w}_k) f ( w k + 1 ) < f ( w k ) η = 2 / L \eta = 2/L η = 2/ L 解答 1. 系 4.4 がそのまま答えです。w k + 1 = w k − η ∇ f ( w k ) \boldsymbol{w}_{k+1} = \boldsymbol{w}_k - \eta\nabla f(\boldsymbol{w}_k) w k + 1 = w k − η ∇ f ( w k )
f ( w k + 1 ) ≤ f ( w k ) − η ( 1 − L η 2 ) ∥ ∇ f ( w k ) ∥ 2 f(\boldsymbol{w}_{k+1}) \le f(\boldsymbol{w}_k) - \eta\Bigl(1 - \frac{L\eta}{2}\Bigr)\|\nabla f(\boldsymbol{w}_k)\|^2 f ( w k + 1 ) ≤ f ( w k ) − η ( 1 − 2 L η ) ∥∇ f ( w k ) ∥ 2 であり、0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L η > 0 \eta > 0 η > 0 1 − L η / 2 > 0 1 - L\eta/2 > 0 1 − L η /2 > 0 η ( 1 − L η / 2 ) \eta(1-L\eta/2) η ( 1 − L η /2 ) ∥ ∇ f ( w k ) ∥ 2 > 0 \|\nabla f(\boldsymbol{w}_k)\|^2 > 0 ∥∇ f ( w k ) ∥ 2 > 0
2. n = 1 n = 1 n = 1 f ( w ) = L 2 w 2 f(w) = \frac{L}{2}w^2 f ( w ) = 2 L w 2 f ′ ( w ) = L w f'(w) = Lw f ′ ( w ) = L w ∣ f ′ ( u ) − f ′ ( v ) ∣ = L ∣ u − v ∣ |f'(u)-f'(v)| = L|u-v| ∣ f ′ ( u ) − f ′ ( v ) ∣ = L ∣ u − v ∣ f f f L L L η = 2 / L \eta = 2/L η = 2/ L
w k + 1 = w k − 2 L ⋅ L w k = − w k w_{k+1} = w_k - \frac{2}{L}\cdot L w_k = -w_k w k + 1 = w k − L 2 ⋅ L w k = − w k なので、w 0 ≠ 0 w_0 \ne 0 w 0 = 0 w k w_k w k w 0 w_0 w 0 − w 0 -w_0 − w 0 f ( w k ) = L 2 w 0 2 f(w_k) = \frac{L}{2}w_0^2 f ( w k ) = 2 L w 0 2 0 0 0 0 < η < 2 / L 0 < \eta < 2/L 0 < η < 2/ L 例 5.2 の η = 0.08 \eta = 0.08 η = 0.08
演習 8.3 標準
命題 6.1 の設定で、特徴ベクトルがすべて ∥ x i ∥ ≤ R \|\boldsymbol{x}_i\| \le R ∥ x i ∥ ≤ R f f f L = R 2 / 4 L = R^2/4 L = R 2 /4 L L L λ max ( X T X ) \lambda_{\max}(X^{\mathsf{T}}X) λ m a x ( X T X )
解答 命題 6.1 の 2 の二次形式に、p i ( 1 − p i ) ≤ 1 / 4 p_i(1-p_i)\le 1/4 p i ( 1 − p i ) ≤ 1/4 ⟨ x i , v ⟩ 2 ≤ ∥ x i ∥ 2 ∥ v ∥ 2 ≤ R 2 ∥ v ∥ 2 \langle \boldsymbol{x}_i,\boldsymbol{v}\rangle^2 \le \|\boldsymbol{x}_i\|^2\|\boldsymbol{v}\|^2 \le R^2\|\boldsymbol{v}\|^2 ⟨ x i , v ⟩ 2 ≤ ∥ x i ∥ 2 ∥ v ∥ 2 ≤ R 2 ∥ v ∥ 2
⟨ v , ∇ 2 f ( w ) v ⟩ = 1 N ∑ i = 1 N p i ( 1 − p i ) ⟨ x i , v ⟩ 2 ≤ 1 N ⋅ N ⋅ 1 4 R 2 ∥ v ∥ 2 = R 2 4 ∥ v ∥ 2 . \bigl\langle \boldsymbol{v}, \nabla^2 f(\boldsymbol{w})\boldsymbol{v}\bigr\rangle
= \frac{1}{N}\sum_{i=1}^{N}p_i(1-p_i)\langle \boldsymbol{x}_i,\boldsymbol{v}\rangle^2
\le \frac{1}{N}\cdot N\cdot \frac{1}{4}R^2\|\boldsymbol{v}\|^2
= \frac{R^2}{4}\|\boldsymbol{v}\|^2 . ⟨ v , ∇ 2 f ( w ) v ⟩ = N 1 i = 1 ∑ N p i ( 1 − p i ) ⟨ x i , v ⟩ 2 ≤ N 1 ⋅ N ⋅ 4 1 R 2 ∥ v ∥ 2 = 4 R 2 ∥ v ∥ 2 . 半正定値対称行列の作用素ノルムはレイリー商の上限に等しいので ∥ ∇ 2 f ( w ) ∥ 2 ≤ R 2 / 4 \|\nabla^2 f(\boldsymbol{w})\|_2 \le R^2/4 ∥ ∇ 2 f ( w ) ∥ 2 ≤ R 2 /4 ∇ f \nabla f ∇ f R 2 / 4 R^2/4 R 2 /4
比較のため λ max ( X T X ) / ( 4 N ) \lambda_{\max}(X^{\mathsf{T}}X)/(4N) λ m a x ( X T X ) / ( 4 N ) X T X = ∑ i x i x i T X^{\mathsf{T}}X = \sum_i \boldsymbol{x}_i\boldsymbol{x}_i^{\mathsf{T}} X T X = ∑ i x i x i T ∑ i ∥ x i ∥ 2 ≤ N R 2 \sum_i\|\boldsymbol{x}_i\|^2 \le NR^2 ∑ i ∥ x i ∥ 2 ≤ N R 2 λ max \lambda_{\max} λ m a x
λ max ( X T X ) 4 N ≤ N R 2 4 N = R 2 4 \frac{\lambda_{\max}(X^{\mathsf{T}}X)}{4N} \le \frac{NR^2}{4N} = \frac{R^2}{4} 4 N λ m a x ( X T X ) ≤ 4 N N R 2 = 4 R 2 となり、この場合は固有値による評価のほうが常に良いことが分かります。等号は全サンプルが同じ 1 本の直線上に乗り、かつ ∥ x i ∥ = R \|\boldsymbol{x}_i\| = R ∥ x i ∥ = R λ max \lambda_{\max} λ m a x N R 2 NR^2 N R 2 λ max \lambda_{\max} λ m a x O ( N n 2 ) O(Nn^2) O ( N n 2 ) R R R
演習 8.4 標準
注意 7.4 のロビンス・モンロー条件について答えてください。
η k = η 0 / ( k + 1 ) \eta_k = \eta_0/(k+1) η k = η 0 / ( k + 1 ) η 0 > 0 \eta_0 > 0 η 0 > 0 η k = η 0 / k + 1 \eta_k = \eta_0/\sqrt{k+1} η k = η 0 / k + 1 η k = η 0 γ k \eta_k = \eta_0 \gamma^k η k = η 0 γ k 0 < γ < 1 0 < \gamma < 1 0 < γ < 1 解答 1. ∑ k ≥ 0 η 0 / ( k + 1 ) = η 0 ∑ m ≥ 1 1 / m \sum_{k\ge 0}\eta_0/(k+1) = \eta_0\sum_{m\ge 1} 1/m ∑ k ≥ 0 η 0 / ( k + 1 ) = η 0 ∑ m ≥ 1 1/ m ∑ k ≥ 0 η 0 2 / ( k + 1 ) 2 = η 0 2 ∑ m ≥ 1 1 / m 2 = η 0 2 π 2 / 6 < ∞ \sum_{k\ge 0}\eta_0^2/(k+1)^2 = \eta_0^2\sum_{m\ge1}1/m^2 = \eta_0^2\pi^2/6 < \infty ∑ k ≥ 0 η 0 2 / ( k + 1 ) 2 = η 0 2 ∑ m ≥ 1 1/ m 2 = η 0 2 π 2 /6 < ∞ 級数と収束判定 )。
2. ∑ k ≥ 0 η 0 / k + 1 = η 0 ∑ m ≥ 1 m − 1 / 2 \sum_{k\ge0}\eta_0/\sqrt{k+1} = \eta_0\sum_{m\ge1}m^{-1/2} ∑ k ≥ 0 η 0 / k + 1 = η 0 ∑ m ≥ 1 m − 1/2 p p p p = 1 / 2 ≤ 1 p = 1/2 \le 1 p = 1/2 ≤ 1 ∑ k ≥ 0 η 0 2 / ( k + 1 ) = η 0 2 ∑ m ≥ 1 1 / m \sum_{k\ge0}\eta_0^2/(k+1) = \eta_0^2\sum_{m\ge1}1/m ∑ k ≥ 0 η 0 2 / ( k + 1 ) = η 0 2 ∑ m ≥ 1 1/ m
3. 等比級数なので ∑ k η 0 γ k = η 0 / ( 1 − γ ) < ∞ \sum_k \eta_0\gamma^k = \eta_0/(1-\gamma) < \infty ∑ k η 0 γ k = η 0 / ( 1 − γ ) < ∞ ∑ k η 0 2 γ 2 k = η 0 2 / ( 1 − γ 2 ) < ∞ \sum_k \eta_0^2\gamma^{2k} = \eta_0^2/(1-\gamma^2) < \infty ∑ k η 0 2 γ 2 k = η 0 2 / ( 1 − γ 2 ) < ∞ η 0 ∑ k ∥ ∇ f i k ∥ \eta_0\sum_k\|\nabla f_{i_k}\| η 0 ∑ k ∥∇ f i k ∥
A.-L. Cauchy, “Méthode générale pour la résolution des systèmes d’équations simultanées”, Comptes Rendus de l’Académie des Sciences 25 (1847), 536–538. — 勾配降下法の原論文。2 ページ半で、現代の教科書と同じ発想が述べられています。
S. Boyd, L. Vandenberghe, Convex Optimization , Cambridge University Press, 2004 — 第 9 章「Unconstrained minimization」。降下方向・直線探索・収束解析が体系的にまとまっています。全文が 著者のページ で公開されています。
J. Nocedal, S. J. Wright, Numerical Optimization , 2nd ed., Springer, 2006 — 第 3 章「Line Search Methods」。ウルフ条件など、学習率を自動で決める古典的な方法が詳しく扱われています。
H. Robbins, S. Monro, “A Stochastic Approximation Method”, The Annals of Mathematical Statistics 22 (1951), 400–407. DOI: 10.1214/aoms/1177729586 — 確率的近似法の原論文。注意 7.4 の学習率条件の出典です。
L. Bottou, F. E. Curtis, J. Nocedal, “Optimization Methods for Large-Scale Machine Learning”, SIAM Review 60 (2018), 223–311. arXiv:1606.04838 — 大規模学習における確率的手法の総説。バッチサイズと収束の関係が丁寧に議論されています。
I. Goodfellow, Y. Bengio, A. Courville, Deep Learning , MIT Press, 2016 — 第 4 章「Numerical Computation」、第 8 章「Optimization for Training Deep Models」。モーメンタムや Adam など実用的な改良の位置づけが分かります。全文が 公式サイト で公開されています。
示したいこと。 本文では 命題 6.1 と 演習 8.3 で「ヘッセ行列の作用素ノルムが L L L L L L 定義 4.2 は勾配のリプシッツ連続性で述べられているので、2 階微分の情報からそこへ渡る橋が要ります。それがこの補足です。主張は次のとおりです。f : R n → R f : \mathbb{R}^n\to\mathbb{R} f : R n → R C 2 C^2 C 2 L > 0 L > 0 L > 0 w \boldsymbol{w} w ∥ ∇ 2 f ( w ) ∥ 2 ≤ L \|\nabla^2 f(\boldsymbol{w})\|_2 \le L ∥ ∇ 2 f ( w ) ∥ 2 ≤ L f f f L L L
証明。 u , v ∈ R n \boldsymbol{u}, \boldsymbol{v} \in \mathbb{R}^n u , v ∈ R n d = v − u \boldsymbol{d} = \boldsymbol{v}-\boldsymbol{u} d = v − u ψ ( t ) = ∇ f ( u + t d ) \boldsymbol{\psi}(t) = \nabla f(\boldsymbol{u} + t\boldsymbol{d}) ψ ( t ) = ∇ f ( u + t d ) t ∈ [ 0 , 1 ] t\in[0,1] t ∈ [ 0 , 1 ] f f f C 2 C^2 C 2 ψ \boldsymbol{\psi} ψ C 1 C^1 C 1 ψ ′ ( t ) = ∇ 2 f ( u + t d ) d \boldsymbol{\psi}'(t) = \nabla^2 f(\boldsymbol{u}+t\boldsymbol{d})\,\boldsymbol{d} ψ ′ ( t ) = ∇ 2 f ( u + t d ) d
∇ f ( v ) − ∇ f ( u ) = ψ ( 1 ) − ψ ( 0 ) = ∫ 0 1 ∇ 2 f ( u + t d ) d d t \nabla f(\boldsymbol{v}) - \nabla f(\boldsymbol{u}) = \boldsymbol{\psi}(1) - \boldsymbol{\psi}(0) = \int_0^1 \nabla^2 f(\boldsymbol{u}+t\boldsymbol{d})\,\boldsymbol{d}\ dt ∇ f ( v ) − ∇ f ( u ) = ψ ( 1 ) − ψ ( 0 ) = ∫ 0 1 ∇ 2 f ( u + t d ) d d t を得ます。ベクトル値積分に対する三角不等式 ∥ ∫ 0 1 ϕ ( t ) d t ∥ ≤ ∫ 0 1 ∥ ϕ ( t ) ∥ d t \bigl\|\int_0^1 \boldsymbol{\phi}(t)dt\bigr\| \le \int_0^1\|\boldsymbol{\phi}(t)\|dt ∫ 0 1 ϕ ( t ) d t ≤ ∫ 0 1 ∥ ϕ ( t ) ∥ d t ∥ H d ∥ ≤ ∥ H ∥ 2 ∥ d ∥ \|H\boldsymbol{d}\| \le \|H\|_2\|\boldsymbol{d}\| ∥ H d ∥ ≤ ∥ H ∥ 2 ∥ d ∥
∥ ∇ f ( v ) − ∇ f ( u ) ∥ ≤ ∫ 0 1 ∥ ∇ 2 f ( u + t d ) d ∥ d t ≤ ∫ 0 1 L ∥ d ∥ d t = L ∥ v − u ∥ \bigl\|\nabla f(\boldsymbol{v}) - \nabla f(\boldsymbol{u})\bigr\|
\le \int_0^1 \bigl\|\nabla^2 f(\boldsymbol{u}+t\boldsymbol{d})\,\boldsymbol{d}\bigr\|\,dt
\le \int_0^1 L\|\boldsymbol{d}\|\,dt = L\|\boldsymbol{v}-\boldsymbol{u}\| ∇ f ( v ) − ∇ f ( u ) ≤ ∫ 0 1 ∇ 2 f ( u + t d ) d d t ≤ ∫ 0 1 L ∥ d ∥ d t = L ∥ v − u ∥ となり、定義 4.2 の条件が示せました。
対称行列の作用素ノルムと固有値。 本文では「対称半正定値行列 H H H ∥ H ∥ 2 = λ max ( H ) \|H\|_2 = \lambda_{\max}(H) ∥ H ∥ 2 = λ m a x ( H ) スペクトル定理 から出ます。H H H q 1 , … , q n \boldsymbol{q}_1,\ldots,\boldsymbol{q}_n q 1 , … , q n μ 1 , … , μ n \mu_1,\ldots,\mu_n μ 1 , … , μ n v = ∑ i c i q i \boldsymbol{v} = \sum_i c_i\boldsymbol{q}_i v = ∑ i c i q i
∥ H v ∥ 2 = ∥ ∑ i μ i c i q i ∥ 2 = ∑ i μ i 2 c i 2 ≤ ( max i μ i 2 ) ∑ i c i 2 = ( max i ∣ μ i ∣ ) 2 ∥ v ∥ 2 \|H\boldsymbol{v}\|^2 = \Bigl\|\sum_i \mu_i c_i \boldsymbol{q}_i\Bigr\|^2 = \sum_i \mu_i^2 c_i^2 \le \bigl(\max_i \mu_i^2\bigr)\sum_i c_i^2 = \bigl(\max_i|\mu_i|\bigr)^2\|\boldsymbol{v}\|^2 ∥ H v ∥ 2 = i ∑ μ i c i q i 2 = i ∑ μ i 2 c i 2 ≤ ( i max μ i 2 ) i ∑ c i 2 = ( i max ∣ μ i ∣ ) 2 ∥ v ∥ 2 であり、最大値を与える固有ベクトルで等号が成り立つので ∥ H ∥ 2 = max i ∣ μ i ∣ \|H\|_2 = \max_i|\mu_i| ∥ H ∥ 2 = max i ∣ μ i ∣ λ max ( H ) \lambda_{\max}(H) λ m a x ( H )
なぜ C 2 C^2 C 2 本文の 補題 4.3 (降下補題)は C 1 C^1 C 1 L L L L L L