コンピュータが直接作れるのは、どの値も同じ確率で出るくじ引きのような乱数(一様乱数)です。ところが実際の計算では、正規分布に従う値や、目の出やすさに偏りのあるサイコロのような、偏った乱数が必要になります。この記事は、くじ引きの乱数だけを材料にして、望みの偏りをもつ乱数を正確に作る方法を、なぜ正確になるかの証明つきで説明します。読み終えると、目的の分布に応じてどの方法を選べばよいかと、各方法で何に気をつけるべきかが分かります。
U U U ( 0 , 1 ) (0,1) ( 0 , 1 ) 分布関数 F F F F F F F − ( u ) = inf { x : F ( x ) ≥ u } F^{-}(u) = \inf\{x : F(x) \ge u\} F − ( u ) = inf { x : F ( x ) ≥ u } F − ( U ) F^{-}(U) F − ( U ) F F F F F F 定理 3.3 )。棄却法 は、f ≤ M g f \le Mg f ≤ M g g g g f / ( M g ) f/(Mg) f / ( M g ) f f f f f f f ≤ M g f \le Mg f ≤ M g f f f min ( f , M g ) \min(f, Mg) min ( f , M g ) 定理 4.2 )。正規乱数は変数変換で作ります。Box–Muller 法は 2 個の一様乱数から独立な標準正規乱数を 2 個作り(命題 5.2 )、共分散 Σ = L L T \Sigma = LL^{\mathsf{T}} Σ = L L T μ + L Z \mu + LZ μ + L Z 命題 5.3 )。
n n n n n n O ( 1 ) O(1) O ( 1 ) 別名法 の根拠です(定理 6.2 )。一様な順列は Fisher–Yates の方法で作ります。全要素を無作為な位置と交換する素朴な方法は、n ≥ 3 n \ge 3 n ≥ 3 定理 6.3 )。
倍精度の一様乱数は 2 − 53 2^{-53} 2 − 53 36.7 36.7 36.7 8.2 8.2 8.2 命題 3.5 )。
確率変数 : 試行の結果に応じて値が決まる量を、数学的に可測な関数として扱ったもの。→ 確率変数 期待値 : 確率変数の値を確率で重みづけして平均したもの。→ 期待値 分布関数 : 確率変数が x x x x x x 分布関数 特性関数 : 分布を E [ e i t X ] \mathbb{E}[e^{i t X}] E [ e i tX ] 特性関数 擬似乱数生成器 : 決まった規則から、乱数のように見える列を作る仕組み。→ 擬似乱数生成器 前章 の生成器が返すのは、整数の上の(近似的に)一様な乱数です。ところが Monte Carlo 法で必要なのは、正規分布、指数分布、指定した重みをもつ離散分布、球面上の一様分布、といったさまざまな分布からの標本です。この章の問題は、独立な一様乱数の列だけを材料にして、指定した分布に正確に従う確率変数を作ること です。
「正確に」が要点です。たとえば 12 個の一様乱数の和から 6 を引くと正規分布に似た乱数ができますが、その分布は正規分布ではなく、∣ x ∣ > 6 |x| > 6 ∣ x ∣ > 6 ( 0 , 1 ) (0,1) ( 0 , 1 ) 命題 3.5 )の 2 点に限られます。
方法は 3 つの系統に分かれます。分布関数の逆関数を使う方法(§3)、作りやすい分布から作って捨てる方法(§4)、変数変換で作る方法(§5)です。離散分布と順列には専用の方法があります(§6)。
確率変数・分布・分布関数・期待値は確率変数と期待値 (定義 3.5[確率変数と期待値] )の定義に従います。R d \mathbb{R}^d R d m m m
定義 2.1 (密度・一様分布 ) ↗
R d \mathbb{R}^d R d X X X 密度 p p p p : R d → [ 0 , ∞ ) p : \mathbb{R}^d \to [0, \infty) p : R d → [ 0 , ∞ ) B B B P ( X ∈ B ) = ∫ B p ( x ) d x \mathbb{P}(X \in B) = \int_B p(x)\,dx P ( X ∈ B ) = ∫ B p ( x ) d x 0 < m ( A ) < ∞ 0 < m(A) < \infty 0 < m ( A ) < ∞ A A A 1 A / m ( A ) \mathbf{1}_A/m(A) 1 A / m ( A ) A A A ( 0 , 1 ) (0,1) ( 0 , 1 ) U ( 0 , 1 ) \mathrm{U}(0,1) U ( 0 , 1 ) U ∼ U ( 0 , 1 ) U \sim \mathrm{U}(0,1) U ∼ U ( 0 , 1 ) 0 ≤ t ≤ 1 0 \le t \le 1 0 ≤ t ≤ 1 P ( U ≤ t ) = t \mathbb{P}(U \le t) = t P ( U ≤ t ) = t
独立な確率変数(定義 2.3[確率変数と期待値] )を並べたベクトルの密度は、密度の積です。この事実を何度も使うので、補題にしておきます。
補題 2.2 (独立な確率変数の同時密度 ) ✓
実確率変数 X 1 , … , X n X_1, \ldots, X_n X 1 , … , X n X i X_i X i p i p_i p i ( X 1 , … , X n ) (X_1, \ldots, X_n) ( X 1 , … , X n ) p ( x ) = p 1 ( x 1 ) ⋯ p n ( x n ) p(x) = p_1(x_1)\cdots p_n(x_n) p ( x ) = p 1 ( x 1 ) ⋯ p n ( x n )
証明(補題 2.2) B ( R n ) \mathcal{B}(\mathbb{R}^n) B ( R n ) μ ( B ) = P ( ( X 1 , … , X n ) ∈ B ) \mu(B) = \mathbb{P}((X_1, \ldots, X_n) \in B) μ ( B ) = P (( X 1 , … , X n ) ∈ B ) ν ( B ) = ∫ B p ( x ) d x \nu(B) = \int_B p(x)\,dx ν ( B ) = ∫ B p ( x ) d x μ \mu μ ν \nu ν 定理 3.3[直積測度と Fubini–Tonelli の定理] )から ν ( R n ) = ∏ i ∫ p i = 1 \nu(\mathbb{R}^n) = \prod_i \int p_i = 1 ν ( R n ) = ∏ i ∫ p i = 1
箱 B = B 1 × ⋯ × B n B = B_1 \times \cdots \times B_n B = B 1 × ⋯ × B n B i ∈ B ( R ) B_i \in \mathcal{B}(\mathbb{R}) B i ∈ B ( R ) μ ( B ) = ∏ i P ( X i ∈ B i ) = ∏ i ∫ B i p i \mu(B) = \prod_i \mathbb{P}(X_i \in B_i) = \prod_i \int_{B_i} p_i μ ( B ) = ∏ i P ( X i ∈ B i ) = ∏ i ∫ B i p i ν ( B ) = ∏ i ∫ B i p i \nu(B) = \prod_i \int_{B_i} p_i ν ( B ) = ∏ i ∫ B i p i R n \mathbb{R}^n R n B ( R n ) \mathcal{B}(\mathbb{R}^n) B ( R n ) 命題 2.3[直積測度と Fubini–Tonelli の定理] )。測度の一意性(定理 4.5[測度空間と Carathéodory の拡張定理] )から μ = ν \mu = \nu μ = ν
∎ NumPy の Generator.random は、64 ビットの出力の上位 53 ビットを整数 k k k k 2 − 53 k\,2^{-53} k 2 − 53 G 53 G_{53} G 53 U ∼ U ( 0 , 1 ) U \sim \mathrm{U}(0,1) U ∼ U ( 0 , 1 ) G 53 G_{53} G 53 命題 3.5 で調べます。
分布関数 F F F F − 1 F^{-1} F − 1 P ( F − 1 ( U ) ≤ x ) = P ( U ≤ F ( x ) ) = F ( x ) \mathbb{P}(F^{-1}(U) \le x) = \mathbb{P}(U \le F(x)) = F(x) P ( F − 1 ( U ) ≤ x ) = P ( U ≤ F ( x )) = F ( x ) F F F
定義 3.1 (一般化逆関数(分位点関数) ) ↗
F : R → [ 0 , 1 ] F : \mathbb{R} \to [0,1] F : R → [ 0 , 1 ] lim x → − ∞ F ( x ) = 0 \lim_{x\to-\infty}F(x) = 0 lim x → − ∞ F ( x ) = 0 lim x → ∞ F ( x ) = 1 \lim_{x\to\infty}F(x) = 1 lim x → ∞ F ( x ) = 1 命題 3.6[確率変数と期待値] )。0 < u < 1 0 < u < 1 0 < u < 1
F − ( u ) = inf { x ∈ R : F ( x ) ≥ u } F^{-}(u) = \inf\{x \in \mathbb{R} : F(x) \ge u\} F − ( u ) = inf { x ∈ R : F ( x ) ≥ u } を F F F 一般化逆関数 (分位点関数)という。
補題 3.2 (一般化逆関数の基本性質 ) ✓
分布関数 F F F 0 < u < 1 0 < u < 1 0 < u < 1 x ∈ R x \in \mathbb{R} x ∈ R F − ( u ) F^{-}(u) F − ( u )
F − ( u ) ≤ x ⟺ u ≤ F ( x ) F^{-}(u) \le x \iff u \le F(x) F − ( u ) ≤ x ⟺ u ≤ F ( x ) が成り立つ。
証明(補題 3.2) A u = { x : F ( x ) ≥ u } A_u = \{x : F(x) \ge u\} A u = { x : F ( x ) ≥ u } lim x → ∞ F ( x ) = 1 > u \lim_{x\to\infty}F(x) = 1 > u lim x → ∞ F ( x ) = 1 > u A u A_u A u lim x → − ∞ F ( x ) = 0 < u \lim_{x\to-\infty}F(x) = 0 < u lim x → − ∞ F ( x ) = 0 < u A u A_u A u q = inf A u = F − ( u ) q = \inf A_u = F^{-}(u) q = inf A u = F − ( u ) F F F x ∈ A u x \in A_u x ∈ A u x ′ ≥ x x' \ge x x ′ ≥ x x ′ ∈ A u x' \in A_u x ′ ∈ A u A u A_u A u x n ↓ q x_n \downarrow q x n ↓ q F ( q ) = lim n F ( x n ) ≥ u F(q) = \lim_n F(x_n) \ge u F ( q ) = lim n F ( x n ) ≥ u q ∈ A u q \in A_u q ∈ A u A u = [ q , ∞ ) A_u = [q, \infty) A u = [ q , ∞ ) u ≤ F ( x ) ⟺ x ≥ q u \le F(x) \iff x \ge q u ≤ F ( x ) ⟺ x ≥ q
∎ 証明の方針です。1 は、補題で「F − ( U ) ≤ x F^{-}(U) \le x F − ( U ) ≤ x U ≤ F ( x ) U \le F(x) U ≤ F ( x ) U U U U U U t t t t t t F ( X ) F(X) F ( X ) u u u u u u u u u
証明(定理 3.3) 1. 補題 3.2 から、任意の x ∈ R x \in \mathbb{R} x ∈ R
{ F − ( U ) ≤ x } = { U ≤ F ( x ) } \{F^{-}(U) \le x\} = \{U \le F(x)\} { F − ( U ) ≤ x } = { U ≤ F ( x )} です。右辺は事象なので、F − ( U ) F^{-}(U) F − ( U ) 系 3.3[確率変数と期待値] )。確率を取ると P ( F − ( U ) ≤ x ) = P ( U ≤ F ( x ) ) = F ( x ) \mathbb{P}(F^{-}(U) \le x) = \mathbb{P}(U \le F(x)) = F(x) P ( F − ( U ) ≤ x ) = P ( U ≤ F ( x )) = F ( x )
2. 0 < u < 1 0 < u < 1 0 < u < 1 q = F − ( u ) q = F^{-}(u) q = F − ( u ) 補題 3.2 から { F ( X ) ≥ u } = { X ≥ q } \{F(X) \ge u\} = \{X \ge q\} { F ( X ) ≥ u } = { X ≥ q } F ( q ) = u F(q) = u F ( q ) = u x = q x = q x = q F ( q ) ≥ u F(q) \ge u F ( q ) ≥ u x < q x < q x < q F ( x ) < u F(x) < u F ( x ) < u x ↑ q x \uparrow q x ↑ q F F F F ( q ) ≤ u F(q) \le u F ( q ) ≤ u F F F P ( X = q ) = F ( q ) − lim x ↑ q F ( x ) = 0 \mathbb{P}(X = q) = F(q) - \lim_{x \uparrow q}F(x) = 0 P ( X = q ) = F ( q ) − lim x ↑ q F ( x ) = 0
P ( F ( X ) ≥ u ) = P ( X ≥ q ) = 1 − P ( X ≤ q ) + P ( X = q ) = 1 − F ( q ) = 1 − u , \mathbb{P}(F(X) \ge u) = \mathbb{P}(X \ge q) = 1 - \mathbb{P}(X \le q) + \mathbb{P}(X = q) = 1 - F(q) = 1 - u, P ( F ( X ) ≥ u ) = P ( X ≥ q ) = 1 − P ( X ≤ q ) + P ( X = q ) = 1 − F ( q ) = 1 − u , すなわち P ( F ( X ) < u ) = u \mathbb{P}(F(X) < u) = u P ( F ( X ) < u ) = u 0 < u < 1 0 < u < 1 0 < u < 1 0 < u < 1 0 < u < 1 0 < u < 1 { F ( X ) < u + 1 / n } \{F(X) < u + 1/n\} { F ( X ) < u + 1/ n } n → ∞ n \to \infty n → ∞ { F ( X ) ≤ u } \{F(X) \le u\} { F ( X ) ≤ u } P ( F ( X ) ≤ u ) = lim n ( u + 1 / n ) = u \mathbb{P}(F(X) \le u) = \lim_n (u + 1/n) = u P ( F ( X ) ≤ u ) = lim n ( u + 1/ n ) = u F ( X ) F(X) F ( X ) [ 0 , 1 ] [0,1] [ 0 , 1 ] u ≥ 1 u \ge 1 u ≥ 1 P ( F ( X ) ≤ u ) = 1 \mathbb{P}(F(X) \le u) = 1 P ( F ( X ) ≤ u ) = 1 u < 0 u < 0 u < 0 0 0 0 u = 0 u = 0 u = 0 P ( F ( X ) ≤ 0 ) ≤ P ( F ( X ) < ε ) = ε \mathbb{P}(F(X) \le 0) \le \mathbb{P}(F(X) < \varepsilon) = \varepsilon P ( F ( X ) ≤ 0 ) ≤ P ( F ( X ) < ε ) = ε ε ∈ ( 0 , 1 ) \varepsilon \in (0,1) ε ∈ ( 0 , 1 ) 0 0 0 U ( 0 , 1 ) \mathrm{U}(0,1) U ( 0 , 1 ) 命題 3.6[確率変数と期待値] )、F ( X ) ∼ U ( 0 , 1 ) F(X) \sim \mathrm{U}(0,1) F ( X ) ∼ U ( 0 , 1 )
∎ 1 は、任意の 分布関数に対して、その分布をもつ確率変数が一様乱数 1 個から作れることを述べています。2 は逆向きの道具で、標本が指定した連続分布に従うかどうかの検定(F ( X i ) F(X_i) F ( X i ) X X X 1 / 2 1/2 1/2 0 , 1 0, 1 0 , 1 F ( X ) F(X) F ( X ) 1 / 2 1/2 1/2 1 1 1
例 3.4 (指数分布・Cauchy 分布・離散分布 )
指数分布。 F ( x ) = 1 − e − λ x F(x) = 1 - e^{-\lambda x} F ( x ) = 1 − e − λ x x ≥ 0 x \ge 0 x ≥ 0 [ 0 , ∞ ) [0, \infty) [ 0 , ∞ ) F − ( u ) = − ln ( 1 − u ) / λ F^{-}(u) = -\ln(1 - u)/\lambda F − ( u ) = − ln ( 1 − u ) / λ X = − ln ( 1 − U ) / λ X = -\ln(1 - U)/\lambda X = − ln ( 1 − U ) / λ λ \lambda λ
Cauchy 分布。 密度 1 / ( π ( 1 + x 2 ) ) 1/(\pi(1 + x^2)) 1/ ( π ( 1 + x 2 )) F ( x ) = 1 2 + 1 π arctan x F(x) = \frac12 + \frac1\pi\arctan x F ( x ) = 2 1 + π 1 arctan x F − ( u ) = tan ( π ( u − 1 2 ) ) F^{-}(u) = \tan(\pi(u - \frac12)) F − ( u ) = tan ( π ( u − 2 1 ))
離散分布。 値 x 1 < x 2 < ⋯ < x n x_1 < x_2 < \cdots < x_n x 1 < x 2 < ⋯ < x n p 1 , … , p n p_1, \ldots, p_n p 1 , … , p n P k = p 1 + ⋯ + p k P_k = p_1 + \cdots + p_k P k = p 1 + ⋯ + p k P 0 = 0 P_0 = 0 P 0 = 0 F F F x k x_k x k P k − 1 P_{k-1} P k − 1 P k P_k P k P k − 1 < u ≤ P k P_{k-1} < u \le P_k P k − 1 < u ≤ P k F ( x ) ≥ u F(x) \ge u F ( x ) ≥ u x x x x k x_k x k F − ( u ) = x k F^{-}(u) = x_k F − ( u ) = x k U U U ( P k − 1 , P k ] (P_{k-1}, P_k] ( P k − 1 , P k ] k k k x k x_k x k P k P_k P k O ( log n ) O(\log n) O ( log n ) O ( 1 ) O(1) O ( 1 )
一様乱数が 2 − 53 2^{-53} 2 − 53
証明(命題 3.5) 1. U = k 2 − 53 U = k\,2^{-53} U = k 2 − 53 0 ≤ k ≤ 2 53 − 1 0 \le k \le 2^{53} - 1 0 ≤ k ≤ 2 53 − 1 1 − U = ( 2 53 − k ) 2 − 53 1 - U = (2^{53} - k)\,2^{-53} 1 − U = ( 2 53 − k ) 2 − 53 2 53 − k 2^{53} - k 2 53 − k 1 1 1 2 53 2^{53} 2 53 2 − 53 ≤ 1 − U ≤ 1 2^{-53} \le 1 - U \le 1 2 − 53 ≤ 1 − U ≤ 1 − ln -\ln − ln 0 ≤ − ln ( 1 − U ) ≤ − ln 2 − 53 = 53 ln 2 0 \le -\ln(1 - U) \le -\ln 2^{-53} = 53\ln 2 0 ≤ − ln ( 1 − U ) ≤ − ln 2 − 53 = 53 ln 2 k = 2 53 − 1 k = 2^{53} - 1 k = 2 53 − 1
2. U ≠ 0 U \ne 0 U = 0 2 − 53 ≤ U ≤ 1 − 2 − 53 2^{-53} \le U \le 1 - 2^{-53} 2 − 53 ≤ U ≤ 1 − 2 − 53 Φ − 1 \Phi^{-1} Φ − 1 Φ − 1 ( 2 − 53 ) ≤ X ≤ Φ − 1 ( 1 − 2 − 53 ) \Phi^{-1}(2^{-53}) \le X \le \Phi^{-1}(1 - 2^{-53}) Φ − 1 ( 2 − 53 ) ≤ X ≤ Φ − 1 ( 1 − 2 − 53 ) Φ ( − z ) = 1 − Φ ( z ) \Phi(-z) = 1 - \Phi(z) Φ ( − z ) = 1 − Φ ( z ) − z ∗ -z^* − z ∗ z ∗ z^* z ∗ z ∗ z^* z ∗ Φ ( − z ) = 2 − 53 \Phi(-z) = 2^{-53} Φ ( − z ) = 2 − 53
3. 率 1 1 1 P ( X > 53 ln 2 ) = e − 53 ln 2 = 2 − 53 \mathbb{P}(X > 53\ln2) = e^{-53\ln2} = 2^{-53} P ( X > 53 ln 2 ) = e − 53 l n 2 = 2 − 53 P ( ∣ X ∣ > z ∗ ) = 2 Φ ( − z ∗ ) = 2 − 52 \mathbb{P}(|X| > z^*) = 2\Phi(-z^*) = 2^{-52} P ( ∣ X ∣ > z ∗ ) = 2Φ ( − z ∗ ) = 2 − 52
∎ この命題から 2 つの実務上の規則が出ます。第一に、対数の引数には U U U 1 − U 1 - U 1 − U -np.log1p(-u))。1 − U 1 - U 1 − U 2 − 53 2^{-53} 2 − 53 2 − 53 2^{-53} 2 − 53 2 53 2^{53} 2 53 10 − 16 10^{-16} 1 0 − 16 重点サンプリング で裾に標本を集めます。
分布関数の逆関数が簡単に計算できない分布では、「作りやすい分布から候補を出し、ある確率で捨てる」方法を使います。
定義 4.1 (棄却法 ) ↗
f : R d → [ 0 , ∞ ) f : \mathbb{R}^d \to [0, \infty) f : R d → [ 0 , ∞ ) 0 < ∫ f < ∞ 0 < \int f < \infty 0 < ∫ f < ∞ 目標 。正規化されていなくてよい)、g g g R d \mathbb{R}^d R d 提案密度 )、M > 0 M > 0 M > 0 包絡定数 )とする。R d + 1 \mathbb{R}^{d+1} R d + 1 ( Y i , U i ) (Y_i, U_i) ( Y i , U i ) i = 1 , 2 , … i = 1, 2, \ldots i = 1 , 2 , … g ( y ) 1 ( 0 , 1 ) ( u ) g(y)\mathbf{1}_{(0,1)}(u) g ( y ) 1 ( 0 , 1 ) ( u ) Y i Y_i Y i g g g U i ∼ U ( 0 , 1 ) U_i \sim \mathrm{U}(0,1) U i ∼ U ( 0 , 1 ) Y i Y_i Y i
A i = { U i M g ( Y i ) ≤ f ( Y i ) } A_i = \{U_i\,M g(Y_i) \le f(Y_i)\} A i = { U i M g ( Y i ) ≤ f ( Y i )} が起きたとき i i i 採択 するという。最初に採択が起きる回 τ = min { i : A i が起きる } \tau = \min\{i : A_i \text{ が起きる}\} τ = min { i : A i が起きる } X = Y τ X = Y_\tau X = Y τ 棄却法 という。P ( A 1 ) \mathbb{P}(A_1) P ( A 1 ) 採択率 という。
g ( Y i ) > 0 g(Y_i) > 0 g ( Y i ) > 0 U i ≤ f ( Y i ) / ( M g ( Y i ) ) U_i \le f(Y_i)/(Mg(Y_i)) U i ≤ f ( Y i ) / ( M g ( Y i )) g = 0 g = 0 g = 0
定理 4.2 (棄却法の正しさ ) ✓
定義 4.1 の設定で、h = min ( f , M g ) h = \min(f, Mg) h = min ( f , M g ) ∫ h > 0 \int h > 0 ∫ h > 0
採択率は p = 1 M ∫ h p = \frac1M\int h p = M 1 ∫ h τ \tau τ p p p P ( τ < ∞ ) = 1 \mathbb{P}(\tau < \infty) = 1 P ( τ < ∞ ) = 1 E [ τ ] = 1 / p \mathbb{E}[\tau] = 1/p E [ τ ] = 1/ p
出力 X = Y τ X = Y_\tau X = Y τ h / ∫ h h/\int h h / ∫ h τ \tau τ
包絡条件 f ( y ) ≤ M g ( y ) f(y) \le Mg(y) f ( y ) ≤ M g ( y ) y y y X X X f / ∫ f f/\int f f / ∫ f ∫ f / M \int f/M ∫ f / M f f f 1 / M 1/M 1/ M M M M 包絡条件が破れていて、E = { f > M g } E = \{f > Mg\} E = { f > M g } E c ∩ { f > 0 } E^c \cap \{f > 0\} E c ∩ { f > 0 } X X X h / ∫ h h/\int h h / ∫ h f / ∫ f f/\int f f / ∫ f
定理の 1〜3 は、「候補が採択される確率」を候補の位置ごとに計算するだけです。位置 y y y min ( 1 , f / ( M g ) ) \min(1, f/(Mg)) min ( 1 , f / ( M g )) g g g h / M h/M h / M f f f h h h f f f
証明(定理 4.2) 1 回の試行。 ボレル集合 B ⊆ R d B \subseteq \mathbb{R}^d B ⊆ R d P ( Y 1 ∈ B , A 1 ) \mathbb{P}(Y_1 \in B,\ A_1) P ( Y 1 ∈ B , A 1 ) ( Y 1 , U 1 ) (Y_1, U_1) ( Y 1 , U 1 ) 定理 3.3[直積測度と Fubini–Tonelli の定理] )から
P ( Y 1 ∈ B , A 1 ) = ∫ B g ( y ) ( ∫ 0 1 1 { u M g ( y ) ≤ f ( y ) } d u ) d y \mathbb{P}(Y_1 \in B,\ A_1) = \int_B g(y)\Bigl(\int_0^1 \mathbf{1}\{u\,Mg(y) \le f(y)\}\,du\Bigr)dy P ( Y 1 ∈ B , A 1 ) = ∫ B g ( y ) ( ∫ 0 1 1 { u M g ( y ) ≤ f ( y )} d u ) d y です。内側の積分は、g ( y ) > 0 g(y) > 0 g ( y ) > 0 min ( 1 , f ( y ) / ( M g ( y ) ) ) \min(1, f(y)/(Mg(y))) min ( 1 , f ( y ) / ( M g ( y ))) g ( y ) = 0 g(y) = 0 g ( y ) = 0 f ≥ 0 f \ge 0 f ≥ 0 1 1 1 g ( y ) g(y) g ( y ) min ( g ( y ) , f ( y ) / M ) = h ( y ) / M \min(g(y), f(y)/M) = h(y)/M min ( g ( y ) , f ( y ) / M ) = h ( y ) / M g ( y ) = 0 g(y) = 0 g ( y ) = 0 0 0 0
P ( Y 1 ∈ B , A 1 ) = 1 M ∫ B h ( y ) d y . \mathbb{P}(Y_1 \in B,\ A_1) = \frac1M\int_B h(y)\,dy. P ( Y 1 ∈ B , A 1 ) = M 1 ∫ B h ( y ) d y . B = R d B = \mathbb{R}^d B = R d p = P ( A 1 ) = 1 M ∫ h > 0 p = \mathbb{P}(A_1) = \frac1M\int h > 0 p = P ( A 1 ) = M 1 ∫ h > 0
1 と 2。 対 ( Y i , U i ) (Y_i, U_i) ( Y i , U i ) A 1 c , … , A k − 1 c , { Y k ∈ B } ∩ A k A_1^c, \ldots, A_{k-1}^c, \{Y_k \in B\} \cap A_k A 1 c , … , A k − 1 c , { Y k ∈ B } ∩ A k
P ( τ = k , X ∈ B ) = P ( A 1 c ) ⋯ P ( A k − 1 c ) P ( Y k ∈ B , A k ) = ( 1 − p ) k − 1 ⋅ 1 M ∫ B h \mathbb{P}(\tau = k,\ X \in B) = \mathbb{P}(A_1^c)\cdots\mathbb{P}(A_{k-1}^c)\,\mathbb{P}(Y_k \in B,\ A_k) = (1-p)^{k-1}\cdot\frac1M\int_B h P ( τ = k , X ∈ B ) = P ( A 1 c ) ⋯ P ( A k − 1 c ) P ( Y k ∈ B , A k ) = ( 1 − p ) k − 1 ⋅ M 1 ∫ B h です。B = R d B = \mathbb{R}^d B = R d P ( τ = k ) = ( 1 − p ) k − 1 p \mathbb{P}(\tau = k) = (1-p)^{k-1}p P ( τ = k ) = ( 1 − p ) k − 1 p 定義 3.4[確率分布と統計的な推測] )。和が 1 1 1 1 / p 1/p 1/ p p < 1 p < 1 p < 1 定理 3.5[確率分布と統計的な推測] です(p = 1 p = 1 p = 1 1 1 1 τ = 1 \tau = 1 τ = 1 k k k ∑ k ≥ 1 ( 1 − p ) k − 1 = 1 / p \sum_{k\ge1}(1-p)^{k-1} = 1/p ∑ k ≥ 1 ( 1 − p ) k − 1 = 1/ p
P ( X ∈ B ) = 1 p M ∫ B h = ∫ B h ∫ h \mathbb{P}(X \in B) = \frac{1}{pM}\int_B h = \frac{\int_B h}{\int h} P ( X ∈ B ) = pM 1 ∫ B h = ∫ h ∫ B h で、X X X h / ∫ h h/\int h h / ∫ h P ( τ = k , X ∈ B ) = P ( τ = k ) P ( X ∈ B ) \mathbb{P}(\tau = k,\ X \in B) = \mathbb{P}(\tau = k)\,\mathbb{P}(X \in B) P ( τ = k , X ∈ B ) = P ( τ = k ) P ( X ∈ B ) τ \tau τ X X X
3. 包絡条件のもとでは h = f h = f h = f
4. 2 つの密度が一致する、すなわちほとんどすべての y y y h ( y ) / ∫ h = f ( y ) / ∫ f h(y)/\int h = f(y)/\int f h ( y ) / ∫ h = f ( y ) / ∫ f E c E^c E c h = f h = f h = f E c ∩ { f > 0 } E^c \cap \{f > 0\} E c ∩ { f > 0 } 1 / ∫ h = 1 / ∫ f 1/\int h = 1/\int f 1/ ∫ h = 1/ ∫ f ∫ h = ∫ f \int h = \int f ∫ h = ∫ f h ≤ f h \le f h ≤ f f − h ≥ 0 f - h \ge 0 f − h ≥ 0 0 0 0 h = f h = f h = f E E E h = M g < f h = Mg < f h = M g < f m ( E ) > 0 m(E) > 0 m ( E ) > 0
∎ 3 が棄却法の主張です。f f f ∫ f \int f ∫ f 事後分布 や統計力学の Boltzmann 分布のように、密度が定数倍を除いてしか分からない場合に使えるのはこのためです。採択率 ∫ f / M \int f/M ∫ f / M M M M M M M g g g f f f
4 は、包絡条件の確認を怠ったときに何が起きるかを述べています。f > M g f > Mg f > M g 1 1 1 sup f / g \sup f/g sup f / g f ( Y i ) > M g ( Y i ) f(Y_i) > Mg(Y_i) f ( Y i ) > M g ( Y i ) f f f M g Mg M g min ( f , M g ) \min(f, Mg) min ( f , M g ) f f f
例 4.3 (半正規分布を指数分布で包む )
目標を半正規分布の密度 f ( x ) = 2 / π e − x 2 / 2 f(x) = \sqrt{2/\pi}\,e^{-x^2/2} f ( x ) = 2/ π e − x 2 /2 x ≥ 0 x \ge 0 x ≥ 0 1 1 1 g ( x ) = e − x g(x) = e^{-x} g ( x ) = e − x x ≥ 0 x \ge 0 x ≥ 0
f ( x ) g ( x ) = 2 π e x − x 2 / 2 = 2 π e 1 / 2 e − ( x − 1 ) 2 / 2 \frac{f(x)}{g(x)} = \sqrt{\frac2\pi}\,e^{x - x^2/2} = \sqrt{\frac2\pi}\,e^{1/2}\,e^{-(x-1)^2/2} g ( x ) f ( x ) = π 2 e x − x 2 /2 = π 2 e 1/2 e − ( x − 1 ) 2 /2 で、x = 1 x = 1 x = 1 M = 2 e / π ≈ 1.3155 M = \sqrt{2e/\pi} \approx 1.3155 M = 2 e / π ≈ 1.3155 M M M U ≤ f ( Y ) / ( M g ( Y ) ) = e − ( Y − 1 ) 2 / 2 U \le f(Y)/(Mg(Y)) = e^{-(Y-1)^2/2} U ≤ f ( Y ) / ( M g ( Y )) = e − ( Y − 1 ) 2 /2 1 / M = π / ( 2 e ) ≈ 0.7602 1/M = \sqrt{\pi/(2e)} \approx 0.7602 1/ M = π / ( 2 e ) ≈ 0.7602 X X X 1 / 2 1/2 1/2
逆に、提案の裾が目標より軽いと包絡定数が存在しません。目標を率 1 1 1 f / g = π / 2 e x 2 / 2 − x → ∞ f/g = \sqrt{\pi/2}\,e^{x^2/2 - x} \to \infty f / g = π /2 e x 2 /2 − x → ∞ M M M
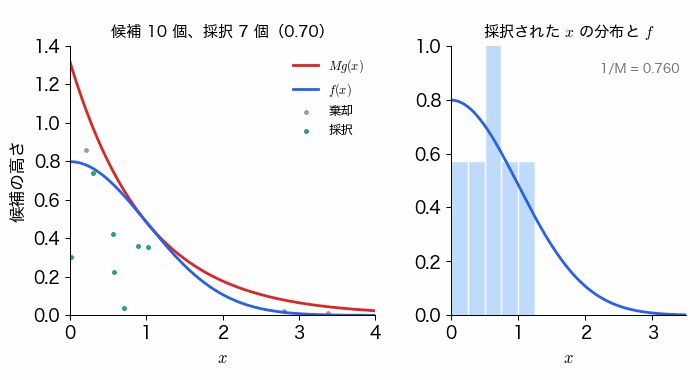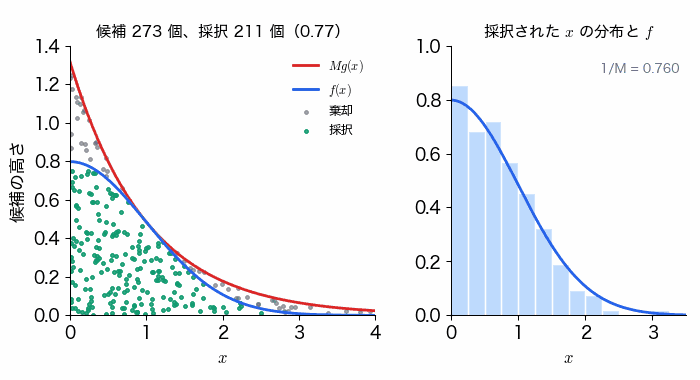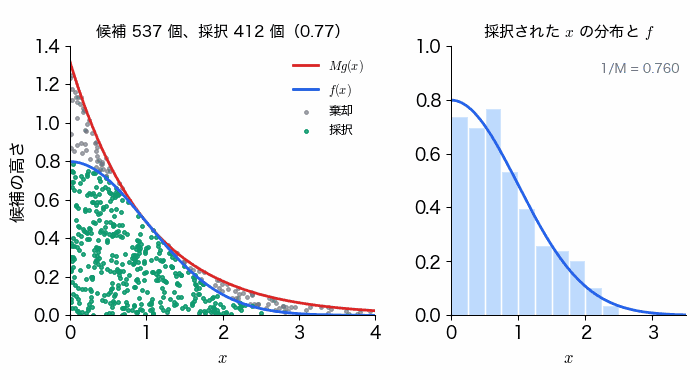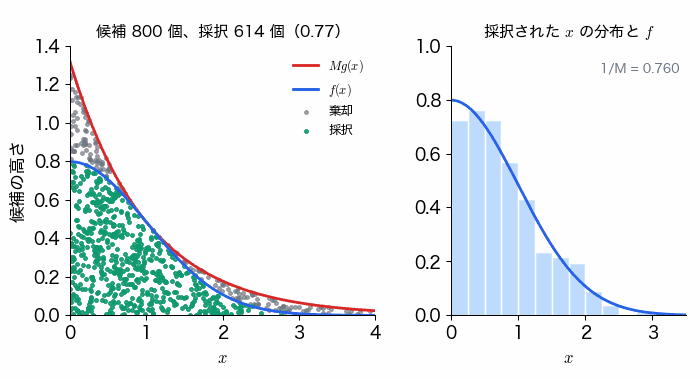
上の半正規分布の例を動かしたのが次の図です。候補 Y Y Y U M g ( Y ) U\,Mg(Y) U M g ( Y ) f f f x x x f f f 1 / M ≈ 0.76 1/M \approx 0.76 1/ M ≈ 0.76
半正規分布を指数分布で包む棄却法。左は候補の点(緑が採択、灰色が棄却)、右は採択された x のヒストグラムと目標の密度 f。 次のコードは、逆関数法と棄却法で作った標本について、経験分布関数 F N F_N F N F F F D N = sup x ∣ F N ( x ) − F ( x ) ∣ D_N = \sup_x|F_N(x) - F(x)| D N = sup x ∣ F N ( x ) − F ( x ) ∣ F F F D N D_N D N 1 / N 1/\sqrt N 1/ N 注意 4.4 )。
# Python 3.9.6, NumPy 2.0.2, SciPy 1.13.1
from scipy.special import erf
rng = np.random. default_rng ( 20261008 )
def ks ( x , F ) : # sup |F_N - F| を整列した標本から厳密に
return max ( np. max ( i / n - Fx ) , np. max ( Fx - (i - 1 ) / n ))
x_exp = - np. log1p ( - u ) # 指数分布: F^-(u) = -ln(1-u)
x_cau = np. tan ( np.pi * (rng. random ( N ) - 0.5 ) ) # Cauchy 分布
M = np. sqrt ( 2 * np.e / np.pi ) # 半正規分布を Exp(1) で包む
y = - np. log1p ( - rng. random ( 2 * N ))
acc = rng. random ( 2 * N ) <= np. exp ( - 0.5 * (y - 1.0 ) ** 2 )
print ( f "1/sqrt(N) = { 1 / np. sqrt ( N ) :.5f } " )
print ( f "指数分布(逆関数法) D_N = { ks ( x_exp , lambda t : 1 - np. exp ( - t )) :.5f } " )
print ( f "Cauchy 分布(逆関数法) D_N = { ks ( x_cau , lambda t : 0.5 + np. arctan ( t ) / np.pi ) :.5f } " )
print ( f "半正規分布(棄却法) D_N = { ks ( x_hn , lambda t : erf ( t / np. sqrt ( 2 ))) :.5f } (N = { len ( x_hn ) } )" )
se = np. sqrt ( p_hat * ( 1 - p_hat) / len ( acc ))
print ( f "採択率 = {p_hat :.5f } ± {se :.5f } , 1/M = { 1 / M :.5f } , 差 = {(p_hat - 1 / M) / se :+.2f } 標準誤差" )
Cauchy 分布(逆関数法) D_N = 0.00369
半正規分布(棄却法) D_N = 0.00199 (N = 100000)
採択率 = 0.76141 ± 0.00095, 1/M = 0.76017, 差 = +1.30 標準誤差
3 つの標本とも D N D_N D N 1 / N ≈ 0.0032 1/\sqrt N \approx 0.0032 1/ N ≈ 0.0032 1 / M 1/M 1/ M
混合分布からの生成が正しいことは、K K K K K K ( X 1 , … , X n ) (X_1, \ldots, X_n) ( X 1 , … , X n ) P ( X K ∈ B ) = ∑ k P ( K = k ) P ( X k ∈ B ) = ∑ k w k ∫ B p k = ∫ B ∑ k w k p k \mathbb{P}(X_K \in B) = \sum_k \mathbb{P}(K = k)\,\mathbb{P}(X_k \in B) = \sum_k w_k\int_B p_k = \int_B \sum_k w_kp_k P ( X K ∈ B ) = ∑ k P ( K = k ) P ( X k ∈ B ) = ∑ k w k ∫ B p k = ∫ B ∑ k w k p k X K X_K X K
標準正規分布 N ( 0 , 1 ) N(0,1) N ( 0 , 1 ) φ ( t ) = ( 2 π ) − 1 / 2 e − t 2 / 2 \varphi(t) = (2\pi)^{-1/2}e^{-t^2/2} φ ( t ) = ( 2 π ) − 1/2 e − t 2 /2 定理 3.3[広義積分・パラメータ積分とガンマ関数] )で x = t / 2 x = t/\sqrt2 x = t / 2 ∫ − ∞ ∞ e − t 2 / 2 d t = 2 π \int_{-\infty}^{\infty}e^{-t^2/2}dt = \sqrt{2\pi} ∫ − ∞ ∞ e − t 2 /2 d t = 2 π ∫ φ = 1 \int\varphi = 1 ∫ φ = 1
命題 5.2 (Box–Muller 法と極座標法 ) ✓
U 1 , U 2 U_1, U_2 U 1 , U 2 U ( 0 , 1 ) \mathrm{U}(0,1) U ( 0 , 1 ) X = − 2 ln U 1 cos ( 2 π U 2 ) , Y = − 2 ln U 1 sin ( 2 π U 2 ) X = \sqrt{-2\ln U_1}\,\cos(2\pi U_2), \qquad Y = \sqrt{-2\ln U_1}\,\sin(2\pi U_2) X = − 2 ln U 1 cos ( 2 π U 2 ) , Y = − 2 ln U 1 sin ( 2 π U 2 ) ( V 1 , V 2 ) (V_1, V_2) ( V 1 , V 2 ) D = { 0 < v 1 2 + v 2 2 < 1 } D = \{0 < v_1^2 + v_2^2 < 1\} D = { 0 < v 1 2 + v 2 2 < 1 } S = V 1 2 + V 2 2 S = V_1^2 + V_2^2 S = V 1 2 + V 2 2 X = V 1 − 2 ln S S , Y = V 2 − 2 ln S S X = V_1\sqrt{\frac{-2\ln S}{S}}, \qquad Y = V_2\sqrt{\frac{-2\ln S}{S}} X = V 1 S − 2 ln S , Y = V 2 S − 2 ln S ( V 1 , V 2 ) (V_1, V_2) ( V 1 , V 2 ) ( − 1 , 1 ) 2 (-1,1)^2 ( − 1 , 1 ) 2 π / 4 \pi/4 π /4 1 の証明の方針です。( U 1 , U 2 ) (U_1, U_2) ( U 1 , U 2 ) r = − 2 ln U 1 r = \sqrt{-2\ln U_1} r = − 2 ln U 1 2 π U 2 2\pi U_2 2 π U 2 1 2 π e − ( x 2 + y 2 ) / 2 \frac{1}{2\pi}e^{-(x^2+y^2)/2} 2 π 1 e − ( x 2 + y 2 ) /2
証明(命題 5.2) 1. Q = ( 0 , 1 ) 2 Q = (0,1)^2 Q = ( 0 , 1 ) 2 補題 2.2 から ( U 1 , U 2 ) (U_1, U_2) ( U 1 , U 2 ) Q Q Q Φ : Q → R 2 \Phi : Q \to \mathbb{R}^2 Φ : Q → R 2
Φ ( u 1 , u 2 ) = ( r cos θ , r sin θ ) , r = − 2 ln u 1 > 0 , θ = 2 π u 2 ∈ ( 0 , 2 π ) \Phi(u_1, u_2) = (r\cos\theta,\ r\sin\theta), \qquad r = \sqrt{-2\ln u_1} > 0,\quad \theta = 2\pi u_2 \in (0, 2\pi) Φ ( u 1 , u 2 ) = ( r cos θ , r sin θ ) , r = − 2 ln u 1 > 0 , θ = 2 π u 2 ∈ ( 0 , 2 π ) で定めます。Φ \Phi Φ C 1 C^1 C 1 r r r u 1 = e − r 2 / 2 u_1 = e^{-r^2/2} u 1 = e − r 2 /2 ( cos θ , sin θ ) (\cos\theta, \sin\theta) ( cos θ , sin θ ) θ ∈ ( 0 , 2 π ) \theta \in (0, 2\pi) θ ∈ ( 0 , 2 π ) u 2 u_2 u 2 V = R 2 ∖ { ( x , 0 ) : x ≥ 0 } V = \mathbb{R}^2 \setminus \{(x, 0) : x \ge 0\} V = R 2 ∖ {( x , 0 ) : x ≥ 0 } r ′ = d r / d u 1 r' = dr/du_1 r ′ = d r / d u 1
det D Φ = ∣ r ′ cos θ − 2 π r sin θ r ′ sin θ 2 π r cos θ ∣ = 2 π r r ′ \det D\Phi = \begin{vmatrix} r'\cos\theta & -2\pi r\sin\theta \\ r'\sin\theta & 2\pi r\cos\theta \end{vmatrix} = 2\pi rr' det D Φ = r ′ cos θ r ′ sin θ − 2 π r sin θ 2 π r cos θ = 2 π r r ′ で、r r ′ = d d u 1 ( 1 2 r 2 ) = d d u 1 ( − ln u 1 ) = − 1 / u 1 rr' = \frac{d}{du_1}\bigl(\tfrac12r^2\bigr) = \frac{d}{du_1}(-\ln u_1) = -1/u_1 r r ′ = d u 1 d ( 2 1 r 2 ) = d u 1 d ( − ln u 1 ) = − 1/ u 1 ∣ det D Φ ( u ) ∣ = 2 π / u 1 ≠ 0 |\det D\Phi(u)| = 2\pi/u_1 \ne 0 ∣ det D Φ ( u ) ∣ = 2 π / u 1 = 0 C 1 C^1 C 1 補題 4.2[ℝ^d の変数変換公式と極座標] )、変数変換公式(定理 4.5[ℝ^d の変数変換公式と極座標] の 2)が使えます。ボレル集合 B ⊆ R 2 B \subseteq \mathbb{R}^2 B ⊆ R 2 V V V ψ ( z ) = 1 B ( z ) 1 2 π e − ∣ z ∣ 2 / 2 \psi(z) = \mathbf{1}_B(z)\,\frac{1}{2\pi}e^{-|z|^2/2} ψ ( z ) = 1 B ( z ) 2 π 1 e − ∣ z ∣ 2 /2 ψ ( Φ ( u ) ) = 1 B ( Φ ( u ) ) u 1 2 π \psi(\Phi(u)) = \mathbf{1}_B(\Phi(u))\,\frac{u_1}{2\pi} ψ ( Φ ( u )) = 1 B ( Φ ( u )) 2 π u 1
∫ V ψ ( z ) d z = ∫ Q 1 B ( Φ ( u ) ) u 1 2 π ⋅ 2 π u 1 d u = ∫ Q 1 B ( Φ ( u ) ) d u = P ( ( X , Y ) ∈ B ) \int_V \psi(z)\,dz = \int_Q \mathbf{1}_B(\Phi(u))\,\frac{u_1}{2\pi}\cdot\frac{2\pi}{u_1}\,du = \int_Q \mathbf{1}_B(\Phi(u))\,du = \mathbb{P}\bigl((X, Y) \in B\bigr) ∫ V ψ ( z ) d z = ∫ Q 1 B ( Φ ( u )) 2 π u 1 ⋅ u 1 2 π d u = ∫ Q 1 B ( Φ ( u )) d u = P ( ( X , Y ) ∈ B ) です。R 2 ∖ V \mathbb{R}^2 \setminus V R 2 ∖ V 0 0 0 ∫ B φ ( x ) φ ( y ) d x d y \int_B \varphi(x)\varphi(y)\,dx\,dy ∫ B φ ( x ) φ ( y ) d x d y ( X , Y ) (X, Y) ( X , Y ) φ ( x ) φ ( y ) \varphi(x)\varphi(y) φ ( x ) φ ( y )
B = B 1 × B 2 B = B_1 \times B_2 B = B 1 × B 2 P ( X ∈ B 1 , Y ∈ B 2 ) = ∫ B 1 φ ∫ B 2 φ \mathbb{P}(X \in B_1, Y \in B_2) = \int_{B_1}\varphi\int_{B_2}\varphi P ( X ∈ B 1 , Y ∈ B 2 ) = ∫ B 1 φ ∫ B 2 φ B 2 = R B_2 = \mathbb{R} B 2 = R P ( X ∈ B 1 ) = ∫ B 1 φ \mathbb{P}(X \in B_1) = \int_{B_1}\varphi P ( X ∈ B 1 ) = ∫ B 1 φ P ( Y ∈ B 2 ) = ∫ B 2 φ \mathbb{P}(Y \in B_2) = \int_{B_2}\varphi P ( Y ∈ B 2 ) = ∫ B 2 φ X , Y X, Y X , Y P ( X ∈ B 1 , Y ∈ B 2 ) = P ( X ∈ B 1 ) P ( Y ∈ B 2 ) \mathbb{P}(X \in B_1, Y \in B_2) = \mathbb{P}(X \in B_1)\mathbb{P}(Y \in B_2) P ( X ∈ B 1 , Y ∈ B 2 ) = P ( X ∈ B 1 ) P ( Y ∈ B 2 )
2. 写像 Ψ : Q → R 2 \Psi : Q \to \mathbb{R}^2 Ψ : Q → R 2 Ψ ( s , t ) = s ( cos 2 π t , sin 2 π t ) \Psi(s, t) = \sqrt s\,(\cos2\pi t, \sin2\pi t) Ψ ( s , t ) = s ( cos 2 π t , sin 2 π t ) D ′ = D ∖ { ( x , 0 ) : x > 0 } D' = D \setminus \{(x, 0) : x > 0\} D ′ = D ∖ {( x , 0 ) : x > 0 }
det D Ψ = ∣ 1 2 s cos 2 π t − 2 π s sin 2 π t 1 2 s sin 2 π t 2 π s cos 2 π t ∣ = π \det D\Psi = \begin{vmatrix} \frac{1}{2\sqrt s}\cos2\pi t & -2\pi\sqrt s\sin2\pi t \\ \frac{1}{2\sqrt s}\sin2\pi t & 2\pi\sqrt s\cos2\pi t \end{vmatrix} = \pi det D Ψ = 2 s 1 cos 2 π t 2 s 1 sin 2 π t − 2 π s sin 2 π t 2 π s cos 2 π t = π です。よって Ψ : Q → D ′ \Psi : Q \to D' Ψ : Q → D ′ C ⊆ Q C \subseteq Q C ⊆ Q m ( Ψ ( C ) ) = π m ( C ) m(\Psi(C)) = \pi\,m(C) m ( Ψ ( C )) = π m ( C ) 定理 4.5[ℝ^d の変数変換公式と極座標] の 1)。( V 1 , V 2 ) (V_1, V_2) ( V 1 , V 2 ) 1 1 1 D ′ D' D ′ ( S , T ) = Ψ − 1 ( V 1 , V 2 ) (S, T) = \Psi^{-1}(V_1, V_2) ( S , T ) = Ψ − 1 ( V 1 , V 2 ) 1 1 1
P ( ( S , T ) ∈ C ) = P ( ( V 1 , V 2 ) ∈ Ψ ( C ) ) = m ( Ψ ( C ) ) π = m ( C ) \mathbb{P}\bigl((S, T) \in C\bigr) = \mathbb{P}\bigl((V_1, V_2) \in \Psi(C)\bigr) = \frac{m(\Psi(C))}{\pi} = m(C) P ( ( S , T ) ∈ C ) = P ( ( V 1 , V 2 ) ∈ Ψ ( C ) ) = π m ( Ψ ( C )) = m ( C ) です。つまり ( S , T ) (S, T) ( S , T ) Q Q Q S , T S, T S , T U ( 0 , 1 ) \mathrm{U}(0,1) U ( 0 , 1 ) Ψ \Psi Ψ S = V 1 2 + V 2 2 S = V_1^2 + V_2^2 S = V 1 2 + V 2 2 V 1 / S = cos 2 π T V_1/\sqrt S = \cos2\pi T V 1 / S = cos 2 π T V 2 / S = sin 2 π T V_2/\sqrt S = \sin2\pi T V 2 / S = sin 2 π T
X = − 2 ln S cos ( 2 π T ) , Y = − 2 ln S sin ( 2 π T ) X = \sqrt{-2\ln S}\,\cos(2\pi T), \qquad Y = \sqrt{-2\ln S}\,\sin(2\pi T) X = − 2 ln S cos ( 2 π T ) , Y = − 2 ln S sin ( 2 π T ) となり、1 から結論が従います。
採択率は、定理 4.2 の 3 を f = 1 D f = \mathbf{1}_D f = 1 D g = 1 4 1 ( − 1 , 1 ) 2 g = \frac14\mathbf{1}_{(-1,1)^2} g = 4 1 1 ( − 1 , 1 ) 2 M = 4 M = 4 M = 4 ∫ f / M = π / 4 \int f/M = \pi/4 ∫ f / M = π /4 U ⋅ 4 g ( Y ) ≤ f ( Y ) U \cdot 4g(Y) \le f(Y) U ⋅ 4 g ( Y ) ≤ f ( Y ) Y ∈ D Y \in D Y ∈ D Y ∉ D Y \notin D Y ∈ / D
∎ 極座標法(Marsaglia)は三角関数を使わない代わりに、候補の 1 − π / 4 ≈ 21 % 1 - \pi/4 \approx 21\% 1 − π /4 ≈ 21% U 1 U_1 U 1 S S S ln 0 \ln 0 ln 0 1 − U 1 - U 1 − U − 2 ln U 1 \sqrt{-2\ln U_1} − 2 ln U 1 2 ⋅ 53 ln 2 ≈ 8.57 \sqrt{2\cdot53\ln2} \approx 8.57 2 ⋅ 53 ln 2 ≈ 8.57 命題 3.5 と同じ計算)。
命題 5.3 (多次元正規分布からの生成 ) ✓
μ ∈ R d \mu \in \mathbb{R}^d μ ∈ R d Σ \Sigma Σ d d d
r ≥ 1 r \ge 1 r ≥ 1 L L L L L T = Σ LL^{\mathsf{T}} = \Sigma L L T = Σ d × r d \times r d × r Z = ( Z 1 , … , Z r ) Z = (Z_1, \ldots, Z_r) Z = ( Z 1 , … , Z r ) μ + L Z ∼ N ( μ , Σ ) \mu + LZ \sim N(\mu, \Sigma) μ + L Z ∼ N ( μ , Σ ) Σ \Sigma Σ L L L L L T = Σ LL^{\mathsf{T}} = \Sigma L L T = Σ Σ \Sigma Σ r ≥ 1 r \ge 1 r ≥ 1 λ 1 , … , λ r \lambda_1, \ldots, \lambda_r λ 1 , … , λ r p 1 , … , p r \boldsymbol{p}_1, \ldots, \boldsymbol{p}_r p 1 , … , p r d × r d \times r d × r L = ( λ 1 p 1 ⋯ λ r p r ) L = (\sqrt{\lambda_1}\boldsymbol{p}_1\ \cdots\ \sqrt{\lambda_r}\boldsymbol{p}_r) L = ( λ 1 p 1 ⋯ λ r p r ) L L T = Σ LL^{\mathsf{T}} = \Sigma L L T = Σ 証明(命題 5.3) 1. Z Z Z e − ∣ t ∣ 2 / 2 e^{-|t|^2/2} e − ∣ t ∣ 2 /2 補題 2.3[特性関数と Gauss ベクトル] )。これは N ( 0 , I r ) N(0, I_r) N ( 0 , I r ) 定理 5.2[特性関数と Gauss ベクトル] の 1)に等しいので、特性関数の一意性(定理 3.3[特性関数と Gauss ベクトル] の 1)から Z ∼ N ( 0 , I r ) Z \sim N(0, I_r) Z ∼ N ( 0 , I r ) μ + L Z ∼ N ( μ , L I r L T ) = N ( μ , Σ ) \mu + LZ \sim N(\mu, LI_rL^{\mathsf{T}}) = N(\mu, \Sigma) μ + L Z ∼ N ( μ , L I r L T ) = N ( μ , Σ )
2. 定理 2.1[Cholesky 分解と帯行列・疎行列の直接法] から、対角成分が正の上三角行列 R R R Σ = R T R \Sigma = R^{\mathsf{T}}R Σ = R T R L = R T L = R^{\mathsf{T}} L = R T
3. 系 4.3[スペクトル定理] から、正規直交基底をなす固有ベクトル p 1 , … , p d \boldsymbol{p}_1, \ldots, \boldsymbol{p}_d p 1 , … , p d λ i \lambda_i λ i Σ = ∑ i = 1 d λ i p i p i T \Sigma = \sum_{i=1}^d \lambda_i\boldsymbol{p}_i\boldsymbol{p}_i^{\mathsf{T}} Σ = ∑ i = 1 d λ i p i p i T λ i = ⟨ p i , Σ p i ⟩ ≥ 0 \lambda_i = \langle\boldsymbol{p}_i, \Sigma\boldsymbol{p}_i\rangle \ge 0 λ i = ⟨ p i , Σ p i ⟩ ≥ 0 r r r r r r λ 1 , … , λ r \lambda_1, \ldots, \lambda_r λ 1 , … , λ r L L T = ∑ i = 1 r λ i p i p i T = Σ LL^{\mathsf{T}} = \sum_{i=1}^r \lambda_i\boldsymbol{p}_i\boldsymbol{p}_i^{\mathsf{T}} = \Sigma L L T = ∑ i = 1 r λ i p i p i T = Σ λ i = 0 \lambda_i = 0 λ i = 0
∎ S d − 1 = { x ∈ R d : ∣ x ∣ = 1 } S^{d-1} = \{x \in \mathbb{R}^d : |x| = 1\} S d − 1 = { x ∈ R d : ∣ x ∣ = 1 } σ \sigma σ 定義 6.1[ℝ^d の変数変換公式と極座標] )を全測度で割った確率測度を、球面上の一様分布 といいます。σ \sigma σ 命題 6.4[ℝ^d の変数変換公式と極座標] )。
証明(命題 5.5) 1. 補題 2.2 から Z Z Z ( 2 π ) − d / 2 e − ∣ x ∣ 2 / 2 (2\pi)^{-d/2}e^{-|x|^2/2} ( 2 π ) − d /2 e − ∣ x ∣ 2 /2 P ( Z = 0 ) = 0 \mathbb{P}(Z = 0) = 0 P ( Z = 0 ) = 0 A ⊆ S d − 1 A \subseteq S^{d-1} A ⊆ S d − 1 f ( x ) = 1 A ( x / ∣ x ∣ ) ( 2 π ) − d / 2 e − ∣ x ∣ 2 / 2 f(x) = \mathbf{1}_A(x/|x|)\,(2\pi)^{-d/2}e^{-|x|^2/2} f ( x ) = 1 A ( x /∣ x ∣ ) ( 2 π ) − d /2 e − ∣ x ∣ 2 /2 x ≠ 0 x \ne 0 x = 0 f ( 0 ) = 0 f(0) = 0 f ( 0 ) = 0 r > 0 r > 0 r > 0 ω ∈ S d − 1 \omega \in S^{d-1} ω ∈ S d − 1 f ( r ω ) = 1 A ( ω ) ( 2 π ) − d / 2 e − r 2 / 2 f(r\omega) = \mathbf{1}_A(\omega)(2\pi)^{-d/2}e^{-r^2/2} f ( r ω ) = 1 A ( ω ) ( 2 π ) − d /2 e − r 2 /2 定理 6.3[ℝ^d の変数変換公式と極座標] )から
P ( Z ∣ Z ∣ ∈ A ) = ∫ R d f ( x ) d x = ∫ 0 ∞ ( ∫ S d − 1 1 A ( ω ) d σ ( ω ) ) e − r 2 / 2 ( 2 π ) d / 2 r d − 1 d r = σ ( A ) κ d \mathbb{P}\Bigl(\frac{Z}{|Z|} \in A\Bigr) = \int_{\mathbb{R}^d} f(x)\,dx = \int_0^\infty\Bigl(\int_{S^{d-1}}\mathbf{1}_A(\omega)\,d\sigma(\omega)\Bigr)\frac{e^{-r^2/2}}{(2\pi)^{d/2}}\,r^{d-1}\,dr = \sigma(A)\,\kappa_d P ( ∣ Z ∣ Z ∈ A ) = ∫ R d f ( x ) d x = ∫ 0 ∞ ( ∫ S d − 1 1 A ( ω ) d σ ( ω ) ) ( 2 π ) d /2 e − r 2 /2 r d − 1 d r = σ ( A ) κ d です。ここで κ d = ∫ 0 ∞ ( 2 π ) − d / 2 e − r 2 / 2 r d − 1 d r \kappa_d = \int_0^\infty (2\pi)^{-d/2}e^{-r^2/2}r^{d-1}dr κ d = ∫ 0 ∞ ( 2 π ) − d /2 e − r 2 /2 r d − 1 d r A A A A = S d − 1 A = S^{d-1} A = S d − 1 1 1 1 κ d = 1 / σ ( S d − 1 ) \kappa_d = 1/\sigma(S^{d-1}) κ d = 1/ σ ( S d − 1 ) P ( Z / ∣ Z ∣ ∈ A ) = σ ( A ) / σ ( S d − 1 ) \mathbb{P}(Z/|Z| \in A) = \sigma(A)/\sigma(S^{d-1}) P ( Z /∣ Z ∣ ∈ A ) = σ ( A ) / σ ( S d − 1 )
2. 定理 4.2 の 3 を f = 1 { ∣ x ∣ < 1 } f = \mathbf{1}_{\{|x| < 1\}} f = 1 { ∣ x ∣ < 1 } g = 2 − d 1 ( − 1 , 1 ) d g = 2^{-d}\mathbf{1}_{(-1,1)^d} g = 2 − d 1 ( − 1 , 1 ) d M = 2 d M = 2^d M = 2 d ∫ f / M = m ( { ∣ x ∣ < 1 } ) / 2 d \int f/M = m(\{|x| < 1\})/2^d ∫ f / M = m ({ ∣ x ∣ < 1 }) / 2 d 定理 6.8[ℝ^d の変数変換公式と極座標] )を代入して a d a_d a d Γ ( s + 1 ) = s Γ ( s ) \Gamma(s + 1) = s\Gamma(s) Γ ( s + 1 ) = s Γ ( s ) 定理 5.3[広義積分・パラメータ積分とガンマ関数] )から
a d + 2 a d = π 4 ⋅ Γ ( d / 2 + 1 ) Γ ( d / 2 + 2 ) = π 4 ( d / 2 + 1 ) = π 2 d + 4 \frac{a_{d+2}}{a_d} = \frac{\pi}{4}\cdot\frac{\Gamma(d/2 + 1)}{\Gamma(d/2 + 2)} = \frac{\pi}{4(d/2 + 1)} = \frac{\pi}{2d + 4} a d a d + 2 = 4 π ⋅ Γ ( d /2 + 2 ) Γ ( d /2 + 1 ) = 4 ( d /2 + 1 ) π = 2 d + 4 π です。d ≥ 1 d \ge 1 d ≥ 1 π / 6 < 1 \pi/6 < 1 π /6 < 1 a d ≤ max ( a 1 , a 2 ) ( π / 6 ) ⌊ ( d − 1 ) / 2 ⌋ → 0 a_d \le \max(a_1, a_2)\,(\pi/6)^{\lfloor (d-1)/2\rfloor} \to 0 a d ≤ max ( a 1 , a 2 ) ( π /6 ) ⌊( d − 1 ) /2 ⌋ → 0
∎ a 2 = 0.785 a_2 = 0.785 a 2 = 0.785 a 3 = 0.524 a_3 = 0.524 a 3 = 0.524 a 5 = 0.164 a_5 = 0.164 a 5 = 0.164 a 10 = 2.5 × 10 − 3 a_{10} = 2.5\times10^{-3} a 10 = 2.5 × 1 0 − 3 a 20 = 2.5 × 10 − 8 a_{20} = 2.5\times10^{-8} a 20 = 2.5 × 1 0 − 8 R = U 1 / d R = U^{1/d} R = U 1/ d P ( R ≤ r ) = r d \mathbb{P}(R \le r) = r^d P ( R ≤ r ) = r d R Z / ∣ Z ∣ R\,Z/|Z| R Z /∣ Z ∣
証明(命題 5.6) W = ( 0 , ∞ ) × R W = (0, \infty) \times \mathbb{R} W = ( 0 , ∞ ) × R Φ : W → W \Phi : W \to W Φ : W → W Φ ( u , x ) = ( u , u x ) \Phi(u, x) = (u, ux) Φ ( u , x ) = ( u , ux ) ( u , v ) ↦ ( u , v / u ) (u, v) \mapsto (u, v/u) ( u , v ) ↦ ( u , v / u ) C 1 C^1 C 1 det D Φ ( u , x ) = ∣ 1 0 x u ∣ = u > 0 \det D\Phi(u, x) = \begin{vmatrix} 1 & 0 \\ x & u\end{vmatrix} = u > 0 det D Φ ( u , x ) = 1 x 0 u = u > 0 A ⊆ W A \subseteq W A ⊆ W 1 A ( Φ ( u , x ) ) = 1 { u ≤ f ( x ) } \mathbf{1}_A(\Phi(u, x)) = \mathbf{1}\{u \le \sqrt{f(x)}\} 1 A ( Φ ( u , x )) = 1 { u ≤ f ( x ) } B ⊆ R B \subseteq \mathbb{R} B ⊆ R 定理 4.5[ℝ^d の変数変換公式と極座標] の 2)と Tonelli の定理から
∫ W 1 A ( u , v ) 1 B ( v / u ) d u d v = ∫ W 1 { u ≤ f ( x ) } 1 B ( x ) u d u d x = ∫ B ( ∫ 0 f ( x ) u d u ) d x = 1 2 ∫ B f ( x ) d x \int_W \mathbf{1}_A(u, v)\,\mathbf{1}_B(v/u)\,du\,dv = \int_W \mathbf{1}\{u \le \sqrt{f(x)}\}\,\mathbf{1}_B(x)\,u\,du\,dx = \int_B\Bigl(\int_0^{\sqrt{f(x)}} u\,du\Bigr)dx = \frac12\int_B f(x)\,dx ∫ W 1 A ( u , v ) 1 B ( v / u ) d u d v = ∫ W 1 { u ≤ f ( x ) } 1 B ( x ) u d u d x = ∫ B ( ∫ 0 f ( x ) u d u ) d x = 2 1 ∫ B f ( x ) d x です。B = R B = \mathbb{R} B = R m ( A ) = c / 2 m(A) = c/2 m ( A ) = c /2 ( U , V ) (U, V) ( U , V ) 1 A / m ( A ) \mathbf{1}_A/m(A) 1 A / m ( A )
P ( V / U ∈ B ) = 2 c ∫ W 1 A ( u , v ) 1 B ( v / u ) d u d v = 1 c ∫ B f ( x ) d x \mathbb{P}(V/U \in B) = \frac{2}{c}\int_W \mathbf{1}_A(u, v)\,\mathbf{1}_B(v/u)\,du\,dv = \frac1c\int_B f(x)\,dx P ( V / U ∈ B ) = c 2 ∫ W 1 A ( u , v ) 1 B ( v / u ) d u d v = c 1 ∫ B f ( x ) d x です。
∎ A A A A A A f ( x ) = e − x 2 / 2 f(x) = e^{-x^2/2} f ( x ) = e − x 2 /2 0 < u ≤ sup f = 1 0 < u \le \sup\sqrt f = 1 0 < u ≤ sup f = 1 ∣ v ∣ = u ∣ x ∣ ≤ ∣ x ∣ e − x 2 / 4 ≤ 2 / e |v| = u|x| \le |x|e^{-x^2/4} \le \sqrt{2/e} ∣ v ∣ = u ∣ x ∣ ≤ ∣ x ∣ e − x 2 /4 ≤ 2/ e ∣ x ∣ = 2 |x| = \sqrt2 ∣ x ∣ = 2 A ⊆ ( 0 , 1 ] × [ − 2 / e , 2 / e ] A \subseteq (0, 1] \times [-\sqrt{2/e}, \sqrt{2/e}] A ⊆ ( 0 , 1 ] × [ − 2/ e , 2/ e ] 2 π / 2 2 2 / e = π e / 4 ≈ 0.731 \frac{\sqrt{2\pi}/2}{2\sqrt{2/e}} = \sqrt{\pi e}/4 \approx 0.731 2 2/ e 2 π /2 = π e /4 ≈ 0.731 u 2 ≤ e − ( v / u ) 2 / 2 u^2 \le e^{-(v/u)^2/2} u 2 ≤ e − ( v / u ) 2 /2
次の例は、ここまでの道具を組み合わせた実用的な方法です。ガンマ分布の密度を、立方の形に変数変換すると正規分布の密度でちょうど上から覆える形になる、という事実に基づきます。
例 5.7 (ガンマ分布の Marsaglia–Tsang 法 )
形状母数 α ≥ 1 \alpha \ge 1 α ≥ 1 x α − 1 e − x / Γ ( α ) x^{\alpha-1}e^{-x}/\Gamma(\alpha) x α − 1 e − x /Γ ( α ) x > 0 x > 0 x > 0 d = α − 1 3 d = \alpha - \frac13 d = α − 3 1 c = 1 / 9 d c = 1/\sqrt{9d} c = 1/ 9 d
Z ∼ N ( 0 , 1 ) Z \sim N(0,1) Z ∼ N ( 0 , 1 ) V = ( 1 + c Z ) 3 V = (1 + cZ)^3 V = ( 1 + c Z ) 3 V ≤ 0 V \le 0 V ≤ 0 U ∼ U ( 0 , 1 ) U \sim \mathrm{U}(0,1) U ∼ U ( 0 , 1 ) ln U < 1 2 Z 2 + d − d V + d ln V \ln U < \frac12Z^2 + d - dV + d\ln V ln U < 2 1 Z 2 + d − d V + d ln V X = d V X = dV X = d V これが正しい理由を確かめます。x = d ( 1 + c y ) 3 x = d(1 + cy)^3 x = d ( 1 + cy ) 3 y > − 1 / c y > -1/c y > − 1/ c d x = 3 d c ( 1 + c y ) 2 d y dx = 3dc(1 + cy)^2dy d x = 3 d c ( 1 + cy ) 2 d y
x α − 1 e − x d x ∝ ( 1 + c y ) 3 α − 3 e − d ( 1 + c y ) 3 ( 1 + c y ) 2 d y = exp ( d ln v − d v ) d y , v = ( 1 + c y ) 3 x^{\alpha-1}e^{-x}\,dx \ \propto\ (1 + cy)^{3\alpha - 3}e^{-d(1+cy)^3}(1 + cy)^2\,dy = \exp\bigl(d\ln v - dv\bigr)\,dy, \qquad v = (1 + cy)^3 x α − 1 e − x d x ∝ ( 1 + cy ) 3 α − 3 e − d ( 1 + cy ) 3 ( 1 + cy ) 2 d y = exp ( d ln v − d v ) d y , v = ( 1 + cy ) 3 です(3 α − 1 = 3 d 3\alpha - 1 = 3d 3 α − 1 = 3 d y y y f ( y ) = exp ( d ln v − d v + d ) f(y) = \exp(d\ln v - dv + d) f ( y ) = exp ( d ln v − d v + d ) y > − 1 / c y > -1/c y > − 1/ c 0 0 0 d ( 1 + c y ) 3 d(1 + cy)^3 d ( 1 + cy ) 3 f f f g = φ g = \varphi g = φ M = 2 π M = \sqrt{2\pi} M = 2 π f ( y ) ≤ e − y 2 / 2 f(y) \le e^{-y^2/2} f ( y ) ≤ e − y 2 /2 k ( y ) = d ln v − d v + d + 1 2 y 2 ≤ 0 k(y) = d\ln v - dv + d + \frac12y^2 \le 0 k ( y ) = d ln v − d v + d + 2 1 y 2 ≤ 0 w = 1 + c y w = 1 + cy w = 1 + cy 9 d c 2 = 1 9dc^2 = 1 9 d c 2 = 1
k ′ ( y ) = 3 d c ( 1 w − w 2 ) + w − 1 c = 1 3 c w ( 1 − w 3 + 3 w 2 − 3 w ) = ( 1 − w ) 3 3 c w k'(y) = 3dc\Bigl(\frac1w - w^2\Bigr) + \frac{w - 1}{c} = \frac{1}{3cw}\bigl(1 - w^3 + 3w^2 - 3w\bigr) = \frac{(1 - w)^3}{3cw} k ′ ( y ) = 3 d c ( w 1 − w 2 ) + c w − 1 = 3 c w 1 ( 1 − w 3 + 3 w 2 − 3 w ) = 3 c w ( 1 − w ) 3 なので、k k k y < 0 y < 0 y < 0 y > 0 y > 0 y > 0 k ( 0 ) = 0 k(0) = 0 k ( 0 ) = 0 定理 4.2 の 3 から出力は正しく、採択の条件 U ≤ f ( Z ) / ( M φ ( Z ) ) = e k ( Z ) U \le f(Z)/(M\varphi(Z)) = e^{k(Z)} U ≤ f ( Z ) / ( M φ ( Z )) = e k ( Z ) α = 1 \alpha = 1 α = 1 0.95 0.95 0.95 α \alpha α 1 1 1 0 < α < 1 0 < \alpha < 1 0 < α < 1 α + 1 \alpha + 1 α + 1 U 1 / α U^{1/\alpha} U 1/ α
n n n O ( log n ) O(\log n) O ( log n ) n n n
定義 6.1 (別名法の表 ) ↗
{ 1 , … , n } \{1, \ldots, n\} { 1 , … , n } p = ( p 1 , … , p n ) p = (p_1, \ldots, p_n) p = ( p 1 , … , p n ) 別名法の表 とは、数 t j ∈ [ 0 , 1 ] t_j \in [0, 1] t j ∈ [ 0 , 1 ] a j ∈ { 1 , … , n } a_j \in \{1, \ldots, n\} a j ∈ { 1 , … , n } ( t j , a j ) j = 1 n (t_j, a_j)_{j=1}^n ( t j , a j ) j = 1 n i i i
p i = 1 n ( t i + ∑ j : a j = i ( 1 − t j ) ) p_i = \frac1n\Bigl(t_i + \sum_{j\,:\,a_j = i}(1 - t_j)\Bigr) p i = n 1 ( t i + j : a j = i ∑ ( 1 − t j ) ) を満たすものをいう。
定理 6.2 (別名法 ) ✓
{ 1 , … , n } \{1, \ldots, n\} { 1 , … , n } p p p p p p { j , a j } \{j, a_j\} { j , a j } n n n q j = t j δ j + ( 1 − t j ) δ a j q_j = t_j\delta_j + (1 - t_j)\delta_{a_j} q j = t j δ j + ( 1 − t j ) δ a j p = 1 n ∑ j = 1 n q j p = \frac1n\sum_{j=1}^n q_j p = n 1 ∑ j = 1 n q j J J J { 1 , … , n } \{1, \ldots, n\} { 1 , … , n } V ∼ U ( 0 , 1 ) V \sim \mathrm{U}(0,1) V ∼ U ( 0 , 1 ) J J J V < t J V < t_J V < t J X = J X = J X = J X = a J X = a_J X = a J P ( X = i ) = p i \mathbb{P}(X = i) = p_i P ( X = i ) = p i 表は O ( n ) O(n) O ( n )
証明の方針は、背の高い棒から低い棒へ確率を少しずつ分けて、全部の棒を高さ 1 1 1 p = ( 1 2 , 1 4 , 1 4 ) p = (\frac12, \frac14, \frac14) p = ( 2 1 , 4 1 , 4 1 ) w = 3 p = ( 3 2 , 3 4 , 3 4 ) w = 3p = (\frac32, \frac34, \frac34) w = 3 p = ( 2 3 , 4 3 , 4 3 ) 1 4 \frac14 4 1 5 4 \frac54 4 5 1 1 1 1 1 1 3 4 \frac34 4 3 1 4 \frac14 4 1 t 2 = 3 4 t_2 = \frac34 t 2 = 4 3 a 2 = 1 a_2 = 1 a 2 = 1
証明(定理 6.2) 1. 次の主張を n n n
有限集合 I I I ∣ I ∣ = n ≥ 1 |I| = n \ge 1 ∣ I ∣ = n ≥ 1 w i ≥ 0 w_i \ge 0 w i ≥ 0 i ∈ I i \in I i ∈ I ∑ i ∈ I w i = n \sum_{i\in I}w_i = n ∑ i ∈ I w i = n t j ∈ [ 0 , 1 ] t_j \in [0,1] t j ∈ [ 0 , 1 ] a j ∈ I a_j \in I a j ∈ I j ∈ I j \in I j ∈ I i ∈ I i \in I i ∈ I w i = t i + ∑ j : a j = i ( 1 − t j ) w_i = t_i + \sum_{j : a_j = i}(1 - t_j) w i = t i + ∑ j : a j = i ( 1 − t j )
w i = n p i w_i = np_i w i = n p i n n n
n = 1 n = 1 n = 1 w i = 1 w_i = 1 w i = 1 t i = 1 t_i = 1 t i = 1 a i = i a_i = i a i = i w i = 1 + 0 w_i = 1 + 0 w i = 1 + 0
n ≥ 2 n \ge 2 n ≥ 2 1 1 1 w ℓ ≤ 1 w_\ell \le 1 w ℓ ≤ 1 ℓ ∈ I \ell \in I ℓ ∈ I I ′ = I ∖ { ℓ } I' = I \setminus \{\ell\} I ′ = I ∖ { ℓ } n − w ℓ ≥ n − 1 n - w_\ell \ge n - 1 n − w ℓ ≥ n − 1 I ′ I' I ′ n − 1 n - 1 n − 1 w h ≥ 1 w_h \ge 1 w h ≥ 1 h ∈ I ′ h \in I' h ∈ I ′
t ℓ = w ℓ , a ℓ = h , w h ′ = w h − ( 1 − w ℓ ) , w i ′ = w i ( i ∈ I ′ ∖ { h } ) t_\ell = w_\ell, \qquad a_\ell = h, \qquad w'_h = w_h - (1 - w_\ell), \qquad w'_i = w_i \ \ (i \in I' \setminus \{h\}) t ℓ = w ℓ , a ℓ = h , w h ′ = w h − ( 1 − w ℓ ) , w i ′ = w i ( i ∈ I ′ ∖ { h }) と置きます。w h ′ = ( w h − 1 ) + w ℓ ≥ 0 w'_h = (w_h - 1) + w_\ell \ge 0 w h ′ = ( w h − 1 ) + w ℓ ≥ 0 ∑ i ∈ I ′ w i ′ = n − w ℓ − ( 1 − w ℓ ) = n − 1 \sum_{i \in I'}w'_i = n - w_\ell - (1 - w_\ell) = n - 1 ∑ i ∈ I ′ w i ′ = n − w ℓ − ( 1 − w ℓ ) = n − 1 ( I ′ , w ′ ) (I', w') ( I ′ , w ′ ) t j ∈ [ 0 , 1 ] t_j \in [0,1] t j ∈ [ 0 , 1 ] a j ∈ I ′ a_j \in I' a j ∈ I ′ j ∈ I ′ j \in I' j ∈ I ′ w i ′ = t i + ∑ j ∈ I ′ : a j = i ( 1 − t j ) w'_i = t_i + \sum_{j \in I' : a_j = i}(1 - t_j) w i ′ = t i + ∑ j ∈ I ′ : a j = i ( 1 − t j ) ( t ℓ , a ℓ ) (t_\ell, a_\ell) ( t ℓ , a ℓ ) I I I
i = ℓ i = \ell i = ℓ a j = ℓ a_j = \ell a j = ℓ j j j j ∈ I ′ j \in I' j ∈ I ′ a j ∈ I ′ a_j \in I' a j ∈ I ′ a ℓ = h ≠ ℓ a_\ell = h \ne \ell a ℓ = h = ℓ t ℓ = w ℓ t_\ell = w_\ell t ℓ = w ℓ i = h i = h i = h t h + ∑ j ∈ I ′ : a j = h ( 1 − t j ) + ( 1 − t ℓ ) = w h ′ + ( 1 − w ℓ ) = w h t_h + \sum_{j \in I' : a_j = h}(1 - t_j) + (1 - t_\ell) = w'_h + (1 - w_\ell) = w_h t h + ∑ j ∈ I ′ : a j = h ( 1 − t j ) + ( 1 − t ℓ ) = w h ′ + ( 1 − w ℓ ) = w h それ以外の i ∈ I ′ i \in I' i ∈ I ′ a ℓ ≠ i a_\ell \ne i a ℓ = i w i ′ = w i w'_i = w_i w i ′ = w i
2. J J J V V V P ( X = i ) = ∑ j P ( J = j ) P ( X = i ∣ J = j ) \mathbb{P}(X = i) = \sum_j \mathbb{P}(J = j)\,\mathbb{P}(X = i \mid J = j) P ( X = i ) = ∑ j P ( J = j ) P ( X = i ∣ J = j ) J = j J = j J = j X = j X = j X = j t j t_j t j X = a j X = a_j X = a j 1 − t j 1 - t_j 1 − t j
P ( X = i ) = 1 n ( t i + ∑ j : a j = i ( 1 − t j ) ) = p i \mathbb{P}(X = i) = \frac1n\Bigl(t_i + \sum_{j : a_j = i}(1 - t_j)\Bigr) = p_i P ( X = i ) = n 1 ( t i + j : a j = i ∑ ( 1 − t j ) ) = p i です(a i = i a_i = i a i = i 1 − t i 1 - t_i 1 − t i X = i X = i X = i t i + ( 1 − t i ) t_i + (1 - t_i) t i + ( 1 − t i )
3. 1 の証明の帰納の 1 段は、「w ℓ ≤ 1 w_\ell \le 1 w ℓ ≤ 1 ℓ \ell ℓ w h ≥ 1 w_h \ge 1 w h ≥ 1 h h h w i < 1 w_i < 1 w i < 1 w i ≥ 1 w_i \ge 1 w i ≥ 1 ℓ \ell ℓ h h h h h h w h w_h w h ℓ \ell ℓ n n n w i = 1 w_i = 1 w i = 1 1 1 1 1 1 1 1 1 1 t i = 1 t_i = 1 t i = 1 a i = i a_i = i a i = i O ( n ) O(n) O ( n )
∎ 2 では J J J V V V U ∼ U ( 0 , 1 ) U \sim \mathrm{U}(0,1) U ∼ U ( 0 , 1 ) J = ⌊ n U ⌋ + 1 J = \lfloor nU\rfloor + 1 J = ⌊ n U ⌋ + 1 V = n U − ⌊ n U ⌋ V = nU - \lfloor nU\rfloor V = n U − ⌊ n U ⌋ 演習 7.3 )。次のコードは 3 の手順(Vose の方法)の実装と、頻度の検定です。
# Python 3.9.6, NumPy 2.0.2
""" 確率ベクトル p から別名法の表 (t, a) を O(n) で作る(Vose) """
t, a = [ 1.0 ] * n, list ( range ( n ))
small = [ i for i in range ( n ) if w[i] < 1.0 ]
large = [ i for i in range ( n ) if w[i] >= 1.0 ]
l, h = small. pop (), large. pop ()
(small if w[h] < 1.0 else large). append ( h )
return np. array ( t ), np. array ( a ) # 残った列は t = 1(丸め誤差の吸収)
def alias_sample ( t , a , size , rng ) :
j = rng. integers ( len ( t ) , size = size )
return np. where ( rng. random ( size ) < t [ j ] , j , a [ j ])
p = [ 0.05 , 0.30 , 0.10 , 0.25 , 0.02 , 0.28 ]
print ( " t = " , np. round ( t , 4 ) , " a = " , a )
recon = t / 6 + np. bincount ( a , weights = ( 1 - t) / 6 , minlength = 6 )
print ( " 表から復元した確率: " , np. round ( recon , 12 ))
rng = np.random. default_rng ( 20261008 )
counts = np. bincount ( alias_sample ( t , a , N , rng ) , minlength = 6 )
chi2 = float ( np. sum ( (counts - N * np. array ( p ) ) ** 2 / (N * np. array ( p ) ) ))
print ( f "カイ二乗統計量 = {chi2 :.2f } (自由度 5。平均 5、標準偏差 {np. sqrt ( 10 ) :.2f } )" )
t = [0.3 1. 0.6 0.9 0.12 0.8 ] a = [1 1 3 1 5 3]
表から復元した確率: [0.05 0.3 0.1 0.25 0.02 0.28]
度数: [ 49953 299851 100264 249536 20084 280312]
カイ二乗統計量 = 2.38(自由度 5。平均 5、標準偏差 3.16)
表から 定義 6.1 の式で復元した確率は p p p 10 6 10^6 1 0 6 2.38 2.38 2.38 5 5 5 5 5 5 0 0 0
定理 6.3 (Fisher–Yates の方法 ) ✓
互いに異なる n ≥ 1 n \ge 1 n ≥ 1 a [ 0 ] , … , a [ n − 1 ] a[0], \ldots, a[n-1] a [ 0 ] , … , a [ n − 1 ] i = n − 1 , n − 2 , … , 1 i = n-1, n-2, \ldots, 1 i = n − 1 , n − 2 , … , 1 { 0 , 1 , … , i } \{0, 1, \ldots, i\} { 0 , 1 , … , i } J i J_i J i J J J a [ i ] a[i] a [ i ] a [ J i ] a[J_i] a [ J i ]
1 ≤ k ≤ n − 1 1 \le k \le n - 1 1 ≤ k ≤ n − 1 k k k i = n − 1 , … , n − k i = n-1, \ldots, n-k i = n − 1 , … , n − k e 1 , … , e k e_1, \ldots, e_k e 1 , … , e k P ( a [ n − 1 ] = e 1 , a [ n − 2 ] = e 2 , … , a [ n − k ] = e k ) = 1 n ( n − 1 ) ⋯ ( n − k + 1 ) \mathbb{P}\bigl(a[n-1] = e_1,\ a[n-2] = e_2,\ \ldots,\ a[n-k] = e_k\bigr) = \frac{1}{n(n-1)\cdots(n-k+1)} P ( a [ n − 1 ] = e 1 , a [ n − 2 ] = e 2 , … , a [ n − k ] = e k ) = n ( n − 1 ) ⋯ ( n − k + 1 ) 1 k k k ( n k ) \binom nk ( k n ) k k k すべての操作の後の配列は、n ! n! n !
「i = 0 , 1 , … , n − 1 i = 0, 1, \ldots, n-1 i = 0 , 1 , … , n − 1 { 0 , … , n − 1 } \{0, \ldots, n-1\} { 0 , … , n − 1 } J i J_i J i a [ i ] a[i] a [ i ] a [ J i ] a[J_i] a [ J i ] n ≥ 3 n \ge 3 n ≥ 3
証明(定理 6.3) 1. k k k i = n − k i = n - k i = n − k n − k + 1 , … , n − 1 n-k+1, \ldots, n-1 n − k + 1 , … , n − 1 0 , … , n − k 0, \ldots, n-k 0 , … , n − k n − k + 1 n - k + 1 n − k + 1
k = 1 k = 1 k = 1 e 1 e_1 e 1 j ∗ ∈ { 0 , … , n − 1 } j^* \in \{0, \ldots, n-1\} j ∗ ∈ { 0 , … , n − 1 } a [ n − 1 ] = e 1 a[n-1] = e_1 a [ n − 1 ] = e 1 J n − 1 = j ∗ J_{n-1} = j^* J n − 1 = j ∗ 1 / n 1/n 1/ n
k ≥ 2 k \ge 2 k ≥ 2 E = { a [ n − 1 ] = e 1 , … , a [ n − k + 1 ] = e k − 1 } E = \{a[n-1] = e_1, \ldots, a[n-k+1] = e_{k-1}\} E = { a [ n − 1 ] = e 1 , … , a [ n − k + 1 ] = e k − 1 } k − 1 k - 1 k − 1 1 / ( n ( n − 1 ) ⋯ ( n − k + 2 ) ) 1/(n(n-1)\cdots(n-k+2)) 1/ ( n ( n − 1 ) ⋯ ( n − k + 2 )) E E E J n − 1 , … , J n − k + 1 J_{n-1}, \ldots, J_{n-k+1} J n − 1 , … , J n − k + 1 E E E e k e_k e k e 1 , … , e k − 1 e_1, \ldots, e_{k-1} e 1 , … , e k − 1 0 , … , n − k 0, \ldots, n-k 0 , … , n − k j ∗ j^* j ∗ a [ n − k ] = e k a[n-k] = e_k a [ n − k ] = e k J n − k = j ∗ J_{n-k} = j^* J n − k = j ∗ J n − k J_{n-k} J n − k J J J { 0 , … , n − k } \{0, \ldots, n-k\} { 0 , … , n − k } 1 / ( n − k + 1 ) 1/(n-k+1) 1/ ( n − k + 1 )
部分集合については、k k k k k k k ! k! k ! k ! / ( n ( n − 1 ) ⋯ ( n − k + 1 ) ) = 1 / ( n k ) k!/(n(n-1)\cdots(n-k+1)) = 1/\binom nk k ! / ( n ( n − 1 ) ⋯ ( n − k + 1 )) = 1/ ( k n )
2. n = 1 n = 1 n = 1 n ≥ 2 n \ge 2 n ≥ 2 k = n − 1 k = n - 1 k = n − 1 1 , … , n − 1 1, \ldots, n-1 1 , … , n − 1 0 0 0 1 / ( n ( n − 1 ) ⋯ 2 ) = 1 / n ! 1/(n(n-1)\cdots2) = 1/n! 1/ ( n ( n − 1 ) ⋯ 2 ) = 1/ n !
3. 添字の列 ( J 0 , … , J n − 1 ) (J_0, \ldots, J_{n-1}) ( J 0 , … , J n − 1 ) n n n^n n n n − n n^{-n} n − n π \pi π N π N_\pi N π P ( π ) = N π / n n \mathbb{P}(\pi) = N_\pi/n^n P ( π ) = N π / n n N π = n n / n ! N_\pi = n^n/n! N π = n n / n ! n ! ∣ n n n! \mid n^n n ! ∣ n n n ≥ 3 n \ge 3 n ≥ 3 n − 1 ≥ 2 n - 1 \ge 2 n − 1 ≥ 2 n ! n! n ! n − 1 ∣ n n n - 1 \mid n^n n − 1 ∣ n n gcd ( n − 1 , n ) = 1 \gcd(n-1, n) = 1 g cd( n − 1 , n ) = 1 gcd ( n − 1 , n n ) = 1 \gcd(n-1, n^n) = 1 g cd( n − 1 , n n ) = 1 補題 7.2[整除と素因数分解] )、n − 1 ∣ n n n - 1 \mid n^n n − 1 ∣ n n n − 1 = 1 n - 1 = 1 n − 1 = 1 n ≥ 3 n \ge 3 n ≥ 3
∎ 3 の誤りは、見た目が自然なだけに実際のプログラムによく現れます。n = 3 n = 3 n = 3
# Python 3.9.6(標準ライブラリのみ)
from itertools import product
from collections import Counter
def naive ( js ) : # すべての位置 i を無作為な位置 j と交換
for i, j in enumerate ( js ):
def fisher_yates ( js ) : # i = 2, 1 の順に、0..i から選んだ j と交換
for i, j in zip ( ( 2 , 1 ) , js ):
c1 = Counter ( naive ( js ) for js in product ( range ( 3 ) , repeat = 3 ))
c2 = Counter ( fisher_yates ( js ) for js in product ( range ( 3 ) , range ( 2 )))
print ( perm , f "素朴な方法 {c1 [ perm ] } /27 Fisher–Yates {c2 [ perm ] } /6" )
(0, 1, 2) 素朴な方法 4/27 Fisher–Yates 1/6
(0, 2, 1) 素朴な方法 5/27 Fisher–Yates 1/6
(1, 0, 2) 素朴な方法 5/27 Fisher–Yates 1/6
(1, 2, 0) 素朴な方法 5/27 Fisher–Yates 1/6
(2, 0, 1) 素朴な方法 4/27 Fisher–Yates 1/6
(2, 1, 0) 素朴な方法 4/27 Fisher–Yates 1/6
素朴な方法では確率が 4 / 27 ≈ 0.148 4/27 \approx 0.148 4/27 ≈ 0.148 5 / 27 ≈ 0.185 5/27 \approx 0.185 5/27 ≈ 0.185 1 / 6 ≈ 0.167 1/6 \approx 0.167 1/6 ≈ 0.167
最後に、命題 3.5 と 命題 5.5 の数値を任意精度で確かめます。
# Python 3.9.6, mpmath 1.3.0
from mpmath import mp, mpf, log, sqrt, erfc, findroot, pi, gamma
print ( " 指数分布 -ln(1-U) の最大値 53 ln 2 = " , log ( 2 ) * 53 )
z = findroot ( lambda t : erfc ( t / sqrt ( 2 )) / 2 - umin , 8 )
print ( " 正規分布(逆関数法)の最大値 z* = " , z )
print ( " Box-Muller の動径の最大値 sqrt(2*53 ln 2) = " , sqrt ( 2 * 53 * log ( 2 )))
for d in ( 2 , 3 , 5 , 10 , 20 ):
print ( f "d = {d :2d } : 球/立方体 = { float ( pi ** ( mpf ( d ) / 2 ) / ( 2 ** d * gamma ( mpf ( d ) / 2 + 1 ) ) ) :.3e } " )
指数分布 -ln(1-U) の最大値 53 ln 2 = 36.7368005696771013991133024373
正規分布(逆関数法)の最大値 z* = 8.20953615160138685563076877867
Box-Muller の動径の最大値 sqrt(2*53 ln 2) = 8.57167434865290497745122222678
d = 10: 球/立方体 = 2.490e-03
d = 20: 球/立方体 = 2.461e-08
演習 7.1 易
0 < p < 1 0 < p < 1 0 < p < 1 q = 1 − p q = 1 - p q = 1 − p U ∼ U ( 0 , 1 ) U \sim \mathrm{U}(0,1) U ∼ U ( 0 , 1 ) X = ⌈ ln ( 1 − U ) / ln q ⌉ X = \lceil \ln(1 - U)/\ln q\rceil X = ⌈ ln ( 1 − U ) / ln q ⌉ p p p P ( X = k ) = q k − 1 p \mathbb{P}(X = k) = q^{k-1}p P ( X = k ) = q k − 1 p k ≥ 1 k \ge 1 k ≥ 1
解答 ln q < 0 \ln q < 0 ln q < 0 1 − U ∈ ( 0 , 1 ) 1 - U \in (0, 1) 1 − U ∈ ( 0 , 1 ) Y = ln ( 1 − U ) / ln q > 0 Y = \ln(1 - U)/\ln q > 0 Y = ln ( 1 − U ) / ln q > 0 X = ⌈ Y ⌉ ≥ 1 X = \lceil Y\rceil \ge 1 X = ⌈ Y ⌉ ≥ 1 k ≥ 0 k \ge 0 k ≥ 0 X > k ⟺ Y > k X > k \iff Y > k X > k ⟺ Y > k ln q < 0 \ln q < 0 ln q < 0
P ( X > k ) = P ( ln ( 1 − U ) < k ln q ) = P ( 1 − U < q k ) = q k \mathbb{P}(X > k) = \mathbb{P}\bigl(\ln(1 - U) < k\ln q\bigr) = \mathbb{P}(1 - U < q^k) = q^k P ( X > k ) = P ( ln ( 1 − U ) < k ln q ) = P ( 1 − U < q k ) = q k です(1 − U ∼ U ( 0 , 1 ) 1 - U \sim \mathrm{U}(0,1) 1 − U ∼ U ( 0 , 1 ) P ( X = k ) = q k − 1 − q k = q k − 1 p \mathbb{P}(X = k) = q^{k-1} - q^k = q^{k-1}p P ( X = k ) = q k − 1 − q k = q k − 1 p − ln q -\ln q − ln q 1 / p 1/p 1/ p
演習 7.2 標準
目標を密度 f ( x ) = 6 x ( 1 − x ) f(x) = 6x(1 - x) f ( x ) = 6 x ( 1 − x ) 0 < x < 1 0 < x < 1 0 < x < 1 ( 0 , 1 ) (0,1) ( 0 , 1 ) M M M M = 1 M = 1 M = 1 x = 1 2 x = \frac12 x = 2 1
解答 (1) f / g = 6 x ( 1 − x ) f/g = 6x(1-x) f / g = 6 x ( 1 − x ) x = 1 2 x = \frac12 x = 2 1 3 2 \frac32 2 3 M = 3 2 M = \frac32 M = 2 3 定理 4.2 の 3 から 1 / M = 2 3 1/M = \frac23 1/ M = 3 2
(2) 定理 4.2 の 2 から、出力の密度は h = min ( f , 1 ) h = \min(f, 1) h = min ( f , 1 ) 6 x ( 1 − x ) ≥ 1 6x(1-x) \ge 1 6 x ( 1 − x ) ≥ 1 x − ≤ x ≤ x + x_- \le x \le x_+ x − ≤ x ≤ x + x ± = 1 2 ± 1 2 3 x_\pm = \frac12 \pm \frac{1}{2\sqrt3} x ± = 2 1 ± 2 3 1
∫ 0 1 h = 1 − ∫ x − x + ( 6 x ( 1 − x ) − 1 ) d x = 1 − ∫ x − x + 6 ( x − x − ) ( x + − x ) d x = 1 − ( x + − x − ) 3 = 1 − 1 3 3 ≈ 0.8075 \int_0^1 h = 1 - \int_{x_-}^{x_+}\bigl(6x(1-x) - 1\bigr)dx = 1 - \int_{x_-}^{x_+} 6(x - x_-)(x_+ - x)\,dx = 1 - (x_+ - x_-)^3 = 1 - \frac{1}{3\sqrt3} \approx 0.8075 ∫ 0 1 h = 1 − ∫ x − x + ( 6 x ( 1 − x ) − 1 ) d x = 1 − ∫ x − x + 6 ( x − x − ) ( x + − x ) d x = 1 − ( x + − x − ) 3 = 1 − 3 3 1 ≈ 0.8075 です(∫ a b ( x − a ) ( b − x ) d x = ( b − a ) 3 / 6 \int_a^b (x-a)(b-x)\,dx = (b-a)^3/6 ∫ a b ( x − a ) ( b − x ) d x = ( b − a ) 3 /6 min ( 6 x ( 1 − x ) , 1 ) / 0.8075 \min(6x(1-x), 1)/0.8075 min ( 6 x ( 1 − x ) , 1 ) /0.8075 x = 1 2 x = \frac12 x = 2 1 1.238 1.238 1.238 1.5 1.5 1.5 1 / 0.8075 ≈ 1.24 1/0.8075 \approx 1.24 1/0.8075 ≈ 1.24
演習 7.4 標準
p = ( 1 2 , 1 3 , 1 12 , 1 12 ) p = (\frac12, \frac13, \frac1{12}, \frac1{12}) p = ( 2 1 , 3 1 , 12 1 , 12 1 ) 定理 6.2 の証明の手順で作り、定義 6.1 の式を確かめよ。
解答 w = 4 p = ( 2 , 4 3 , 1 3 , 1 3 ) w = 4p = (2, \frac43, \frac13, \frac13) w = 4 p = ( 2 , 3 4 , 3 1 , 3 1 )
ℓ = 3 \ell = 3 ℓ = 3 w 3 = 1 3 w_3 = \frac13 w 3 = 3 1 h = 1 h = 1 h = 1 t 3 = 1 3 t_3 = \frac13 t 3 = 3 1 a 3 = 1 a_3 = 1 a 3 = 1 w 1 ← 2 − 2 3 = 4 3 w_1 \leftarrow 2 - \frac23 = \frac43 w 1 ← 2 − 3 2 = 3 4 { 1 , 2 , 4 } \{1, 2, 4\} { 1 , 2 , 4 } w = ( 4 3 , 4 3 , 1 3 ) w = (\frac43, \frac43, \frac13) w = ( 3 4 , 3 4 , 3 1 ) 3 3 3 ℓ = 4 \ell = 4 ℓ = 4 h = 1 h = 1 h = 1 t 4 = 1 3 t_4 = \frac13 t 4 = 3 1 a 4 = 1 a_4 = 1 a 4 = 1 w 1 ← 4 3 − 2 3 = 2 3 w_1 \leftarrow \frac43 - \frac23 = \frac23 w 1 ← 3 4 − 3 2 = 3 2 { 1 , 2 } \{1, 2\} { 1 , 2 } w = ( 2 3 , 4 3 ) w = (\frac23, \frac43) w = ( 3 2 , 3 4 ) 2 2 2 ℓ = 1 \ell = 1 ℓ = 1 h = 2 h = 2 h = 2 t 1 = 2 3 t_1 = \frac23 t 1 = 3 2 a 1 = 2 a_1 = 2 a 1 = 2 w 2 ← 4 3 − 1 3 = 1 w_2 \leftarrow \frac43 - \frac13 = 1 w 2 ← 3 4 − 3 1 = 1 { 2 } \{2\} { 2 } t 2 = 1 t_2 = 1 t 2 = 1 a 2 = 2 a_2 = 2 a 2 = 2 確かめると、p 1 = 1 4 ( t 1 + ( 1 − t 3 ) + ( 1 − t 4 ) ) = 1 4 ⋅ 2 = 1 2 p_1 = \frac14\bigl(t_1 + (1 - t_3) + (1 - t_4)\bigr) = \frac14\cdot2 = \frac12 p 1 = 4 1 ( t 1 + ( 1 − t 3 ) + ( 1 − t 4 ) ) = 4 1 ⋅ 2 = 2 1 p 2 = 1 4 ( t 2 + ( 1 − t 1 ) ) = 1 4 ⋅ 4 3 = 1 3 p_2 = \frac14\bigl(t_2 + (1 - t_1)\bigr) = \frac14\cdot\frac43 = \frac13 p 2 = 4 1 ( t 2 + ( 1 − t 1 ) ) = 4 1 ⋅ 3 4 = 3 1 p 3 = 1 4 t 3 = 1 12 p_3 = \frac14t_3 = \frac1{12} p 3 = 4 1 t 3 = 12 1 p 4 = 1 4 t 4 = 1 12 p_4 = \frac14t_4 = \frac1{12} p 4 = 4 1 t 4 = 12 1 a 2 = 2 a_2 = 2 a 2 = 2 1 − t 2 = 0 1 - t_2 = 0 1 − t 2 = 0 ℓ , h \ell, h ℓ , h
L. Devroye, Non-Uniform Random Variate Generation , Springer, 1986 — 逆関数法(第 II 章 2 節)、棄却法(第 II 章 3 節)、別名法(第 III 章 4 節)。
D. E. Knuth, The Art of Computer Programming, Volume 2: Seminumerical Algorithms , 3rd ed., Addison-Wesley, 1997 — 3.4 節(他の種類の乱数)。
G. E. P. Box, M. E. Muller, “A note on the generation of random normal deviates”, Annals of Mathematical Statistics 29 (1958), 610–611.
A. J. Walker, “An efficient method for generating discrete random variables with general distributions”, ACM Transactions on Mathematical Software 3 (1977), 253–256.
M. D. Vose, “A linear algorithm for generating random numbers with a given distribution”, IEEE Transactions on Software Engineering 17 (1991), 972–975.
A. J. Kinderman, J. F. Monahan, “Computer generation of random variables using the ratio of uniform deviates”, ACM Transactions on Mathematical Software 3 (1977), 257–260.
G. Marsaglia, W. W. Tsang, “A simple method for generating gamma variables”, ACM Transactions on Mathematical Software 26 (2000), 363–372.
A. W. van der Vaart, Asymptotic Statistics , Cambridge University Press, 1998 — 第 19 章(経験過程と Kolmogorov–Smirnov 統計量)。
執筆: Claude Code(Opus 5.5)、Claude Code(Sonnet 5.5)・監査 2 回(Claude Code)・最終 2026-10-12