# 分布からの標本抽出：逆関数法・棄却法・正規乱数・離散分布

> 一様乱数から指定した分布の標本を作る方法を証明つきで扱う。一般化逆関数による逆関数法、棄却法の正しさと採択率、Box–Muller 法と多次元正規分布、球面上の一様分布、別名法、Fisher–Yates の方法、倍精度の一様乱数が裾に届く範囲。
> https://rikai.mugen-giken.com/computer-science/stochastic-computation/sampling-from-distributions

## 0. この記事の要点

コンピュータが直接作れるのは、どの値も同じ確率で出るくじ引きのような乱数（一様乱数）です。ところが実際の計算では、正規分布に従う値や、目の出やすさに偏りのあるサイコロのような、偏った乱数が必要になります。この記事は、くじ引きの乱数だけを材料にして、望みの偏りをもつ乱数を正確に作る方法を、なぜ正確になるかの証明つきで説明します。読み終えると、目的の分布に応じてどの方法を選べばよいかと、各方法で何に気をつけるべきかが分かります。

- $U$ が $(0,1)$ 上の一様分布に従うなら、[分布関数](/mathematics/probability/random-variables#def-distribution) $F$ の一般化逆関数（$F$ の逆関数を、跳びや平らな部分があっても使えるように広げたもの）$F^{-}(u) = \inf\{x : F(x) \ge u\}$ について $F^{-}(U)$ の分布関数は $F$ です。$F$ が連続でも狭義単調でもなくて構いません（<Ref to="thm-inverse-transform" />）。
- **棄却法**は、$f \le Mg$ を満たす提案密度 $g$ から標本を作り、確率 $f/(Mg)$ で採択します。採択された標本の密度は $f$ に比例し、$f$ の正規化定数を知らなくても使えます。包絡（$f \le Mg$ という、$f$ を上から覆う条件）が外れていると、得られる密度は $\min(f, Mg)$ に比例するものに変わります（<Ref to="thm-rejection-sampling" />）。
- 正規乱数は変数変換で作ります。Box–Muller 法は 2 個の一様乱数から独立な標準正規乱数を 2 個作り（<Ref to="prop-box-muller" />）、共分散 $\Sigma = LL^{\mathsf{T}}$ の正規ベクトルは $\mu + LZ$ で得られます（<Ref to="prop-gaussian-vector-sampling" />）。
- $n$ 点上の任意の離散分布は、2 点以下に載る $n$ 個の分布の等確率の混合に書けます。これが、1 個あたり $O(1)$ で標本を作る**別名法**の根拠です（<Ref to="thm-alias-method" />）。
- 一様な順列は Fisher–Yates の方法で作ります。全要素を無作為な位置と交換する素朴な方法は、$n \ge 3$ で一様になりません（<Ref to="thm-fisher-yates" />）。
- 倍精度の一様乱数は $2^{-53}$ の倍数なので、逆関数法で届く裾は有限です。指数分布で約 $36.7$、正規分布で約 $8.2$ までです（<Ref to="prop-float-uniform" />）。

<Aside type="tip" title="この記事で使う事前知識">

- **確率変数**: 試行の結果に応じて値が決まる量を、数学的に可測な関数として扱ったもの。→ [確率変数](/mathematics/probability/random-variables#def-random-variable)
- **期待値**: 確率変数の値を確率で重みづけして平均したもの。→ [期待値](/mathematics/probability/random-variables#def-expectation)
- **分布関数**: 確率変数が $x$ 以下になる確率を $x$ の関数として表したもの。→ [分布関数](/mathematics/probability/random-variables#def-distribution)
- **特性関数**: 分布を $\mathbb{E}[e^{i t X}]$ という関数で表したもので、分布を一意に決める。→ [特性関数](/mathematics/probability/characteristic-functions-gaussian#def-cf)
- **擬似乱数生成器**: 決まった規則から、乱数のように見える列を作る仕組み。→ [擬似乱数生成器](/computer-science/stochastic-computation/pseudorandom-generators)

</Aside>

## 1. 動機

[前章](/computer-science/stochastic-computation/pseudorandom-generators)の生成器が返すのは、整数の上の（近似的に）一様な乱数です。ところが Monte Carlo 法で必要なのは、正規分布、指数分布、指定した重みをもつ離散分布、球面上の一様分布、といったさまざまな分布からの標本です。この章の問題は、**独立な一様乱数の列だけを材料にして、指定した分布に正確に従う確率変数を作ること**です。

「正確に」が要点です。たとえば 12 個の一様乱数の和から 6 を引くと正規分布に似た乱数ができますが、その分布は正規分布ではなく、$|x| > 6$ の値は決して出ません。裾の確率を推定する計算では、この違いが結果を壊します。この章の方法はどれも、一様乱数が理想的（独立で $(0,1)$ 上に一様）であるという仮定のもとで、出力の分布が目標の分布に厳密に一致することを証明できます。現実の計算機との差は、擬似乱数であること（前章）と、一様乱数が有限個の値しか取らないこと（<Ref to="prop-float-uniform" />）の 2 点に限られます。

方法は 3 つの系統に分かれます。分布関数の逆関数を使う方法（§3）、作りやすい分布から作って捨てる方法（§4）、変数変換で作る方法（§5）です。離散分布と順列には専用の方法があります（§6）。

## 2. 準備

確率変数・分布・分布関数・期待値は[確率変数と期待値](/mathematics/probability/random-variables)（<Ref to="mathematics/probability/random-variables#def-distribution" />）の定義に従います。$\mathbb{R}^d$ のルベーグ測度を $m$ と書きます。

<Definition id="def-density-vector" title="密度・一様分布">
$\mathbb{R}^d$ 値の確率変数 $X$ が**密度** $p$ をもつとは、ボレル可測な $p : \mathbb{R}^d \to [0, \infty)$ があって、すべてのボレル集合 $B$ について $\mathbb{P}(X \in B) = \int_B p(x)\,dx$ となることをいう。$0 < m(A) < \infty$ のボレル集合 $A$ について、密度 $\mathbf{1}_A/m(A)$ をもつ分布を **$A$ 上の一様分布**という。$(0,1)$ 上の一様分布を $\mathrm{U}(0,1)$ と書く。$U \sim \mathrm{U}(0,1)$ なら $0 \le t \le 1$ について $\mathbb{P}(U \le t) = t$ である。
</Definition>

独立な確率変数（<Ref to="mathematics/probability/random-variables#def-independence" />）を並べたベクトルの密度は、密度の積です。この事実を何度も使うので、補題にしておきます。

<Lemma id="lem-joint-density" title="独立な確率変数の同時密度">
実確率変数 $X_1, \ldots, X_n$ が独立で、$X_i$ が密度 $p_i$ をもつとする。このとき $(X_1, \ldots, X_n)$ は密度 $p(x) = p_1(x_1)\cdots p_n(x_n)$ をもつ。
</Lemma>

<Proof of="lem-joint-density">
$\mathcal{B}(\mathbb{R}^n)$ 上の 2 つの集合関数 $\mu(B) = \mathbb{P}((X_1, \ldots, X_n) \in B)$、$\nu(B) = \int_B p(x)\,dx$ を考えます。$\mu$ は確率測度です。$\nu$ は非負関数の積分なので測度で、Tonelli の定理（<Ref to="mathematics/real-analysis/product-measures-fubini#thm-tonelli" />）から $\nu(\mathbb{R}^n) = \prod_i \int p_i = 1$ です。

箱 $B = B_1 \times \cdots \times B_n$（$B_i \in \mathcal{B}(\mathbb{R})$）については、独立性から $\mu(B) = \prod_i \mathbb{P}(X_i \in B_i) = \prod_i \int_{B_i} p_i$、Tonelli の定理から $\nu(B) = \prod_i \int_{B_i} p_i$ で、両者は一致します。箱の全体は共通部分で閉じ（π-系）、$\mathbb{R}^n$ 自身を含み、$\mathcal{B}(\mathbb{R}^n)$ を生成します（<Ref to="mathematics/real-analysis/product-measures-fubini#prop-borel-product" />）。測度の一意性（<Ref to="mathematics/real-analysis/abstract-measures#thm-uniqueness-measures" />）から $\mu = \nu$ です。
</Proof>

<Definition id="def-float-uniform" title="倍精度の一様乱数">
集合 $G_{53} = \{k\,2^{-53} : k = 0, 1, \ldots, 2^{53} - 1\} \subset [0, 1)$ の各点を確率 $2^{-53}$ で取る確率変数を**倍精度の一様乱数**という。
</Definition>

NumPy の `Generator.random` は、64 ビットの出力の上位 53 ビットを整数 $k$ とみて $k\,2^{-53}$ を返します。$G_{53}$ の点はすべて binary64 で正確に表せます。以下の定理は理想的な $U \sim \mathrm{U}(0,1)$ について述べ、$G_{53}$ に置き換えたときの違いを <Ref to="prop-float-uniform" /> で調べます。

## 3. 逆関数法

分布関数 $F$ が連続で狭義単調増加なら、逆関数 $F^{-1}$ があり、$\mathbb{P}(F^{-1}(U) \le x) = \mathbb{P}(U \le F(x)) = F(x)$ です。離散分布のように $F$ が跳びや平らな部分をもつときにも同じ計算が通るように、逆関数を次のように一般化します。

<Definition id="def-quantile" title="一般化逆関数（分位点関数）">
$F : \mathbb{R} \to [0,1]$ を分布関数、すなわち単調非減少・右連続で $\lim_{x\to-\infty}F(x) = 0$、$\lim_{x\to\infty}F(x) = 1$ を満たす関数とする（<Ref to="mathematics/probability/random-variables#prop-distribution-is-measure" />）。$0 < u < 1$ に対して
$$
F^{-}(u) = \inf\{x \in \mathbb{R} : F(x) \ge u\}
$$
を $F$ の**一般化逆関数**（分位点関数）という。
</Definition>

<Lemma id="lem-quantile-galois" title="一般化逆関数の基本性質">
分布関数 $F$、$0 < u < 1$、$x \in \mathbb{R}$ について、$F^{-}(u)$ は有限の実数で、
$$
F^{-}(u) \le x \iff u \le F(x)
$$
が成り立つ。
</Lemma>

<Proof of="lem-quantile-galois">
$A_u = \{x : F(x) \ge u\}$ と置きます。$\lim_{x\to\infty}F(x) = 1 > u$ なので $A_u$ は空でなく、$\lim_{x\to-\infty}F(x) = 0 < u$ なので $A_u$ は下に有界です。よって $q = \inf A_u = F^{-}(u)$ は実数です。$F$ が単調非減少なので、$x \in A_u$ かつ $x' \ge x$ なら $x' \in A_u$ です。さらに、$A_u$ の点列 $x_n \downarrow q$ を取ると、右連続性から $F(q) = \lim_n F(x_n) \ge u$ なので $q \in A_u$ です。したがって $A_u = [q, \infty)$ です。これは「$u \le F(x) \iff x \ge q$」を意味します。
</Proof>

<Theorem id="thm-inverse-transform" title="逆関数法">
$F$ を分布関数、$U \sim \mathrm{U}(0,1)$ とする。

1. $X = F^{-}(U)$ は確率変数で、その分布関数は $F$ である。
2. 逆に、$X$ の分布関数 $F$ が連続ならば、$F(X) \sim \mathrm{U}(0,1)$ である。
</Theorem>

証明の方針です。1 は、補題で「$F^{-}(U) \le x$」を「$U \le F(x)$」という $U$ だけの条件に言い換え、$U$ が $t$ 以下になる確率は $t$ であることを使うだけです。2 は逆向きに、$F(X)$ が $u$ 以下になる確率が $u$ であることを、$u$ に近づく極限で確かめます。

<Proof of="thm-inverse-transform">
**1.** <Ref to="lem-quantile-galois" /> から、任意の $x \in \mathbb{R}$ について
$$
\{F^{-}(U) \le x\} = \{U \le F(x)\}
$$
です。右辺は事象なので、$F^{-}(U)$ は確率変数です（半直線の逆像が可測であれば十分です。<Ref to="mathematics/probability/random-variables#cor-half-line-criterion" />）。確率を取ると $\mathbb{P}(F^{-}(U) \le x) = \mathbb{P}(U \le F(x)) = F(x)$ です。

**2.** $0 < u < 1$ を取り、$q = F^{-}(u)$ と置きます。<Ref to="lem-quantile-galois" /> から $\{F(X) \ge u\} = \{X \ge q\}$ です。まず $F(q) = u$ を示します。補題で $x = q$ とすると $F(q) \ge u$ です。$x < q$ では補題から $F(x) < u$ なので、$x \uparrow q$ として $F$ の連続性から $F(q) \le u$ です。次に、$F$ が連続なので $\mathbb{P}(X = q) = F(q) - \lim_{x \uparrow q}F(x) = 0$ です。よって
$$
\mathbb{P}(F(X) \ge u) = \mathbb{P}(X \ge q) = 1 - \mathbb{P}(X \le q) + \mathbb{P}(X = q) = 1 - F(q) = 1 - u,
$$
すなわち $\mathbb{P}(F(X) < u) = u$ がすべての $0 < u < 1$ で成り立ちます。$0 < u < 1$ について、事象 $\{F(X) < u + 1/n\}$ は $n \to \infty$ で $\{F(X) \le u\}$ に単調に減少するので、$\mathbb{P}(F(X) \le u) = \lim_n (u + 1/n) = u$ です。$F(X)$ は $[0,1]$ に値を取るので、$u \ge 1$ では $\mathbb{P}(F(X) \le u) = 1$、$u < 0$ では $0$ で、$u = 0$ では $\mathbb{P}(F(X) \le 0) \le \mathbb{P}(F(X) < \varepsilon) = \varepsilon$（任意の $\varepsilon \in (0,1)$）から $0$ です。これは $\mathrm{U}(0,1)$ の分布関数で、分布関数は分布を決めるので（<Ref to="mathematics/probability/random-variables#prop-distribution-is-measure" />）、$F(X) \sim \mathrm{U}(0,1)$ です。
</Proof>

1 は、**任意の**分布関数に対して、その分布をもつ確率変数が一様乱数 1 個から作れることを述べています。2 は逆向きの道具で、標本が指定した連続分布に従うかどうかの検定（$F(X_i)$ が一様に分布するかを調べる）に使います。2 で連続性を落とすと成り立ちません。$X$ が確率 $1/2$ ずつで $0, 1$ を取るとき $F(X)$ は $1/2$ と $1$ しか取らず、一様ではありません。

<Example id="ex-inverse-examples" title="指数分布・Cauchy 分布・離散分布">
**指数分布。** $F(x) = 1 - e^{-\lambda x}$（$x \ge 0$）は $[0, \infty)$ で連続・狭義単調なので、$F^{-}(u) = -\ln(1 - u)/\lambda$ です。$X = -\ln(1 - U)/\lambda$ は率 $\lambda$ の指数分布に従います。

**Cauchy 分布。** 密度 $1/(\pi(1 + x^2))$ の分布関数は $F(x) = \frac12 + \frac1\pi\arctan x$ で、$F^{-}(u) = \tan(\pi(u - \frac12))$ です。

**離散分布。** 値 $x_1 < x_2 < \cdots < x_n$ を確率 $p_1, \ldots, p_n$ で取る分布では、$P_k = p_1 + \cdots + p_k$（$P_0 = 0$）として $F$ は $x_k$ で $P_{k-1}$ から $P_k$ へ跳ぶ階段関数です。$P_{k-1} < u \le P_k$ のとき、$F(x) \ge u$ となる最小の $x$ は $x_k$ なので $F^{-}(u) = x_k$ です。つまり「$U$ が入る区間 $(P_{k-1}, P_k]$ の番号 $k$ を探して $x_k$ を返す」という手続きになります。累積和 $P_k$ の表を二分探索すれば 1 個あたり $O(\log n)$ で、§6 の別名法はこれを $O(1)$ にします。
</Example>

<Proposition id="prop-float-uniform" title="倍精度の一様乱数で届く裾">
$U$ を倍精度の一様乱数（<Ref to="def-float-uniform" />）とする。

1. $1 - U$ は $\{k\,2^{-53} : k = 1, \ldots, 2^{53}\}$ に値を取り、$0$ にならない。$X = -\ln(1 - U)$ の取る値は $[0,\ 53\ln 2]$ に含まれ、最大値 $53\ln 2 = 36.7368\cdots$ は $U = 1 - 2^{-53}$ のとき取られる。一方 $-\ln U$ は $U = 0$（確率 $2^{-53}$）で定義されない。
2. 標準正規分布の分布関数を $\Phi$ とする。$U \ne 0$ のとき $X = \Phi^{-1}(U)$ の取る値は $[-z^*, z^*]$ に含まれる。ここで $z^* > 0$ は $\Phi(-z^*) = 2^{-53}$ の解で、$z^* = 8.2095\cdots$ である。
3. したがって、これらの方法で作った標本では、事象 $\{X > 53\ln 2\}$（指数分布）、$\{|X| > z^*\}$（正規分布。$U = 0$ の場合を除く）は決して起きない。真の分布でのこれらの確率は、それぞれ $2^{-53}$、$2^{-52}$ である。
</Proposition>

一様乱数が $2^{-53}$ 刻みの値しか取らないと、その値を関数に通して作る標本にも、出せる最大値に上限ができます。上の命題は、その上限を指数分布と正規分布について具体的な数で示すものです。真の分布では、上限より大きな値もごくまれに出るので、そのまれな事象を調べる計算に影響します。

<Proof of="prop-float-uniform">
**1.** $U = k\,2^{-53}$（$0 \le k \le 2^{53} - 1$）なら $1 - U = (2^{53} - k)\,2^{-53}$ で、$2^{53} - k$ は $1$ から $2^{53}$ の整数です。よって $2^{-53} \le 1 - U \le 1$ で、$-\ln$ は単調減少なので $0 \le -\ln(1 - U) \le -\ln 2^{-53} = 53\ln 2$ です。等号は $k = 2^{53} - 1$ のときです。

**2.** $U \ne 0$ なら $2^{-53} \le U \le 1 - 2^{-53}$ です。$\Phi^{-1}$ は単調増加なので $\Phi^{-1}(2^{-53}) \le X \le \Phi^{-1}(1 - 2^{-53})$ です。正規分布の対称性 $\Phi(-z) = 1 - \Phi(z)$ から、左端は $-z^*$、右端は $z^*$ です。$z^*$ の数値は方程式 $\Phi(-z) = 2^{-53}$ を任意精度で解いた値です（後のコード）。

**3.** 率 $1$ の指数分布では $\mathbb{P}(X > 53\ln2) = e^{-53\ln2} = 2^{-53}$、標準正規分布では $\mathbb{P}(|X| > z^*) = 2\Phi(-z^*) = 2^{-52}$ です。
</Proof>

この命題から 2 つの実務上の規則が出ます。第一に、対数の引数には $U$ ではなく $1 - U$ を使います（NumPy なら `-np.log1p(-u)`）。$1 - U$ の計算は binary64 で誤差なく行われます（引く 2 数がどちらも $2^{-53}$ の整数倍で、結果も $2^{-53}$ の $2^{53}$ 以下の整数倍だからです）。第二に、$10^{-16}$ より小さい確率の事象を、逆関数法で作った標本から調べることはできません。そのような裾を調べるときは、次章の[重点サンプリング](/computer-science/stochastic-computation/monte-carlo-integration#def-importance-sampling)で裾に標本を集めます。

## 4. 棄却法

分布関数の逆関数が簡単に計算できない分布では、「作りやすい分布から候補を出し、ある確率で捨てる」方法を使います。

<Definition id="def-rejection" title="棄却法">
$f : \mathbb{R}^d \to [0, \infty)$ を $0 < \int f < \infty$ を満たすボレル可測関数（**目標**。正規化されていなくてよい）、$g$ を $\mathbb{R}^d$ 上の確率密度（**提案密度**）、$M > 0$ を定数（**包絡定数**）とする。$\mathbb{R}^{d+1}$ 値の確率変数の列 $(Y_i, U_i)$（$i = 1, 2, \ldots$）は独立同分布で、各々が密度 $g(y)\mathbf{1}_{(0,1)}(u)$ をもつとする（$Y_i$ は密度 $g$ に従い、$U_i \sim \mathrm{U}(0,1)$ は $Y_i$ と独立）。事象
$$
A_i = \{U_i\,M g(Y_i) \le f(Y_i)\}
$$
が起きたとき $i$ 回目の候補を**採択**するという。最初に採択が起きる回 $\tau = \min\{i : A_i \text{ が起きる}\}$ の候補 $X = Y_\tau$ を出力する手続きを**棄却法**という。$\mathbb{P}(A_1)$ を**採択率**という。
</Definition>

$g(Y_i) > 0$ のとき、採択の条件は $U_i \le f(Y_i)/(Mg(Y_i))$ です。割り算を避けて積の形で書いたのは、$g = 0$ の点での扱いを決めておくためです。

<Theorem id="thm-rejection-sampling" title="棄却法の正しさ">
<Ref to="def-rejection" /> の設定で、$h = \min(f, Mg)$ と置く。$\int h > 0$ とする。

1. 採択率は $p = \frac1M\int h$ で、$\tau$ は成功確率 $p$ の幾何分布に従う。特に $\mathbb{P}(\tau < \infty) = 1$、$\mathbb{E}[\tau] = 1/p$ である。
2. 出力 $X = Y_\tau$ は密度 $h/\int h$ をもち、$\tau$ と独立である。
3. **包絡条件** $f(y) \le Mg(y)$（すべての $y$）が成り立つとき、$X$ の密度は $f/\int f$ で、採択率は $\int f/M$ である。$f$ が確率密度なら採択率は $1/M$、試行回数の平均は $M$ である。
4. 包絡条件が破れていて、$E = \{f > Mg\}$ と $E^c \cap \{f > 0\}$ がどちらも正のルベーグ測度をもつならば、$X$ の密度 $h/\int h$ は $f/\int f$ と一致しない。
</Theorem>

定理の 1〜3 は、「候補が採択される確率」を候補の位置ごとに計算するだけです。位置 $y$ で採択される確率は $\min(1, f/(Mg))$ なので、採択された候補の密度は $g$ にこれを掛けた $h/M$ に比例し、包絡条件のもとでは $f$ に比例します。4 は、包絡条件が破れると $h$ が $f$ に比例しなくなることを、背理法で示すものです。

<Proof of="thm-rejection-sampling">
**1 回の試行。** ボレル集合 $B \subseteq \mathbb{R}^d$ について $\mathbb{P}(Y_1 \in B,\ A_1)$ を求めます。$(Y_1, U_1)$ の密度の定義と Tonelli の定理（<Ref to="mathematics/real-analysis/product-measures-fubini#thm-tonelli" />）から
$$
\mathbb{P}(Y_1 \in B,\ A_1) = \int_B g(y)\Bigl(\int_0^1 \mathbf{1}\{u\,Mg(y) \le f(y)\}\,du\Bigr)dy
$$
です。内側の積分は、$g(y) > 0$ なら $\min(1, f(y)/(Mg(y)))$、$g(y) = 0$ なら（$f \ge 0$ なので条件が常に成り立ち）$1$ です。どちらの場合も、$g(y)$ を掛けると $\min(g(y), f(y)/M) = h(y)/M$ になります（$g(y) = 0$ のときは両辺とも $0$）。よって
$$
\mathbb{P}(Y_1 \in B,\ A_1) = \frac1M\int_B h(y)\,dy.
$$
$B = \mathbb{R}^d$ として $p = \mathbb{P}(A_1) = \frac1M\int h > 0$ です。

**1 と 2。** 対 $(Y_i, U_i)$ は独立同分布なので、事象 $A_1^c, \ldots, A_{k-1}^c, \{Y_k \in B\} \cap A_k$ は独立で、
$$
\mathbb{P}(\tau = k,\ X \in B) = \mathbb{P}(A_1^c)\cdots\mathbb{P}(A_{k-1}^c)\,\mathbb{P}(Y_k \in B,\ A_k) = (1-p)^{k-1}\cdot\frac1M\int_B h
$$
です。$B = \mathbb{R}^d$ とすると $\mathbb{P}(\tau = k) = (1-p)^{k-1}p$ で、これは幾何分布です（<Ref to="mathematics/hs-probability/distributions-and-inference#def-geometric-distribution" />）。和が $1$ であることと平均 $1/p$ は、$p < 1$ のとき <Ref to="mathematics/hs-probability/distributions-and-inference#thm-geometric-distribution" /> です（$p = 1$ のときは確率 $1$ で $\tau = 1$ なので、どちらも直接分かります）。$k$ について和を取ると、$\sum_{k\ge1}(1-p)^{k-1} = 1/p$ から
$$
\mathbb{P}(X \in B) = \frac{1}{pM}\int_B h = \frac{\int_B h}{\int h}
$$
で、$X$ の密度は $h/\int h$ です。さらに $\mathbb{P}(\tau = k,\ X \in B) = \mathbb{P}(\tau = k)\,\mathbb{P}(X \in B)$ なので、$\tau$ と $X$ は独立です。

**3.** 包絡条件のもとでは $h = f$ なので、1・2 から従います。

**4.** 2 つの密度が一致する、すなわちほとんどすべての $y$ で $h(y)/\int h = f(y)/\int f$ だと仮定して矛盾を導きます。$E^c$ の上では $h = f$ なので、$E^c \cap \{f > 0\}$ のほとんどすべての点で $1/\int h = 1/\int f$ です。この集合は正の測度をもつので、$\int h = \int f$ です。$h \le f$ と合わせると、$f - h \ge 0$ の積分が $0$ なので、ほとんどいたるところ $h = f$ です。ところが $E$ の上では $h = Mg < f$ で、$m(E) > 0$ なので矛盾です。
</Proof>

3 が棄却法の主張です。$f$ の正規化定数 $\int f$ は、採択の判定にも出力にも現れません。Bayes 統計の[事後分布](/computer-science/math-for-ml/bayesian-statistics#def-likelihood)や統計力学の Boltzmann 分布のように、密度が定数倍を除いてしか分からない場合に使えるのはこのためです。採択率 $\int f/M$ は $M$ が小さいほど高いので、包絡条件を満たす範囲で $M$ をできるだけ小さく、つまり $g$ の形を $f$ に近く選びます。

4 は、包絡条件の確認を怠ったときに何が起きるかを述べています。$f > Mg$ となる領域では採択確率が $1$ で頭打ちになり、その領域の密度が本来より低く出ます。出力は何の警告もなく別の分布に従うので、$\sup f/g$ を解析的に求めるか、少なくとも $f(Y_i) > Mg(Y_i)$ となる候補が現れたら計算を止めるようにします。なお、4 の仮定が要るのは、$f$ が至るところ $Mg$ のちょうど定数倍であるような場合には $\min(f, Mg)$ が $f$ に比例して、出力が偶然正しくなるからです。

<Example id="ex-half-normal" title="半正規分布を指数分布で包む">
目標を半正規分布の密度 $f(x) = \sqrt{2/\pi}\,e^{-x^2/2}$（$x \ge 0$）、提案を率 $1$ の指数分布 $g(x) = e^{-x}$（$x \ge 0$）とします。比は
$$
\frac{f(x)}{g(x)} = \sqrt{\frac2\pi}\,e^{x - x^2/2} = \sqrt{\frac2\pi}\,e^{1/2}\,e^{-(x-1)^2/2}
$$
で、$x = 1$ で最大値 $M = \sqrt{2e/\pi} \approx 1.3155$ を取ります。この $M$ で包絡条件が成り立ち、採択の条件は $U \le f(Y)/(Mg(Y)) = e^{-(Y-1)^2/2}$ です。採択率は $1/M = \sqrt{\pi/(2e)} \approx 0.7602$ です。得られた $X$ に、独立な確率 $1/2$ の符号を付ければ標準正規乱数になります。

逆に、提案の裾が目標より軽いと包絡定数が存在しません。目標を率 $1$ の指数分布、提案を半正規分布にすると、$f/g = \sqrt{\pi/2}\,e^{x^2/2 - x} \to \infty$ で、どんな $M$ でも包絡条件が破れます。提案分布は、目標より重い裾をもつものを選びます。
</Example>

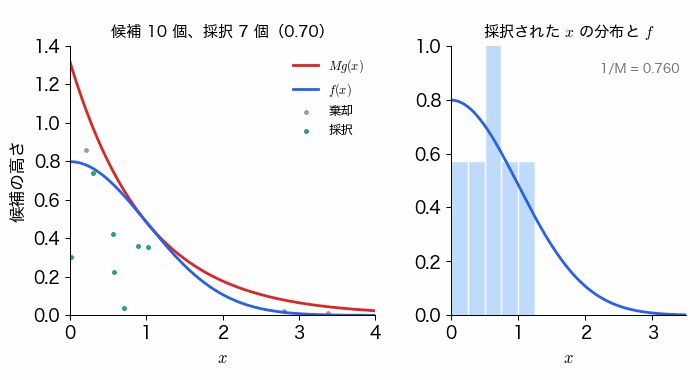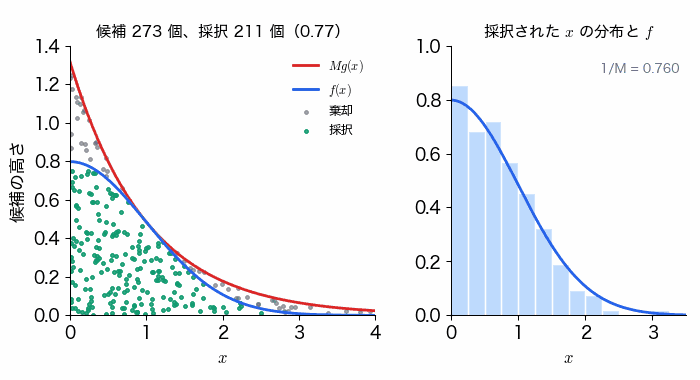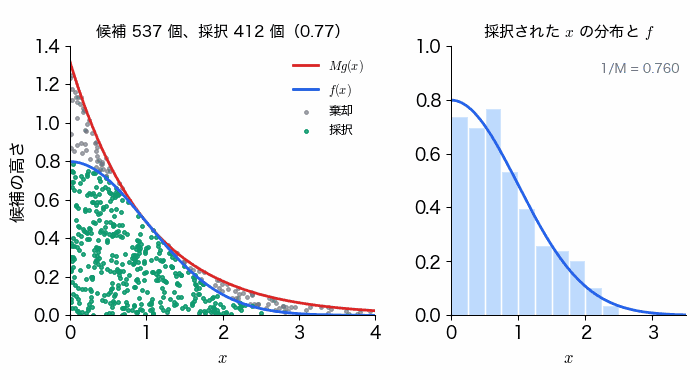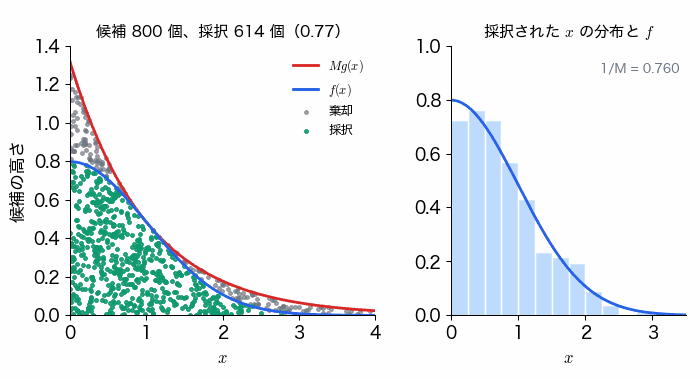
上の半正規分布の例を動かしたのが次の図です。候補 $Y$ ごとに、高さ $U\,Mg(Y)$ の点を打ちます。$f$ の曲線より下に入った点が採択で、採択された $x$ の分布が $f$ に近づく様子と、採択率が $1/M \approx 0.76$ に落ち着く様子を見てください。

<Figure caption="半正規分布を指数分布で包む棄却法。左は候補の点（緑が採択、灰色が棄却）、右は採択された x のヒストグラムと目標の密度 f。">
<img src="/figures/rejection-sampling-halfnormal.gif" alt="指数分布の包絡 Mg の下に候補の点が一様に打たれていき、半正規分布の密度 f の下に入った点だけが採択される。採択された x のヒストグラムが f に近づき、採択率は 0.76 付近になる。" loading="lazy" />
</Figure>

次のコードは、逆関数法と棄却法で作った標本について、経験分布関数 $F_N$ と理論の分布関数 $F$ の最大差（Kolmogorov–Smirnov 統計量）$D_N = \sup_x|F_N(x) - F(x)|$ を計算します。標本が正しく $F$ に従うなら、$D_N$ の典型的な大きさは $1/\sqrt N$ の程度です（<Ref to="rem-ks" />）。

```python
# Python 3.9.6, NumPy 2.0.2, SciPy 1.13.1
import numpy as np
from scipy.special import erf

rng = np.random.default_rng(20261008)
N = 10**5

def ks(x, F):                       # sup |F_N - F| を整列した標本から厳密に
    x = np.sort(x)
    n = len(x)
    Fx = F(x)
    i = np.arange(1, n + 1)
    return max(np.max(i / n - Fx), np.max(Fx - (i - 1) / n))

u = rng.random(N)
x_exp = -np.log1p(-u)                               # 指数分布: F^-(u) = -ln(1-u)
x_cau = np.tan(np.pi * (rng.random(N) - 0.5))       # Cauchy 分布
M = np.sqrt(2 * np.e / np.pi)                       # 半正規分布を Exp(1) で包む
y = -np.log1p(-rng.random(2 * N))
acc = rng.random(2 * N) <= np.exp(-0.5 * (y - 1.0) ** 2)
x_hn = y[acc][:N]

print(f"1/sqrt(N) = {1/np.sqrt(N):.5f}")
print(f"指数分布（逆関数法）   D_N = {ks(x_exp, lambda t: 1 - np.exp(-t)):.5f}")
print(f"Cauchy 分布（逆関数法） D_N = {ks(x_cau, lambda t: 0.5 + np.arctan(t)/np.pi):.5f}")
print(f"半正規分布（棄却法）   D_N = {ks(x_hn, lambda t: erf(t/np.sqrt(2))):.5f}  (N = {len(x_hn)})")
p_hat = acc.mean()
se = np.sqrt(p_hat * (1 - p_hat) / len(acc))
print(f"採択率 = {p_hat:.5f} ± {se:.5f},  1/M = {1/M:.5f},  差 = {(p_hat - 1/M)/se:+.2f} 標準誤差")
```

```text
1/sqrt(N) = 0.00316
指数分布（逆関数法）   D_N = 0.00181
Cauchy 分布（逆関数法） D_N = 0.00369
半正規分布（棄却法）   D_N = 0.00199  (N = 100000)
採択率 = 0.76141 ± 0.00095,  1/M = 0.76017,  差 = +1.30 標準誤差
```

3 つの標本とも $D_N$ は $1/\sqrt N \approx 0.0032$ の 0.6 倍から 1.2 倍の範囲にあり、採択率の標本値は理論値 $1/M$ から標準誤差の 1.3 倍の位置にあります。どちらも定理が予言する挙動と矛盾しません。

<Remark id="rem-ks" title="Kolmogorov–Smirnov 統計量の大きさ">
$F$ が連続のとき、$\sqrt N D_N$ は $N \to \infty$ で $F$ によらない分布（Kolmogorov 分布。平均は約 $0.87$、$1.36$ を超える確率が約 $5\%$）に分布収束します。$F$ によらないことは <Ref to="thm-inverse-transform" /> の 2 から分かります（$F(X_i)$ が一様分布に従い、$D_N$ は $F(X_i)$ の経験分布関数と恒等関数の最大差に等しい）。極限分布の導出は Brown 橋の理論を使うので、ここでは扱いません。van der Vaart の本の第 19 章を参照してください。
</Remark>

## 5. 変数変換による生成

<Definition id="def-transformation" title="変数変換による生成・混合分布からの生成">
独立な一様乱数（または既に作れる分布の乱数）$W_1, \ldots, W_k$ の関数 $X = \phi(W_1, \ldots, W_k)$ として目標の分布の標本を作ることを、**変数変換による生成**という。確率密度 $p_1, \ldots, p_n$ と重み $w_k \ge 0$（$\sum_k w_k = 1$）に対して、密度 $\sum_k w_kp_k$ の分布を**混合分布**という。番号 $K$ を $\mathbb{P}(K = k) = w_k$ で選び、$K$ と独立に用意した $X_k \sim p_k$ のうち $X_K$ を出力することを、**混合分布からの生成**という。
</Definition>

混合分布からの生成が正しいことは、$K$ の値で場合を分ければ分かります。$K$ と $(X_1, \ldots, X_n)$ が独立なので、$\mathbb{P}(X_K \in B) = \sum_k \mathbb{P}(K = k)\,\mathbb{P}(X_k \in B) = \sum_k w_k\int_B p_k = \int_B \sum_k w_kp_k$ です。実際の計算では、選ばれた番号の $X_K$ だけを作れば足ります。

### 5.1. 正規乱数

標準正規分布 $N(0,1)$ の密度を $\varphi(t) = (2\pi)^{-1/2}e^{-t^2/2}$ と書きます。Gauss 積分（<Ref to="mathematics/calculus/improper-parametric-integrals#thm-gauss-integral" />）で $x = t/\sqrt2$ と置換すると $\int_{-\infty}^{\infty}e^{-t^2/2}dt = \sqrt{2\pi}$ なので、$\int\varphi = 1$ です。

<Proposition id="prop-box-muller" title="Box–Muller 法と極座標法">
1. $U_1, U_2$ を独立な $\mathrm{U}(0,1)$ の確率変数とする。このとき
   $$
   X = \sqrt{-2\ln U_1}\,\cos(2\pi U_2), \qquad Y = \sqrt{-2\ln U_1}\,\sin(2\pi U_2)
   $$
   は独立で、どちらも標準正規分布に従う。
2. $(V_1, V_2)$ を穴あき円板 $D = \{0 < v_1^2 + v_2^2 < 1\}$ 上の一様分布に従う確率変数とし、$S = V_1^2 + V_2^2$ と置く。このとき
   $$
   X = V_1\sqrt{\frac{-2\ln S}{S}}, \qquad Y = V_2\sqrt{\frac{-2\ln S}{S}}
   $$
   は独立で、どちらも標準正規分布に従う。$(V_1, V_2)$ を正方形 $(-1,1)^2$ 上の一様分布からの棄却法で作るとき、採択率は $\pi/4$ である。
</Proposition>

1 の証明の方針です。$(U_1, U_2)$ を、半径 $r = \sqrt{-2\ln U_1}$ と角度 $2\pi U_2$ の平面上の点に写します。変数変換公式では、元の一様な密度に「ヤコビ行列式（面積がどれだけ伸び縮みするか）」を掛けたものが、写した先の密度になります。この計算で、先の密度がちょうど $\frac{1}{2\pi}e^{-(x^2+y^2)/2}$、つまり 2 つの標準正規分布の密度の積になることを確かめます。

<Proof of="prop-box-muller">
**1.** $Q = (0,1)^2$ と置きます。<Ref to="lem-joint-density" /> から $(U_1, U_2)$ は $Q$ 上の一様分布に従います。写像 $\Phi : Q \to \mathbb{R}^2$ を
$$
\Phi(u_1, u_2) = (r\cos\theta,\ r\sin\theta), \qquad r = \sqrt{-2\ln u_1} > 0,\quad \theta = 2\pi u_2 \in (0, 2\pi)
$$
で定めます。$\Phi$ は $C^1$ 級です。$r$ が $u_1 = e^{-r^2/2}$ を、$(\cos\theta, \sin\theta)$ と $\theta \in (0, 2\pi)$ が $u_2$ を決めるので単射で、像は $V = \mathbb{R}^2 \setminus \{(x, 0) : x \ge 0\}$ です。ヤコビ行列式を計算します。$r' = dr/du_1$ と書くと
$$
\det D\Phi = \begin{vmatrix} r'\cos\theta & -2\pi r\sin\theta \\ r'\sin\theta & 2\pi r\cos\theta \end{vmatrix} = 2\pi rr'
$$
で、$rr' = \frac{d}{du_1}\bigl(\tfrac12r^2\bigr) = \frac{d}{du_1}(-\ln u_1) = -1/u_1$ なので、$|\det D\Phi(u)| = 2\pi/u_1 \ne 0$ です。単射で局所的に可逆な $C^1$ 写像は像の上への微分同相なので（<Ref to="mathematics/real-analysis/change-of-variables-rd#lem-global-inverse" />）、変数変換公式（<Ref to="mathematics/real-analysis/change-of-variables-rd#thm-change-of-variables" /> の 2）が使えます。ボレル集合 $B \subseteq \mathbb{R}^2$ に対して、$V$ 上の関数 $\psi(z) = \mathbf{1}_B(z)\,\frac{1}{2\pi}e^{-|z|^2/2}$ を取ると、$\psi(\Phi(u)) = \mathbf{1}_B(\Phi(u))\,\frac{u_1}{2\pi}$ なので
$$
\int_V \psi(z)\,dz = \int_Q \mathbf{1}_B(\Phi(u))\,\frac{u_1}{2\pi}\cdot\frac{2\pi}{u_1}\,du = \int_Q \mathbf{1}_B(\Phi(u))\,du = \mathbb{P}\bigl((X, Y) \in B\bigr)
$$
です。$\mathbb{R}^2 \setminus V$ は半直線でルベーグ測度 $0$ なので、左辺は $\int_B \varphi(x)\varphi(y)\,dx\,dy$ に等しくなります。したがって $(X, Y)$ は密度 $\varphi(x)\varphi(y)$ をもちます。

$B = B_1 \times B_2$ とすると、Tonelli の定理から $\mathbb{P}(X \in B_1, Y \in B_2) = \int_{B_1}\varphi\int_{B_2}\varphi$ です。$B_2 = \mathbb{R}$ として $\mathbb{P}(X \in B_1) = \int_{B_1}\varphi$、同様に $\mathbb{P}(Y \in B_2) = \int_{B_2}\varphi$ なので、$X, Y$ は標準正規分布に従い、$\mathbb{P}(X \in B_1, Y \in B_2) = \mathbb{P}(X \in B_1)\mathbb{P}(Y \in B_2)$ から独立です。

**2.** 写像 $\Psi : Q \to \mathbb{R}^2$、$\Psi(s, t) = \sqrt s\,(\cos2\pi t, \sin2\pi t)$ を考えます。1 と同じ理由で単射で、像は $D' = D \setminus \{(x, 0) : x > 0\}$、ヤコビ行列式は
$$
\det D\Psi = \begin{vmatrix} \frac{1}{2\sqrt s}\cos2\pi t & -2\pi\sqrt s\sin2\pi t \\ \frac{1}{2\sqrt s}\sin2\pi t & 2\pi\sqrt s\cos2\pi t \end{vmatrix} = \pi
$$
です。よって $\Psi : Q \to D'$ は微分同相で、ボレル集合 $C \subseteq Q$ について $m(\Psi(C)) = \pi\,m(C)$ です（<Ref to="mathematics/real-analysis/change-of-variables-rd#thm-change-of-variables" /> の 1）。$(V_1, V_2)$ は確率 $1$ で $D'$ に属するので、$(S, T) = \Psi^{-1}(V_1, V_2)$ が確率 $1$ で定まり、
$$
\mathbb{P}\bigl((S, T) \in C\bigr) = \mathbb{P}\bigl((V_1, V_2) \in \Psi(C)\bigr) = \frac{m(\Psi(C))}{\pi} = m(C)
$$
です。つまり $(S, T)$ は $Q$ 上の一様分布に従い、1 の最後の議論と同じく $S, T$ は独立な $\mathrm{U}(0,1)$ の確率変数です。$\Psi$ の定義から $S = V_1^2 + V_2^2$、$V_1/\sqrt S = \cos2\pi T$、$V_2/\sqrt S = \sin2\pi T$ なので、
$$
X = \sqrt{-2\ln S}\,\cos(2\pi T), \qquad Y = \sqrt{-2\ln S}\,\sin(2\pi T)
$$
となり、1 から結論が従います。

採択率は、<Ref to="thm-rejection-sampling" /> の 3 を $f = \mathbf{1}_D$、$g = \frac14\mathbf{1}_{(-1,1)^2}$、$M = 4$ に使って $\int f/M = \pi/4$ です。採択の条件 $U \cdot 4g(Y) \le f(Y)$ は、$Y \in D$ なら常に成り立ち、$Y \notin D$ なら成り立たないので、補助の一様乱数は要りません。
</Proof>

極座標法（Marsaglia）は三角関数を使わない代わりに、候補の $1 - \pi/4 \approx 21\%$ を捨てます。どちらの方法でも、$U_1$（または $S$）に倍精度の一様乱数を使うときは $\ln 0$ を避けるために $1 - U$ を使い、そのとき動径 $\sqrt{-2\ln U_1}$ の最大値は $\sqrt{2\cdot53\ln2} \approx 8.57$ です（<Ref to="prop-float-uniform" /> と同じ計算）。

<Proposition id="prop-gaussian-vector-sampling" title="多次元正規分布からの生成">
$\mu \in \mathbb{R}^d$、$\Sigma$ を $d$ 次の実対称半正定値行列とする。

1. $r \ge 1$、$L$ を $LL^{\mathsf{T}} = \Sigma$ を満たす $d \times r$ 行列、$Z = (Z_1, \ldots, Z_r)$ を独立な標準正規変数の列とすると、$\mu + LZ \sim N(\mu, \Sigma)$ である。
2. $\Sigma$ が正定値なら、対角成分が正の下三角行列 $L$（Cholesky 因子）で $LL^{\mathsf{T}} = \Sigma$ となるものがある。
3. $\Sigma$ の階数が $r \ge 1$ のとき、正の固有値 $\lambda_1, \ldots, \lambda_r$ と対応する正規直交な固有ベクトル $\boldsymbol{p}_1, \ldots, \boldsymbol{p}_r$ から作った $d \times r$ 行列 $L = (\sqrt{\lambda_1}\boldsymbol{p}_1\ \cdots\ \sqrt{\lambda_r}\boldsymbol{p}_r)$ は $LL^{\mathsf{T}} = \Sigma$ を満たす。
</Proposition>

<Proof of="prop-gaussian-vector-sampling">
**1.** $Z$ の特性関数は $e^{-|t|^2/2}$ です（<Ref to="mathematics/probability/characteristic-functions-gaussian#lem-gauss-cf" />）。これは $N(0, I_r)$ の特性関数（<Ref to="mathematics/probability/characteristic-functions-gaussian#thm-gaussian-structure" /> の 1）に等しいので、特性関数の一意性（<Ref to="mathematics/probability/characteristic-functions-gaussian#thm-uniqueness" /> の 1）から $Z \sim N(0, I_r)$ です。同じ定理の 4 から $\mu + LZ \sim N(\mu, LI_rL^{\mathsf{T}}) = N(\mu, \Sigma)$ です。

**2.** <Ref to="mathematics/numerical-linear-algebra/cholesky-and-sparse-direct#thm-cholesky-existence" /> から、対角成分が正の上三角行列 $R$ で $\Sigma = R^{\mathsf{T}}R$ となるものがあります。$L = R^{\mathsf{T}}$ と置けばよいです。

**3.** <Ref to="mathematics/linear-algebra/spectral-theorem#cor-real-symmetric" /> から、正規直交基底をなす固有ベクトル $\boldsymbol{p}_1, \ldots, \boldsymbol{p}_d$ と固有値 $\lambda_i$ があって $\Sigma = \sum_{i=1}^d \lambda_i\boldsymbol{p}_i\boldsymbol{p}_i^{\mathsf{T}}$ です。半正定値性から $\lambda_i = \langle\boldsymbol{p}_i, \Sigma\boldsymbol{p}_i\rangle \ge 0$ で、階数が $r$ なので正の固有値はちょうど $r$ 個です。それらを $\lambda_1, \ldots, \lambda_r$ と並べると、$LL^{\mathsf{T}} = \sum_{i=1}^r \lambda_i\boldsymbol{p}_i\boldsymbol{p}_i^{\mathsf{T}} = \Sigma$ です（残りの項は $\lambda_i = 0$）。
</Proof>

<Example id="ex-correlated-normal" title="相関を指定した正規乱数">
分散 $1$、相関係数 $\rho$（$|\rho| < 1$）の 2 変量正規分布では
$$
\Sigma = \begin{pmatrix} 1 & \rho \\ \rho & 1 \end{pmatrix} = LL^{\mathsf{T}}, \qquad L = \begin{pmatrix} 1 & 0 \\ \rho & \sqrt{1 - \rho^2} \end{pmatrix}
$$
なので、$X_1 = Z_1$、$X_2 = \rho Z_1 + \sqrt{1 - \rho^2}\,Z_2$ とします。$\rho = \pm1$ では $\Sigma$ が特異で Cholesky 分解は使えず、<Ref to="prop-gaussian-vector-sampling" /> の 3 から $L = (1, \pm1)^{\mathsf{T}}$、$X = (Z_1, \pm Z_1)$ です。相関行列が数値的に半正定値からわずかに外れている場合（推定した相関行列でよく起きます）は、Cholesky 分解が途中で負の数の平方根に出会って失敗するので、固有値分解して負の固有値を $0$ に切り上げてから 3 を使います。
</Example>

### 5.2. 球面上の一様分布

$S^{d-1} = \{x \in \mathbb{R}^d : |x| = 1\}$ 上の球面測度 $\sigma$（<Ref to="mathematics/real-analysis/change-of-variables-rd#def-sphere-measure" />）を全測度で割った確率測度を、**球面上の一様分布**といいます。$\sigma$ は直交変換で不変です（<Ref to="mathematics/real-analysis/change-of-variables-rd#prop-sigma-rotation" />）。

<Proposition id="prop-uniform-sphere" title="球面と球の上の一様分布">
1. $Z = (Z_1, \ldots, Z_d)$ を独立な標準正規変数の列とすると、$Z/|Z|$ は $S^{d-1}$ 上の一様分布に従う。
2. 立方体 $(-1,1)^d$ 上の一様分布を提案とする棄却法で単位球 $\{|x| < 1\}$ 上の一様分布を作るとき、採択率は
   $$
   a_d = \frac{\pi^{d/2}}{2^d\,\Gamma(d/2 + 1)}
   $$
   で、$a_{d+2}/a_d = \pi/(2d + 4)$ を満たす。特に $d \to \infty$ で $a_d \to 0$ である。
</Proposition>

<Proof of="prop-uniform-sphere">
**1.** <Ref to="lem-joint-density" /> から $Z$ は密度 $(2\pi)^{-d/2}e^{-|x|^2/2}$ をもち、$\mathbb{P}(Z = 0) = 0$ です。ボレル集合 $A \subseteq S^{d-1}$ を取り、$f(x) = \mathbf{1}_A(x/|x|)\,(2\pi)^{-d/2}e^{-|x|^2/2}$（$x \ne 0$）、$f(0) = 0$ と置くと、$r > 0$、$\omega \in S^{d-1}$ について $f(r\omega) = \mathbf{1}_A(\omega)(2\pi)^{-d/2}e^{-r^2/2}$ です。極座標分解（<Ref to="mathematics/real-analysis/change-of-variables-rd#thm-polar" />）から
$$
\mathbb{P}\Bigl(\frac{Z}{|Z|} \in A\Bigr) = \int_{\mathbb{R}^d} f(x)\,dx = \int_0^\infty\Bigl(\int_{S^{d-1}}\mathbf{1}_A(\omega)\,d\sigma(\omega)\Bigr)\frac{e^{-r^2/2}}{(2\pi)^{d/2}}\,r^{d-1}\,dr = \sigma(A)\,\kappa_d
$$
です。ここで $\kappa_d = \int_0^\infty (2\pi)^{-d/2}e^{-r^2/2}r^{d-1}dr$ は $A$ によらない定数です。$A = S^{d-1}$ とすると左辺は $1$ なので $\kappa_d = 1/\sigma(S^{d-1})$ で、$\mathbb{P}(Z/|Z| \in A) = \sigma(A)/\sigma(S^{d-1})$ です。

**2.** <Ref to="thm-rejection-sampling" /> の 3 を $f = \mathbf{1}_{\{|x| < 1\}}$、$g = 2^{-d}\mathbf{1}_{(-1,1)^d}$、$M = 2^d$ に使うと、出力は球の上の一様分布に従い、採択率は $\int f/M = m(\{|x| < 1\})/2^d$ です。球の体積（<Ref to="mathematics/real-analysis/change-of-variables-rd#thm-ball-volume" />）を代入して $a_d$ の式を得ます。ガンマ関数の関数等式 $\Gamma(s + 1) = s\Gamma(s)$（<Ref to="mathematics/calculus/improper-parametric-integrals#thm-gamma-functional" />）から
$$
\frac{a_{d+2}}{a_d} = \frac{\pi}{4}\cdot\frac{\Gamma(d/2 + 1)}{\Gamma(d/2 + 2)} = \frac{\pi}{4(d/2 + 1)} = \frac{\pi}{2d + 4}
$$
です。$d \ge 1$ で右辺は $\pi/6 < 1$ 以下なので、$a_d \le \max(a_1, a_2)\,(\pi/6)^{\lfloor (d-1)/2\rfloor} \to 0$ です。
</Proof>

$a_2 = 0.785$、$a_3 = 0.524$、$a_5 = 0.164$、$a_{10} = 2.5\times10^{-3}$、$a_{20} = 2.5\times10^{-8}$ です。10 次元で候補の 99.75% が捨てられ、20 次元では実用になりません。高次元の球の上の一様分布は、1 の方法で方向を作り、動径を $R = U^{1/d}$（$\mathbb{P}(R \le r) = r^d$）として $R\,Z/|Z|$ で作ります。「高次元では単純な包絡が効かなくなる」というこの現象は、棄却法に限らず、次章の重点サンプリングにも、Markov 連鎖 Monte Carlo の提案の設計にも現れます。

### 5.3. 一様乱数の比による方法

<Proposition id="prop-ratio-of-uniforms" title="一様乱数の比">
$f : \mathbb{R} \to [0, \infty)$ をボレル可測で $0 < c = \int f < \infty$ とし、
$$
A = \bigl\{(u, v) \in \mathbb{R}^2 : 0 < u \le \sqrt{f(v/u)}\bigr\}
$$
と置く。このとき $m(A) = c/2$ であり、$(U, V)$ が $A$ 上の一様分布に従うなら、$V/U$ は密度 $f/c$ をもつ。
</Proposition>

<Proof of="prop-ratio-of-uniforms">
$W = (0, \infty) \times \mathbb{R}$ と置き、$\Phi : W \to W$、$\Phi(u, x) = (u, ux)$ を考えます。逆写像 $(u, v) \mapsto (u, v/u)$ をもつ $C^1$ 微分同相で、$\det D\Phi(u, x) = \begin{vmatrix} 1 & 0 \\ x & u\end{vmatrix} = u > 0$ です。$A \subseteq W$ で、$\mathbf{1}_A(\Phi(u, x)) = \mathbf{1}\{u \le \sqrt{f(x)}\}$ です。ボレル集合 $B \subseteq \mathbb{R}$ について、変数変換公式（<Ref to="mathematics/real-analysis/change-of-variables-rd#thm-change-of-variables" /> の 2）と Tonelli の定理から
$$
\int_W \mathbf{1}_A(u, v)\,\mathbf{1}_B(v/u)\,du\,dv = \int_W \mathbf{1}\{u \le \sqrt{f(x)}\}\,\mathbf{1}_B(x)\,u\,du\,dx = \int_B\Bigl(\int_0^{\sqrt{f(x)}} u\,du\Bigr)dx = \frac12\int_B f(x)\,dx
$$
です。$B = \mathbb{R}$ として $m(A) = c/2$ です。$(U, V)$ の密度は $\mathbf{1}_A/m(A)$ なので、
$$
\mathbb{P}(V/U \in B) = \frac{2}{c}\int_W \mathbf{1}_A(u, v)\,\mathbf{1}_B(v/u)\,du\,dv = \frac1c\int_B f(x)\,dx
$$
です。
</Proof>

$A$ 上の一様分布は、$A$ を含む長方形からの棄却法で作ります。$f(x) = e^{-x^2/2}$ では $0 < u \le \sup\sqrt f = 1$、$|v| = u|x| \le |x|e^{-x^2/4} \le \sqrt{2/e}$（$|x| = \sqrt2$ で最大）なので、$A \subseteq (0, 1] \times [-\sqrt{2/e}, \sqrt{2/e}]$ です。採択率は面積の比 $\frac{\sqrt{2\pi}/2}{2\sqrt{2/e}} = \sqrt{\pi e}/4 \approx 0.731$ で、対数も三角関数も使わずに（採択の判定 $u^2 \le e^{-(v/u)^2/2}$ は多項式の不等式による前判定で大部分を済ませて）正規乱数が得られます。

次の例は、ここまでの道具を組み合わせた実用的な方法です。ガンマ分布の密度を、立方の形に変数変換すると正規分布の密度でちょうど上から覆える形になる、という事実に基づきます。

<Example id="ex-marsaglia-tsang" title="ガンマ分布の Marsaglia–Tsang 法">
形状母数 $\alpha \ge 1$ のガンマ分布（密度 $x^{\alpha-1}e^{-x}/\Gamma(\alpha)$、$x > 0$）は、変数変換と棄却法の組み合わせで作れます。$d = \alpha - \frac13$、$c = 1/\sqrt{9d}$ と置き、次を採択されるまで繰り返します。

1. $Z \sim N(0,1)$ を作り、$V = (1 + cZ)^3$ とする。$V \le 0$ ならやり直す。
2. $U \sim \mathrm{U}(0,1)$ を作り、$\ln U < \frac12Z^2 + d - dV + d\ln V$ なら $X = dV$ を出力する。

これが正しい理由を確かめます。$x = d(1 + cy)^3$（$y > -1/c$）と置換すると、$dx = 3dc(1 + cy)^2dy$ で
$$
x^{\alpha-1}e^{-x}\,dx \ \propto\ (1 + cy)^{3\alpha - 3}e^{-d(1+cy)^3}(1 + cy)^2\,dy = \exp\bigl(d\ln v - dv\bigr)\,dy, \qquad v = (1 + cy)^3
$$
です（$3\alpha - 1 = 3d$ を使いました）。したがって、$y$ が $f(y) = \exp(d\ln v - dv + d)$（$y > -1/c$。それ以外では $0$）に比例する密度をもてば、$d(1 + cy)^3$ はガンマ分布に従います。この $f$ を、提案 $g = \varphi$、包絡定数 $M = \sqrt{2\pi}$ の棄却法で作ります。包絡条件 $f(y) \le e^{-y^2/2}$ は $k(y) = d\ln v - dv + d + \frac12y^2 \le 0$ と同値です。$w = 1 + cy$ と置き、$9dc^2 = 1$ を使うと
$$
k'(y) = 3dc\Bigl(\frac1w - w^2\Bigr) + \frac{w - 1}{c} = \frac{1}{3cw}\bigl(1 - w^3 + 3w^2 - 3w\bigr) = \frac{(1 - w)^3}{3cw}
$$
なので、$k$ は $y < 0$ で増加、$y > 0$ で減少し、最大値は $k(0) = 0$ です。包絡条件が成り立つので、<Ref to="thm-rejection-sampling" /> の 3 から出力は正しく、採択の条件 $U \le f(Z)/(M\varphi(Z)) = e^{k(Z)}$ が手順 2 の不等式です。採択率は $\alpha = 1$ で約 $0.95$、$\alpha$ が大きいほど $1$ に近づきます（Marsaglia–Tsang の論文の表）。$0 < \alpha < 1$ のときは、$\alpha + 1$ のガンマ乱数に $U^{1/\alpha}$ を掛けます。
</Example>

<Remark id="rem-other-methods" title="この章で扱わない方法">
実用の正規乱数・指数乱数の生成器の多くは **ziggurat 法**（Marsaglia–Tsang）を使います。密度の下の領域を同じ面積の水平な帯に分け、ほとんどの場合に一様乱数 1 個と比較 1 回で済ませる棄却法です。対数凹な密度に対して包絡を自動的に作り直していく**適応的棄却法**（Gilks–Wild）、周辺分布と依存の構造を分けて指定する**コピュラ**、裾の重い安定分布を作る Chambers–Mallows–Stuck の方法もあります。どれも §3〜§5 の原理（逆関数・棄却・変数変換）の組み合わせです。網羅的な解説は Devroye の本にあります。
</Remark>

## 6. 離散分布と順列

### 6.1. 別名法

$n$ 点上の離散分布から標本を作るのに、逆関数法（累積和の表の二分探索）は 1 個あたり $O(\log n)$ の比較を要します。次の定理は、表を工夫すれば $n$ によらない手間で済むことを示します。

<Definition id="def-alias-table" title="別名法の表">
$\{1, \ldots, n\}$ 上の確率分布 $p = (p_1, \ldots, p_n)$ に対する**別名法の表**とは、数 $t_j \in [0, 1]$（しきい値）と番号 $a_j \in \{1, \ldots, n\}$（別名）の組 $(t_j, a_j)_{j=1}^n$ で、すべての $i$ について
$$
p_i = \frac1n\Bigl(t_i + \sum_{j\,:\,a_j = i}(1 - t_j)\Bigr)
$$
を満たすものをいう。
</Definition>

<Theorem id="thm-alias-method" title="別名法">
1. $\{1, \ldots, n\}$ 上の任意の確率分布 $p$ に対して、別名法の表が存在する。すなわち $p$ は、各々が高々 2 点 $\{j, a_j\}$ に載る $n$ 個の分布 $q_j = t_j\delta_j + (1 - t_j)\delta_{a_j}$ の等確率の混合 $p = \frac1n\sum_{j=1}^n q_j$ に書ける。
2. $J$ を $\{1, \ldots, n\}$ 上の一様分布、$V \sim \mathrm{U}(0,1)$ を $J$ と独立とし、$V < t_J$ なら $X = J$、そうでなければ $X = a_J$ と定めると、$\mathbb{P}(X = i) = p_i$ である。
3. 表は $O(n)$ 回の演算で作れる。
</Theorem>

証明の方針は、背の高い棒から低い棒へ確率を少しずつ分けて、全部の棒を高さ $1$ にそろえることです。小さな例で見ます。$p = (\frac12, \frac14, \frac14)$ なら $w = 3p = (\frac32, \frac34, \frac34)$ で、番号 2 の棒の不足 $\frac14$ を番号 1 から借りると、番号 1 は $\frac54$ に減ります。番号 3 でも同様にすると番号 1 は $1$ になって、全員が高さ $1$ にそろいます。番号 2 は確率 $\frac34$ で自分、$\frac14$ で番号 1 を返す（$t_2 = \frac34$、$a_2 = 1$）ことになります。帰納法の 1 段は、この「1 本を決めて取り除く」操作を言い換えたものです。

<Proof of="thm-alias-method">
**1.** 次の主張を $n$ についての帰納法で示します。

> 有限集合 $I$（$|I| = n \ge 1$）と $w_i \ge 0$（$i \in I$）、$\sum_{i\in I}w_i = n$ に対して、$t_j \in [0,1]$ と $a_j \in I$（$j \in I$）で、すべての $i \in I$ について $w_i = t_i + \sum_{j : a_j = i}(1 - t_j)$ を満たすものが存在する。

$w_i = np_i$ に適用して $n$ で割れば 1 が得られます。

$n = 1$ のときは $w_i = 1$ で、$t_i = 1$、$a_i = i$ とすれば $w_i = 1 + 0$ です。

$n \ge 2$ とします。平均が $1$ なので、$w_\ell \le 1$ となる $\ell \in I$ があります。$I' = I \setminus \{\ell\}$ の上の和は $n - w_\ell \ge n - 1$ で、$I'$ は $n - 1$ 個の元からなるので、$w_h \ge 1$ となる $h \in I'$ があります。
$$
t_\ell = w_\ell, \qquad a_\ell = h, \qquad w'_h = w_h - (1 - w_\ell), \qquad w'_i = w_i \ \ (i \in I' \setminus \{h\})
$$
と置きます。$w'_h = (w_h - 1) + w_\ell \ge 0$ で、$\sum_{i \in I'}w'_i = n - w_\ell - (1 - w_\ell) = n - 1$ なので、$(I', w')$ に帰納法の仮定が使えて、$t_j \in [0,1]$、$a_j \in I'$（$j \in I'$）で $w'_i = t_i + \sum_{j \in I' : a_j = i}(1 - t_j)$ となるものがあります。これに $(t_\ell, a_\ell)$ を加えた組が $I$ についての条件を満たすことを確かめます。

- $i = \ell$: $a_j = \ell$ となる $j$ はありません（$j \in I'$ では $a_j \in I'$、$a_\ell = h \ne \ell$）。よって右辺は $t_\ell = w_\ell$ です。
- $i = h$: 右辺は $t_h + \sum_{j \in I' : a_j = h}(1 - t_j) + (1 - t_\ell) = w'_h + (1 - w_\ell) = w_h$ です。
- それ以外の $i \in I'$: $a_\ell \ne i$ なので右辺は $w'_i = w_i$ です。

**2.** $J$ と $V$ が独立なので、$\mathbb{P}(X = i) = \sum_j \mathbb{P}(J = j)\,\mathbb{P}(X = i \mid J = j)$ です。$J = j$ のとき $X = j$ となる確率は $t_j$、$X = a_j$ となる確率は $1 - t_j$ なので、
$$
\mathbb{P}(X = i) = \frac1n\Bigl(t_i + \sum_{j : a_j = i}(1 - t_j)\Bigr) = p_i
$$
です（$a_i = i$ の場合は第 2 項に $1 - t_i$ が入り、$X = i$ の確率は $t_i + (1 - t_i)$ で、式は同じ形です）。

**3.** 1 の証明の帰納の 1 段は、「$w_\ell \le 1$ の番号 $\ell$」と「$w_h \ge 1$ の別の番号 $h$」を 1 つずつ選べば、どの組でも成り立ちます。そこで、番号を $w_i < 1$ のもの（小）と $w_i \ge 1$ のもの（大）の 2 つのスタックに分けておき、両方が空でないかぎり、小から $\ell$、大から $h$ を 1 つずつ取り出して上の更新を行い、$h$ を更新後の $w_h$ に応じてどちらかのスタックに戻します。1 回の繰り返しは定数回の演算で、そのたびに番号 $\ell$ が確定して取り除かれるので、繰り返しは高々 $n$ 回です。どちらかのスタックが空になった時点で残っている番号は、残りの和が残りの個数に等しいことから、すべて $w_i = 1$ で（小だけが残れば平均が $1$ 未満、大だけが残って $1$ より大きいものがあれば平均が $1$ を超えます）、$t_i = 1$、$a_i = i$ とします。最初の分類も $O(n)$ です。
</Proof>

2 では $J$ と $V$ を別々の一様乱数から作りましたが、1 個の $U \sim \mathrm{U}(0,1)$ から $J = \lfloor nU\rfloor + 1$、$V = nU - \lfloor nU\rfloor$ としても独立な一様乱数になります（<Ref to="exr-split-uniform" />）。次のコードは 3 の手順（Vose の方法）の実装と、頻度の検定です。

```python
# Python 3.9.6, NumPy 2.0.2
import numpy as np

def alias_table(p):
    """確率ベクトル p から別名法の表 (t, a) を O(n) で作る（Vose）"""
    n = len(p)
    w = [n * pi for pi in p]
    t, a = [1.0] * n, list(range(n))
    small = [i for i in range(n) if w[i] < 1.0]
    large = [i for i in range(n) if w[i] >= 1.0]
    while small and large:
        l, h = small.pop(), large.pop()
        t[l], a[l] = w[l], h
        w[h] -= 1.0 - w[l]
        (small if w[h] < 1.0 else large).append(h)
    return np.array(t), np.array(a)          # 残った列は t = 1（丸め誤差の吸収）

def alias_sample(t, a, size, rng):
    j = rng.integers(len(t), size=size)
    return np.where(rng.random(size) < t[j], j, a[j])

p = [0.05, 0.30, 0.10, 0.25, 0.02, 0.28]
t, a = alias_table(p)
print("t =", np.round(t, 4), " a =", a)
recon = t / 6 + np.bincount(a, weights=(1 - t) / 6, minlength=6)
print("表から復元した確率:", np.round(recon, 12))

rng = np.random.default_rng(20261008)
N = 10**6
counts = np.bincount(alias_sample(t, a, N, rng), minlength=6)
chi2 = float(np.sum((counts - N * np.array(p)) ** 2 / (N * np.array(p))))
print("度数:", counts)
print(f"カイ二乗統計量 = {chi2:.2f}（自由度 5。平均 5、標準偏差 {np.sqrt(10):.2f}）")
```

```text
t = [0.3  1.   0.6  0.9  0.12 0.8 ]  a = [1 1 3 1 5 3]
表から復元した確率: [0.05 0.3  0.1  0.25 0.02 0.28]
度数: [ 49953 299851 100264 249536  20084 280312]
カイ二乗統計量 = 2.38（自由度 5。平均 5、標準偏差 3.16）
```

表から <Ref to="def-alias-table" /> の式で復元した確率は $p$ に一致し、$10^6$ 個の標本の度数から計算したカイ二乗統計量 $2.38$ は、自由度 $5$ のカイ二乗分布の平均 $5$ から標準偏差 1 つ分以内にあります（番号は Python に合わせて $0$ から数えています）。

### 6.2. 一様な順列と部分集合

<Theorem id="thm-fisher-yates" title="Fisher–Yates の方法">
互いに異なる $n \ge 1$ 個の元が入った配列 $a[0], \ldots, a[n-1]$ に対して、$i = n-1, n-2, \ldots, 1$ の順に「$\{0, 1, \ldots, i\}$ 上の一様分布に従う $J_i$ を（それまでの $J$ と独立に）選び、$a[i]$ と $a[J_i]$ を交換する」操作を行う。

1. $1 \le k \le n - 1$ とする。最初の $k$ 回の操作（$i = n-1, \ldots, n-k$）の後、互いに異なる任意の元 $e_1, \ldots, e_k$ について
   $$
   \mathbb{P}\bigl(a[n-1] = e_1,\ a[n-2] = e_2,\ \ldots,\ a[n-k] = e_k\bigr) = \frac{1}{n(n-1)\cdots(n-k+1)}
   $$
   である。したがって、末尾の $k$ 個の位置にある元の集合は、$\binom nk$ 通りの $k$ 元部分集合の上で一様に分布する。
2. すべての操作の後の配列は、$n!$ 通りの並べ方の上で一様に分布する。
3. 「$i = 0, 1, \ldots, n-1$ の順に、$\{0, \ldots, n-1\}$ 上の一様分布に従う $J_i$ を独立に選び、$a[i]$ と $a[J_i]$ を交換する」方法では、$n \ge 3$ のとき配列は一様に分布しない。
</Theorem>

<Proof of="thm-fisher-yates">
**1.** $k$ についての帰納法で示します。$i = n - k$ の操作の直前、位置 $n-k+1, \ldots, n-1$ は以後動かず、位置 $0, \ldots, n-k$ には残りの $n - k + 1$ 個の元が入っています。

$k = 1$: $e_1$ は最初ある位置 $j^* \in \{0, \ldots, n-1\}$ にあり、$a[n-1] = e_1$ となるのは $J_{n-1} = j^*$ のときに限るので、確率は $1/n$ です。

$k \ge 2$: 事象 $E = \{a[n-1] = e_1, \ldots, a[n-k+1] = e_{k-1}\}$（$k - 1$ 回の操作の後）の確率は、帰納法の仮定から $1/(n(n-1)\cdots(n-k+2))$ です。$E$ は $J_{n-1}, \ldots, J_{n-k+1}$ で決まります。これらの値を $E$ が起きるように固定すると、$e_k$ は $e_1, \ldots, e_{k-1}$ と異なるので位置 $0, \ldots, n-k$ のどこか 1 か所 $j^*$ にあり、$a[n-k] = e_k$ となるのは $J_{n-k} = j^*$ のときに限ります。$J_{n-k}$ はそれまでの $J$ と独立で $\{0, \ldots, n-k\}$ 上一様なので、その条件付き確率は $1/(n-k+1)$ です。掛け合わせて主張を得ます。

部分集合については、$k$ 元部分集合 1 つに対して、その元を末尾の $k$ か所に並べる順序が $k!$ 通りあるので、確率は $k!/(n(n-1)\cdots(n-k+1)) = 1/\binom nk$ です。

**2.** $n = 1$ では操作がなく、並べ方は 1 通りです。$n \ge 2$ では、1 で $k = n - 1$ とします。位置 $1, \ldots, n-1$ の元が決まれば位置 $0$ の元は残りの 1 つに決まるので、各並べ方の確率は $1/(n(n-1)\cdots2) = 1/n!$ です。

**3.** 添字の列 $(J_0, \ldots, J_{n-1})$ は $n^n$ 通りあり、どれも確率 $n^{-n}$ です。並べ方 $\pi$ が得られる列の個数を $N_\pi$ とすると $\mathbb{P}(\pi) = N_\pi/n^n$ です。一様だとすると $N_\pi = n^n/n!$ が整数、すなわち $n! \mid n^n$ です。$n \ge 3$ のとき $n - 1 \ge 2$ は $n!$ の約数なので、$n - 1 \mid n^n$ となります。一方 $\gcd(n-1, n) = 1$ から $\gcd(n-1, n^n) = 1$ なので（<Ref to="mathematics/number-theory/elementary-number-theory#lem-coprime-product" />）、$n - 1 \mid n^n$ は $n - 1 = 1$ を意味し、$n \ge 3$ に反します。
</Proof>

3 の誤りは、見た目が自然なだけに実際のプログラムによく現れます。$n = 3$ で両方の方法の確率を全数で数えます。

```python
# Python 3.9.6（標準ライブラリのみ）
from itertools import product
from collections import Counter

def naive(js):                      # すべての位置 i を無作為な位置 j と交換
    a = [0, 1, 2]
    for i, j in enumerate(js):
        a[i], a[j] = a[j], a[i]
    return tuple(a)

def fisher_yates(js):               # i = 2, 1 の順に、0..i から選んだ j と交換
    a = [0, 1, 2]
    for i, j in zip((2, 1), js):
        a[i], a[j] = a[j], a[i]
    return tuple(a)

c1 = Counter(naive(js) for js in product(range(3), repeat=3))
c2 = Counter(fisher_yates(js) for js in product(range(3), range(2)))
for perm in sorted(c1):
    print(perm, f"素朴な方法 {c1[perm]}/27   Fisher–Yates {c2[perm]}/6")
```

```text
(0, 1, 2) 素朴な方法 4/27   Fisher–Yates 1/6
(0, 2, 1) 素朴な方法 5/27   Fisher–Yates 1/6
(1, 0, 2) 素朴な方法 5/27   Fisher–Yates 1/6
(1, 2, 0) 素朴な方法 5/27   Fisher–Yates 1/6
(2, 0, 1) 素朴な方法 4/27   Fisher–Yates 1/6
(2, 1, 0) 素朴な方法 4/27   Fisher–Yates 1/6
```

素朴な方法では確率が $4/27 \approx 0.148$ と $5/27 \approx 0.185$ に分かれ、$1/6 \approx 0.167$ から 1 割ずれます。

最後に、<Ref to="prop-float-uniform" /> と <Ref to="prop-uniform-sphere" /> の数値を任意精度で確かめます。

```python
# Python 3.9.6, mpmath 1.3.0
from mpmath import mp, mpf, log, sqrt, erfc, findroot, pi, gamma
mp.dps = 30
umin = mpf(2) ** -53
print("指数分布 -ln(1-U) の最大値  53 ln 2 =", log(2) * 53)
z = findroot(lambda t: erfc(t / sqrt(2)) / 2 - umin, 8)
print("正規分布（逆関数法）の最大値 z* =", z)
print("Box-Muller の動径の最大値 sqrt(2*53 ln 2) =", sqrt(2 * 53 * log(2)))
for d in (2, 3, 5, 10, 20):
    print(f"d = {d:2d}: 球/立方体 = {float(pi**(mpf(d)/2) / (2**d * gamma(mpf(d)/2 + 1))):.3e}")
```

```text
指数分布 -ln(1-U) の最大値  53 ln 2 = 36.7368005696771013991133024373
正規分布（逆関数法）の最大値 z* = 8.20953615160138685563076877867
Box-Muller の動径の最大値 sqrt(2*53 ln 2) = 8.57167434865290497745122222678
d =  2: 球/立方体 = 7.854e-01
d =  3: 球/立方体 = 5.236e-01
d =  5: 球/立方体 = 1.645e-01
d = 10: 球/立方体 = 2.490e-03
d = 20: 球/立方体 = 2.461e-08
```

## 7. 演習

<Exercise id="exr-geometric-inverse" difficulty="易">
$0 < p < 1$、$q = 1 - p$、$U \sim \mathrm{U}(0,1)$ とする。$X = \lceil \ln(1 - U)/\ln q\rceil$ が成功確率 $p$ の幾何分布（$\mathbb{P}(X = k) = q^{k-1}p$、$k \ge 1$）に従うことを示せ。
<Solution>
$\ln q < 0$ と $1 - U \in (0, 1)$ から $Y = \ln(1 - U)/\ln q > 0$ で、$X = \lceil Y\rceil \ge 1$ です。整数 $k \ge 0$ について $X > k \iff Y > k$ で、$\ln q < 0$ に注意して
$$
\mathbb{P}(X > k) = \mathbb{P}\bigl(\ln(1 - U) < k\ln q\bigr) = \mathbb{P}(1 - U < q^k) = q^k
$$
です（$1 - U \sim \mathrm{U}(0,1)$）。よって $\mathbb{P}(X = k) = q^{k-1} - q^k = q^{k-1}p$ です。これは、率 $-\ln q$ の指数分布を切り上げたもので、一様乱数 1 個と対数 1 回で幾何分布の標本が得られます（成功するまで試行を繰り返すと、平均 $1/p$ 個の一様乱数が要ります）。
</Solution>
</Exercise>

<Exercise id="exr-beta-rejection" difficulty="標準">
目標を密度 $f(x) = 6x(1 - x)$（$0 < x < 1$）、提案を $(0,1)$ 上の一様分布とする。(1) 包絡条件を満たす最小の $M$ と採択率を求めよ。(2) 誤って $M = 1$ で棄却法を行ったとき、出力の密度と、その $x = \frac12$ での値を求めよ。
<Solution>
(1) $f/g = 6x(1-x)$ の最大値は $x = \frac12$ での $\frac32$ なので $M = \frac32$、採択率は <Ref to="thm-rejection-sampling" /> の 3 から $1/M = \frac23$ です。

(2) <Ref to="thm-rejection-sampling" /> の 2 から、出力の密度は $h = \min(f, 1)$ に比例します。$6x(1-x) \ge 1$ となるのは $x_- \le x \le x_+$、$x_\pm = \frac12 \pm \frac{1}{2\sqrt3}$ で、
$$
\int_0^1 h = 1 - \int_{x_-}^{x_+}\bigl(6x(1-x) - 1\bigr)dx = 1 - \int_{x_-}^{x_+} 6(x - x_-)(x_+ - x)\,dx = 1 - (x_+ - x_-)^3 = 1 - \frac{1}{3\sqrt3} \approx 0.8075
$$
です（$\int_a^b (x-a)(b-x)\,dx = (b-a)^3/6$）。出力の密度は $\min(6x(1-x), 1)/0.8075$ で、$x = \frac12$ では約 $1.238$ です。正しい値 $1.5$ より低く、山の頂上が平らに削られた分布になります。両端の近くでは逆に密度が $1/0.8075 \approx 1.24$ 倍に過大になります。
</Solution>
</Exercise>

<Exercise id="exr-split-uniform" difficulty="標準">
$U \sim \mathrm{U}(0,1)$、$n \ge 1$ とし、$J = \lfloor nU\rfloor + 1$、$V = nU - \lfloor nU\rfloor$ と置く。$J$ は $\{1, \ldots, n\}$ 上の一様分布、$V$ は $\mathrm{U}(0,1)$ に従い、$J$ と $V$ は独立であることを示せ。倍精度の一様乱数でこれを行うとき、何に注意すべきか。
<Solution>
$1 \le j \le n$ と $0 \le v < 1$ について $\{J = j,\ V \le v\} = \{(j-1)/n \le U \le (j - 1 + v)/n\}$、$v = 1$ については $\{J = j\} = \{(j-1)/n \le U < j/n\}$ なので、どちらの場合も
$$
\mathbb{P}(J = j,\ V \le v) = \frac{v}{n}
$$
です。$v = 1$ として $\mathbb{P}(J = j) = 1/n$、$j$ について和を取って $\mathbb{P}(V \le v) = v$ です。よって $\mathbb{P}(J = j, V \le v) = \mathbb{P}(J = j)\mathbb{P}(V \le v)$ で、半直線 $(-\infty, v]$ は分布を決めるので $J$ と $V$ は独立です。

倍精度の一様乱数 $U = k\,2^{-53}$ では、$V$ は $U$ の下位のビットから作られるので、$n$ が大きいと $V$ の精度が $53 - \log_2n$ ビットに減ります。$n = 2^{20}$ なら $V$ は $2^{-33}$ の倍数しか取りません。しきい値 $t_j$ との比較の精度がそれで足りないとき（非常に小さい確率 $p_i$ を正確に出したいとき）は、$J$ と $V$ を別々の乱数から作ります。
</Solution>
</Exercise>

<Exercise id="exr-alias-by-hand" difficulty="標準">
$p = (\frac12, \frac13, \frac1{12}, \frac1{12})$ に対する別名法の表を、<Ref to="thm-alias-method" /> の証明の手順で作り、<Ref to="def-alias-table" /> の式を確かめよ。
<Solution>
$w = 4p = (2, \frac43, \frac13, \frac13)$ です。

- $\ell = 3$（$w_3 = \frac13$）、$h = 1$: $t_3 = \frac13$、$a_3 = 1$、$w_1 \leftarrow 2 - \frac23 = \frac43$。残りは $\{1, 2, 4\}$ で $w = (\frac43, \frac43, \frac13)$、和は $3$。
- $\ell = 4$、$h = 1$: $t_4 = \frac13$、$a_4 = 1$、$w_1 \leftarrow \frac43 - \frac23 = \frac23$。残りは $\{1, 2\}$ で $w = (\frac23, \frac43)$、和は $2$。
- $\ell = 1$、$h = 2$: $t_1 = \frac23$、$a_1 = 2$、$w_2 \leftarrow \frac43 - \frac13 = 1$。残りは $\{2\}$ で $t_2 = 1$、$a_2 = 2$。

確かめると、$p_1 = \frac14\bigl(t_1 + (1 - t_3) + (1 - t_4)\bigr) = \frac14\cdot2 = \frac12$、$p_2 = \frac14\bigl(t_2 + (1 - t_1)\bigr) = \frac14\cdot\frac43 = \frac13$、$p_3 = \frac14t_3 = \frac1{12}$、$p_4 = \frac14t_4 = \frac1{12}$ です（$a_2 = 2$ の寄与 $1 - t_2 = 0$）。表は一意ではなく、$\ell, h$ の選び方で変わります。
</Solution>
</Exercise>

## 参考文献

1. L. Devroye, *Non-Uniform Random Variate Generation*, Springer, 1986 — 逆関数法（第 II 章 2 節）、棄却法（第 II 章 3 節）、別名法（第 III 章 4 節）。
2. D. E. Knuth, *The Art of Computer Programming, Volume 2: Seminumerical Algorithms*, 3rd ed., Addison-Wesley, 1997 — 3.4 節（他の種類の乱数）。
3. G. E. P. Box, M. E. Muller, "A note on the generation of random normal deviates", *Annals of Mathematical Statistics* 29 (1958), 610–611.
4. A. J. Walker, "An efficient method for generating discrete random variables with general distributions", *ACM Transactions on Mathematical Software* 3 (1977), 253–256.
5. M. D. Vose, "A linear algorithm for generating random numbers with a given distribution", *IEEE Transactions on Software Engineering* 17 (1991), 972–975.
6. A. J. Kinderman, J. F. Monahan, "Computer generation of random variables using the ratio of uniform deviates", *ACM Transactions on Mathematical Software* 3 (1977), 257–260.
7. G. Marsaglia, W. W. Tsang, "A simple method for generating gamma variables", *ACM Transactions on Mathematical Software* 26 (2000), 363–372.
8. A. W. van der Vaart, *Asymptotic Statistics*, Cambridge University Press, 1998 — 第 19 章（経験過程と Kolmogorov–Smirnov 統計量）。