コイン投げを 100 回して表が 60 回出たとき、「表の出る確率はおよそ 0.6」と見積もるのは自然です。ではその見積もりは、どれくらい当たっているのでしょうか。回数を増やせば、見積もりのずれはどのくらい小さくなるのでしょうか。この記事は、見積もりの作り方(最尤推定)と、ずれの大きさにこれ以上は小さくできない限界があること、そして回数が多いときにはずれがほぼ正規分布に従うことを、順に示します。読み終えると、推定値に添える「誤差の目安」を自分で計算できるようになります。
最尤推定量 は、観測データの確率(尤度)を最大にする母数です。尤度の対数の微分 s = ∂ θ log f s=\partial_\theta\log f s = ∂ θ log f 分散 が Fisher 情報 I ( θ ) I(\theta) I ( θ ) I ( θ ) = − E [ ∂ θ 2 log f ] I(\theta)=-E[\partial_\theta^2\log f] I ( θ ) = − E [ ∂ θ 2 log f ] Cramér–Rao の不等式 :不偏推定量の分散は τ ′ ( θ ) 2 / ( n I ( θ ) ) \tau'(\theta)^2/(nI(\theta)) τ ′ ( θ ) 2 / ( n I ( θ )) 正則条件のもとで、最尤推定方程式の根の列で 一致するもの が存在し(Cramér の定理)、それは n ( θ ^ n − θ 0 ) → N ( 0 , 1 / I ( θ 0 ) ) \sqrt n(\hat\theta_n-\theta_0)\to N(0,1/I(\theta_0)) n ( θ ^ n − θ 0 ) → N ( 0 , 1/ I ( θ 0 )) 漸近正規性 をもちます。したがって漸近分散が Cramér–Rao の下界に達します(漸近有効)。
delta 法 :n ( T n − θ ) → N ( 0 , σ 2 ) \sqrt n(T_n-\theta)\to N(0,\sigma^2) n ( T n − θ ) → N ( 0 , σ 2 ) g g g n ( g ( T n ) − g ( θ ) ) → N ( 0 , g ′ ( θ ) 2 σ 2 ) \sqrt n(g(T_n)-g(\theta))\to N(0,g'(\theta)^2\sigma^2) n ( g ( T n ) − g ( θ )) → N ( 0 , g ′ ( θ ) 2 σ 2 ) ベイズ推定 では母数に事前分布を置き、事後分布で推測します。二乗損失での最適推定量は事後平均で、ベルヌーイ試行のベータ事前分布では、事後平均と最尤推定量の差は O ( 1 / n ) O(1/n) O ( 1/ n )
十分統計量 : 母数についてデータが持つ情報を、すべて保っている要約量のこと。→ 十分統計量 推定量・偏り : データから母数を見積もる規則が推定量で、その期待値と真の値との差が偏りです。→ 推定量 UMVUE : 不偏推定量のうち、どの母数の値でも分散がいちばん小さいもの。→ 前の記事 確率収束・分布収束 : 確率変数の列が、ある値に近づく、またはある分布の形に近づくという 2 通りの収束です。→ 確率収束 、分布収束 条件付き期待値 : ある情報を知ったうえでの、確率変数の平均的な値。→ 条件付き期待値 前の記事 では、不偏推定量の中で分散 が最小のものを、十分統計量 と完備性で構成しました。しかし、この方法には限界があります。(1) UMVUE(一様最小分散不偏推定量)は、完備十分統計量が存在する特殊な場合にしか使えません。(2) 不偏性は絶対的な要請ではなく、偏りを少し許して MSE が下がるなら、そのほうが良いこともあります。(3) 実務では、母数が複雑な関数 g ( θ ) g(\theta) g ( θ )
そこで、標本数 n n n 漸近的な 性質に目を向けます。ほとんどのモデルで、尤度を最大化するという単純な規則(最尤推定)が、n → ∞ n\to\infty n → ∞ 大数の法則と中心極限定理 )とテイラー展開だけから証明するのがこの記事の山場です。最後にベイズ推定を扱い、頻度論的な推定と漸近的に一致することを見ます。
以下、i.i.d. 標本 X 1 , … , X n ∼ f ( x ; θ ) X_1,\dots,X_n\sim f(x;\theta) X 1 , … , X n ∼ f ( x ; θ ) θ ∈ Θ ⊂ R \theta\in\Theta\subset\mathbb R θ ∈ Θ ⊂ R
定義 2.1 (尤度・対数尤度・スコア・最尤推定量 ) ↗
観測 x = ( x 1 , … , x n ) x=(x_1,\dots,x_n) x = ( x 1 , … , x n ) 尤度関数 を L n ( θ ) = ∏ i = 1 n f ( x i ; θ ) L_n(\theta)=\prod_{i=1}^nf(x_i;\theta) L n ( θ ) = ∏ i = 1 n f ( x i ; θ ) 対数尤度 を ℓ n ( θ ) = ∑ i log f ( x i ; θ ) \ell_n(\theta)=\sum_i\log f(x_i;\theta) ℓ n ( θ ) = ∑ i log f ( x i ; θ ) スコア関数 は s ( x ; θ ) = ∂ θ log f ( x ; θ ) s(x;\theta)=\partial_\theta\log f(x;\theta) s ( x ; θ ) = ∂ θ log f ( x ; θ ) ℓ n ′ ( θ ) = ∑ i s ( x i ; θ ) \ell_n'(\theta)=\sum_is(x_i;\theta) ℓ n ′ ( θ ) = ∑ i s ( x i ; θ ) L n L_n L n ℓ n \ell_n ℓ n θ ^ n = θ ^ n ( x ) \hat\theta_n=\hat\theta_n(x) θ ^ n = θ ^ n ( x ) 最尤推定量(MLE)といい、微分可能な場合は 尤度方程式 ℓ n ′ ( θ ) = 0 \ell_n'(\theta)=0 ℓ n ′ ( θ ) = 0
例 2.2 (基本的な最尤推定量 )
(i) ベルヌーイ:ℓ n = t log p + ( n − t ) log ( 1 − p ) \ell_n=t\log p+(n-t)\log(1-p) ℓ n = t log p + ( n − t ) log ( 1 − p ) t = ∑ x i t=\sum x_i t = ∑ x i ℓ n ′ = t / p − ( n − t ) / ( 1 − p ) = 0 \ell_n'=t/p-(n-t)/(1-p)=0 ℓ n ′ = t / p − ( n − t ) / ( 1 − p ) = 0 p ^ = x ˉ \hat p=\bar x p ^ = x ˉ N ( μ , σ 2 ) N(\mu,\sigma^2) N ( μ , σ 2 ) μ ^ = x ˉ \hat\mu=\bar x μ ^ = x ˉ σ ^ 2 = 1 n ∑ ( x i − x ˉ ) 2 \hat\sigma^2=\frac1n\sum(x_i-\bar x)^2 σ ^ 2 = n 1 ∑ ( x i − x ˉ ) 2 E σ ^ 2 = n − 1 n σ 2 E\hat\sigma^2=\frac{n-1}n\sigma^2 E σ ^ 2 = n n − 1 σ 2 E x p ( λ ) \mathrm{Exp}(\lambda) Exp ( λ ) ℓ n = n log λ − λ ∑ x i \ell_n=n\log\lambda-\lambda\sum x_i ℓ n = n log λ − λ ∑ x i λ ^ = 1 / x ˉ \hat\lambda=1/\bar x λ ^ = 1/ x ˉ T = ∑ X i ∼ G a m m a ( n , λ ) T=\sum X_i\sim\mathrm{Gamma}(n,\lambda) T = ∑ X i ∼ Gamma ( n , λ ) E [ 1 / T ] = λ / ( n − 1 ) E[1/T]=\lambda/(n-1) E [ 1/ T ] = λ / ( n − 1 ) E λ ^ = n n − 1 λ E\hat\lambda=\frac n{n-1}\lambda E λ ^ = n − 1 n λ U ( 0 , θ ) U(0,\theta) U ( 0 , θ ) θ − n 1 { θ ≥ max x i } \theta^{-n}\mathbf 1\{\theta\ge\max x_i\} θ − n 1 { θ ≥ max x i } θ = max x i \theta=\max x_i θ = max x i θ ^ = M \hat\theta=M θ ^ = M E M = n n + 1 θ E M=\frac n{n+1}\theta E M = n + 1 n θ M S E = 2 θ 2 ( n + 1 ) ( n + 2 ) \mathrm{MSE}=\frac{2\theta^2}{(n+1)(n+2)} MSE = ( n + 1 ) ( n + 2 ) 2 θ 2 n + 1 n M \frac{n+1}nM n n + 1 M θ 2 n ( n + 2 ) \frac{\theta^2}{n(n+2)} n ( n + 2 ) θ 2
最尤推定量は、母数の 1 対 1 変換に関して同変 です。ψ = g ( θ ) \psi=g(\theta) ψ = g ( θ ) ψ \psi ψ g ( θ ^ ) g(\hat\theta) g ( θ ^ ) σ ^ = σ ^ 2 \hat\sigma=\sqrt{\hat\sigma^2} σ ^ = σ ^ 2
以下の議論に必要な正則条件 をまとめておきます。五つ並びますが、ねらいは、積分と微分の順序を入れ替えてよいこと、台(密度が正になる範囲)が母数によらないこと、微分の剰余が抑えられることを保証する技術的な仮定です。(R1) の σ \sigma σ
定義 3.1 (正則条件(R) ) ↗
母数空間 Θ \Theta Θ θ 0 ∈ Θ \theta_0\in\Theta θ 0 ∈ Θ
(R1) すべての P θ P_\theta P θ σ \sigma σ μ \mu μ f ( x ; θ ) f(x;\theta) f ( x ; θ ) { f > 0 } \{f>0\} { f > 0 } θ \theta θ θ ≠ θ ′ \theta\ne\theta' θ = θ ′ P θ ≠ P θ ′ P_\theta\ne P_{\theta'} P θ = P θ ′ (R2) θ ↦ log f ( x ; θ ) \theta\mapsto\log f(x;\theta) θ ↦ log f ( x ; θ ) C 3 C^3 C 3 (R3) ∫ f d μ = 1 \int f\,d\mu=1 ∫ f d μ = 1 θ \theta θ ∫ ∂ θ f d μ = 0 \int\partial_\theta f\,d\mu=0 ∫ ∂ θ f d μ = 0 ∫ ∂ θ 2 f d μ = 0 \int\partial_\theta^2f\,d\mu=0 ∫ ∂ θ 2 f d μ = 0 E θ T 2 < ∞ E_\theta T^2<\infty E θ T 2 < ∞ T T T T T T X 1 , … , X n X_1,\dots,X_n X 1 , … , X n ∏ f ( x i ; θ ) \prod f(x_i;\theta) ∏ f ( x i ; θ ) θ ↦ E θ T \theta\mapsto E_\theta T θ ↦ E θ T d d θ E θ T = ∫ T ∂ θ f d μ \frac d{d\theta}E_\theta T=\int T\,\partial_\theta f\,d\mu d θ d E θ T = ∫ T ∂ θ f d μ (R4) 0 < I ( θ ) < ∞ 0<I(\theta)<\infty 0 < I ( θ ) < ∞ I ( θ ) = E θ [ s ( X ; θ ) 2 ] I(\theta)=E_\theta[s(X;\theta)^2] I ( θ ) = E θ [ s ( X ; θ ) 2 ] (R5) θ 0 \theta_0 θ 0 ∣ ∂ θ 3 log f ( x ; θ ) ∣ ≤ M ( x ) |\partial_\theta^3\log f(x;\theta)|\le M(x) ∣ ∂ θ 3 log f ( x ; θ ) ∣ ≤ M ( x ) E θ 0 M ( X ) < ∞ E_{\theta_0}M(X)<\infty E θ 0 M ( X ) < ∞ θ ∈ Θ \theta\in\Theta θ ∈ Θ E θ 0 ∣ log f ( X ; θ ) ∣ < ∞ E_{\theta_0}|\log f(X;\theta)|<\infty E θ 0 ∣ log f ( X ; θ ) ∣ < ∞ これらは、指数型分布族の内点で成り立ちます(積分記号下の微分は 定理 4.5[統計モデルと十分統計量] の評価で正当化)。一様分布 U ( 0 , θ ) U(0,\theta) U ( 0 , θ ) θ \theta θ
補題 3.2 (スコアの平均と分散 ) ✓
(R1)–(R4) のもとで E θ [ s ( X ; θ ) ] = 0 E_\theta[s(X;\theta)]=0 E θ [ s ( X ; θ )] = 0
I ( θ ) = V a r θ ( s ( X ; θ ) ) = − E θ [ ∂ θ 2 log f ( X ; θ ) ] . I(\theta)=\mathrm{Var}_\theta\bigl(s(X;\theta)\bigr)=-E_\theta\bigl[\partial_\theta^2\log f(X;\theta)\bigr]. I ( θ ) = Var θ ( s ( X ; θ ) ) = − E θ [ ∂ θ 2 log f ( X ; θ ) ] . n n n ℓ n ′ \ell_n' ℓ n ′ n I ( θ ) nI(\theta) n I ( θ )
証明(補題 3.2) ∫ f d μ = 1 \int f\,d\mu=1 ∫ f d μ = 1 ∫ ∂ θ f d μ = 0 \int\partial_\theta f\,d\mu=0 ∫ ∂ θ f d μ = 0 ∂ θ f = s f \partial_\theta f=s\,f ∂ θ f = s f E θ s = ∫ s f d μ = 0 E_\theta s=\int sf\,d\mu=0 E θ s = ∫ s f d μ = 0 V a r ( s ) = E [ s 2 ] = I ( θ ) \mathrm{Var}(s)=E[s^2]=I(\theta) Var ( s ) = E [ s 2 ] = I ( θ ) ∫ ∂ θ 2 f d μ = 0 \int\partial_\theta^2f\,d\mu=0 ∫ ∂ θ 2 f d μ = 0 ∂ θ 2 f = ∂ θ ( s f ) = ( ∂ θ s + s 2 ) f \partial_\theta^2f=\partial_\theta(sf)=(\partial_\theta s+s^2)f ∂ θ 2 f = ∂ θ ( s f ) = ( ∂ θ s + s 2 ) f E [ ∂ θ s ] + E [ s 2 ] = 0 E[\partial_\theta s]+E[s^2]=0 E [ ∂ θ s ] + E [ s 2 ] = 0 ∂ θ s = ∂ θ 2 log f \partial_\theta s=\partial_\theta^2\log f ∂ θ s = ∂ θ 2 log f
∎ Fisher 情報 は、対数尤度の曲率(尤度のピークの鋭さ)の期待値です。ピークが鋭いほど、データは母数について多くを語ります。
0.2 0.4 0.6 0.8 0.9 p ℓ(p) − ℓ(p̂) n = 10 n = 40 ベルヌーイ試行の対数尤度(最大値を 0 に揃えた相対対数尤度)。標本比率 0.6 で n = 10(広い山)と n = 40(細い山)。山の頂上の曲率が観測された Fisher 情報で、n に比例して鋭くなる。 証明(命題 3.3) 連鎖律より ∂ η log f ( x ; θ ( η ) ) = s ( x ; θ ) θ ′ ( η ) \partial_\eta\log f(x;\theta(\eta))=s(x;\theta)\,\theta'(\eta) ∂ η log f ( x ; θ ( η )) = s ( x ; θ ) θ ′ ( η )
∎ 例 3.4 (代表的な分布の Fisher 情報 )
ベルヌーイ:s = x p − 1 − x 1 − p s=\frac xp-\frac{1-x}{1-p} s = p x − 1 − p 1 − x I ( p ) = 1 p ( 1 − p ) I(p)=\frac1{p(1-p)} I ( p ) = p ( 1 − p ) 1
ポアソン:∂ λ 2 log f = − x / λ 2 \partial_\lambda^2\log f=-x/\lambda^2 ∂ λ 2 log f = − x / λ 2 I ( λ ) = 1 / λ I(\lambda)=1/\lambda I ( λ ) = 1/ λ
正規(σ 2 \sigma^2 σ 2 I ( μ ) = 1 / σ 2 I(\mu)=1/\sigma^2 I ( μ ) = 1/ σ 2 μ \mu μ σ 2 \sigma^2 σ 2 I ( σ 2 ) = 1 2 σ 4 I(\sigma^2)=\frac1{2\sigma^4} I ( σ 2 ) = 2 σ 4 1
指数:I ( λ ) = 1 / λ 2 I(\lambda)=1/\lambda^2 I ( λ ) = 1/ λ 2
自然母数 η \eta η ∂ η 2 log f = − A ′ ′ ( η ) \partial_\eta^2\log f=-A''(\eta) ∂ η 2 log f = − A ′′ ( η ) I ( η ) = A ′ ′ ( η ) = V a r ( T ) I(\eta)=A''(\eta)=\mathrm{Var}(T) I ( η ) = A ′′ ( η ) = Var ( T ) 定理 4.5[統計モデルと十分統計量] )。
この節のねらいは、不偏推定量の分散には、どんな工夫をしてもこれ以下にはできない限界があることを示すことです。証明の方針は、推定量 T T T 共分散 を計算し、それにコーシー・シュワルツ不等式を使うだけです。共分散は「T T T 0 0 0 E [ T ℓ n ′ ] E[T\ell_n'] E [ T ℓ n ′ ]
定理 4.1 (Cramér–Rao の不等式 ) ✓
(R1)–(R4) のもとで、τ ( θ ) \tau(\theta) τ ( θ ) T = T ( X 1 , … , X n ) T=T(X_1,\dots,X_n) T = T ( X 1 , … , X n ) E θ T 2 < ∞ E_\theta T^2<\infty E θ T 2 < ∞
V a r θ ( T ) ≥ τ ′ ( θ ) 2 n I ( θ ) \mathrm{Var}_\theta(T)\ge\frac{\tau'(\theta)^2}{n\,I(\theta)} Var θ ( T ) ≥ n I ( θ ) τ ′ ( θ ) 2 を満たす。等号は、ある関数 c ( θ ) c(\theta) c ( θ ) T − τ ( θ ) = c ( θ ) ℓ n ′ ( θ ) T-\tau(\theta)=c(\theta)\,\ell_n'(\theta) T − τ ( θ ) = c ( θ ) ℓ n ′ ( θ ) P θ P_\theta P θ
証明(定理 4.1) 同時密度 f n ( x ; θ ) = ∏ f ( x i ; θ ) f_n(x;\theta)=\prod f(x_i;\theta) f n ( x ; θ ) = ∏ f ( x i ; θ ) τ ′ ( θ ) = d d θ E θ T = ∫ T ∂ θ f n d μ n = E θ [ T ℓ n ′ ] \tau'(\theta)=\frac d{d\theta}E_\theta T=\int T\,\partial_\theta f_n\,d\mu^n=E_\theta[T\,\ell_n'] τ ′ ( θ ) = d θ d E θ T = ∫ T ∂ θ f n d μ n = E θ [ T ℓ n ′ ] 補題 3.2 より E θ ℓ n ′ = 0 E_\theta\ell_n'=0 E θ ℓ n ′ = 0 C o v θ ( T , ℓ n ′ ) \mathrm{Cov}_\theta(T,\ell_n') Cov θ ( T , ℓ n ′ ) 共分散のコーシー・シュワルツ不等式(定理 5.6)[確率変数と期待値] から
τ ′ ( θ ) 2 = C o v ( T , ℓ n ′ ) 2 ≤ V a r ( T ) V a r ( ℓ n ′ ) = V a r ( T ) ⋅ n I ( θ ) . \tau'(\theta)^2=\mathrm{Cov}(T,\ell_n')^2\le\mathrm{Var}(T)\,\mathrm{Var}(\ell_n')=\mathrm{Var}(T)\cdot nI(\theta). τ ′ ( θ ) 2 = Cov ( T , ℓ n ′ ) 2 ≤ Var ( T ) Var ( ℓ n ′ ) = Var ( T ) ⋅ n I ( θ ) . 等号は T − E T T-E T T − E T ℓ n ′ \ell_n' ℓ n ′
∎ τ ( θ ) = θ \tau(\theta)=\theta τ ( θ ) = θ 1 / ( n I ( θ ) ) 1/(nI(\theta)) 1/ ( n I ( θ )) b ( θ ) b(\theta) b ( θ ) τ = θ + b ( θ ) \tau=\theta+b(\theta) τ = θ + b ( θ ) V a r ≥ ( 1 + b ′ ) 2 / ( n I ) \mathrm{Var}\ge(1+b')^2/(nI) Var ≥ ( 1 + b ′ ) 2 / ( n I ) 有効推定量 といいます。
例 4.2 (下界に達する例と達しない例 )
(i) ポアソン:X ˉ \bar X X ˉ V a r = λ / n = 1 / ( n I ( λ ) ) \mathrm{Var}=\lambda/n=1/(nI(\lambda)) Var = λ / n = 1/ ( n I ( λ )) V a r ( X ˉ ) = p ( 1 − p ) / n = 1 / ( n I ( p ) ) \mathrm{Var}(\bar X)=p(1-p)/n=1/(nI(p)) Var ( X ˉ ) = p ( 1 − p ) / n = 1/ ( n I ( p )) μ \mu μ S 0 / n S_0/n S 0 / n S 0 = ∑ ( X i − μ ) 2 ∼ σ 2 χ n 2 S_0=\sum(X_i-\mu)^2\sim\sigma^2\chi^2_n S 0 = ∑ ( X i − μ ) 2 ∼ σ 2 χ n 2 2 σ 4 / n 2\sigma^4/n 2 σ 4 / n 1 / ( n I ( σ 2 ) ) = 2 σ 4 / n 1/(nI(\sigma^2))=2\sigma^4/n 1/ ( n I ( σ 2 )) = 2 σ 4 / n μ \mu μ S 2 S^2 S 2 例 6.6[統計モデルと十分統計量] )で V a r ( S 2 ) = 2 σ 4 n − 1 > 2 σ 4 n \mathrm{Var}(S^2)=\frac{2\sigma^4}{n-1}>\frac{2\sigma^4}n Var ( S 2 ) = n − 1 2 σ 4 > n 2 σ 4 U ( 0 , θ ) U(0,\theta) U ( 0 , θ ) θ 2 / ( n ( n + 2 ) ) \theta^2/(n(n+2)) θ 2 / ( n ( n + 2 )) n − 2 n^{-2} n − 2 n − 1 n^{-1} n − 1 θ \theta θ
下界に達するのは、スコアが T − τ T-\tau T − τ θ \theta θ log f n \log f_n log f n θ \theta θ T T T
この節のねらいは、n n n θ 0 \theta_0 θ 0 θ 0 \theta_0 θ 0 θ 0 \theta_0 θ 0 0 0 0 確率収束 の意味での一致性です。
補題 5.1 (Kullback–Leibler の不等式 ) ✓
(R1)、(R5) のもとで、θ ≠ θ 0 \theta\ne\theta_0 θ = θ 0 K ( θ ) = E θ 0 [ log f ( X ; θ ) f ( X ; θ 0 ) ] < 0 K(\theta)=E_{\theta_0}\bigl[\log\frac{f(X;\theta)}{f(X;\theta_0)}\bigr]<0 K ( θ ) = E θ 0 [ log f ( X ; θ 0 ) f ( X ; θ ) ] < 0
証明(補題 5.1) u = f ( X ; θ ) / f ( X ; θ 0 ) u=f(X;\theta)/f(X;\theta_0) u = f ( X ; θ ) / f ( X ; θ 0 ) E θ 0 u = ∫ { f ( ⋅ ; θ 0 ) > 0 } f ( x ; θ ) d μ = 1 E_{\theta_0}u=\int_{\{f(\cdot;\theta_0)>0\}}f(x;\theta)\,d\mu=1 E θ 0 u = ∫ { f ( ⋅ ; θ 0 ) > 0 } f ( x ; θ ) d μ = 1 log u ≤ u − 1 \log u\le u-1 log u ≤ u − 1 u = 1 u=1 u = 1 log \log log P θ 0 ( u ≠ 1 ) > 0 P_{\theta_0}(u\ne1)>0 P θ 0 ( u = 1 ) > 0 E θ 0 [ ( u − 1 ) − log u ] > 0 E_{\theta_0}[(u-1)-\log u]>0 E θ 0 [( u − 1 ) − log u ] > 0 E θ 0 log u < E θ 0 ( u − 1 ) = 0 E_{\theta_0}\log u<E_{\theta_0}(u-1)=0 E θ 0 log u < E θ 0 ( u − 1 ) = 0
∎ なお、次の定理の証明の最後にある N k N_k N k δ \delta δ n n n θ ^ n \hat\theta_n θ ^ n
定理 5.2 (尤度方程式の一致する根の存在(Cramér) ) ✓
(R1)、(R2)、(R5) のもとで、尤度方程式 ℓ n ′ ( θ ) = 0 \ell_n'(\theta)=0 ℓ n ′ ( θ ) = 0 θ ^ n \hat\theta_n θ ^ n θ ^ n → θ 0 \hat\theta_n\to\theta_0 θ ^ n → θ 0
証明(定理 5.2) δ > 0 \delta>0 δ > 0 [ θ 0 − δ , θ 0 + δ ] ⊂ Θ [\theta_0-\delta,\theta_0+\delta]\subset\Theta [ θ 0 − δ , θ 0 + δ ] ⊂ Θ 補題 5.1 により K ( θ 0 ± δ ) < 0 K(\theta_0\pm\delta)<0 K ( θ 0 ± δ ) < 0 大数の弱法則(定理 4.1)[大数の法則と中心極限定理] から
1 n ( ℓ n ( θ 0 ± δ ) − ℓ n ( θ 0 ) ) = 1 n ∑ i = 1 n log f ( X i ; θ 0 ± δ ) f ( X i ; θ 0 ) → P K ( θ 0 ± δ ) < 0. \frac1n\bigl(\ell_n(\theta_0\pm\delta)-\ell_n(\theta_0)\bigr)=\frac1n\sum_{i=1}^n\log\frac{f(X_i;\theta_0\pm\delta)}{f(X_i;\theta_0)}\xrightarrow{P}K(\theta_0\pm\delta)<0. n 1 ( ℓ n ( θ 0 ± δ ) − ℓ n ( θ 0 ) ) = n 1 i = 1 ∑ n log f ( X i ; θ 0 ) f ( X i ; θ 0 ± δ ) P K ( θ 0 ± δ ) < 0. したがって、事象 G n ( δ ) = { ℓ n ( θ 0 ) > ℓ n ( θ 0 − δ ) かつ ℓ n ( θ 0 ) > ℓ n ( θ 0 + δ ) } G_n(\delta)=\{\ell_n(\theta_0)>\ell_n(\theta_0-\delta)\ \text{かつ}\ \ell_n(\theta_0)>\ell_n(\theta_0+\delta)\} G n ( δ ) = { ℓ n ( θ 0 ) > ℓ n ( θ 0 − δ ) かつ ℓ n ( θ 0 ) > ℓ n ( θ 0 + δ )} 1 1 1 G n ( δ ) G_n(\delta) G n ( δ ) ℓ n \ell_n ℓ n [ θ 0 − δ , θ 0 + δ ] [\theta_0-\delta,\theta_0+\delta] [ θ 0 − δ , θ 0 + δ ] ℓ n ′ = 0 \ell_n'=0 ℓ n ′ = 0 ℓ n \ell_n ℓ n C 1 C^1 C 1 θ 0 \theta_0 θ 0 θ ^ n ( δ ) \hat\theta_n^{(\delta)} θ ^ n ( δ ) P ( ∣ θ ^ n ( δ ) − θ 0 ∣ < δ ) → 1 P(|\hat\theta_n^{(\delta)}-\theta_0|<\delta)\to1 P ( ∣ θ ^ n ( δ ) − θ 0 ∣ < δ ) → 1 δ k = 1 / k \delta_k=1/k δ k = 1/ k n ≥ N k n\ge N_k n ≥ N k P ( G n ( δ k ) ) ≥ 1 − 1 / k P(G_n(\delta_k))\ge1-1/k P ( G n ( δ k )) ≥ 1 − 1/ k N 1 < N 2 < ⋯ N_1<N_2<\cdots N 1 < N 2 < ⋯ N k ≤ n < N k + 1 N_k\le n<N_{k+1} N k ≤ n < N k + 1 θ ^ n = θ ^ n ( δ k ) \hat\theta_n=\hat\theta_n^{(\delta_k)} θ ^ n = θ ^ n ( δ k ) ε > 0 \varepsilon>0 ε > 0 δ k < ε \delta_k<\varepsilon δ k < ε k k k P ( ∣ θ ^ n − θ 0 ∣ < ε ) ≥ 1 − 1 / k P(|\hat\theta_n-\theta_0|<\varepsilon)\ge1-1/k P ( ∣ θ ^ n − θ 0 ∣ < ε ) ≥ 1 − 1/ k θ ^ n → θ 0 \hat\theta_n\to\theta_0 θ ^ n → θ 0
∎ この節のねらいは、推定の誤差 θ ^ n − θ 0 \hat\theta_n-\theta_0 θ ^ n − θ 0 θ 0 \theta_0 θ 0 θ ^ − θ 0 → 0 \hat\theta-\theta_0\to0 θ ^ − θ 0 → 0 分布収束 の形で述べます。
定理 6.1 (MLE の漸近正規性 ) ✓
(R1)–(R5) のもとで、定理 5.2 の一致する根 θ ^ n \hat\theta_n θ ^ n
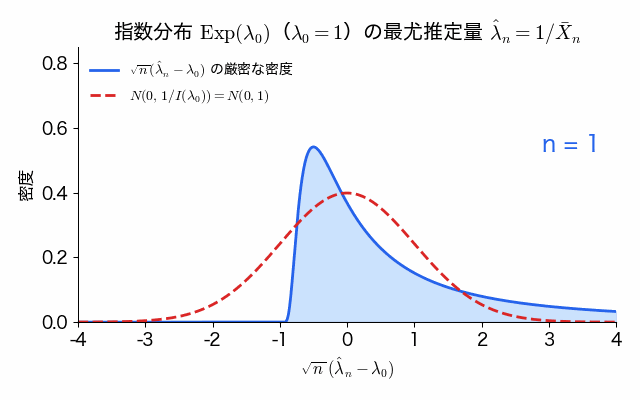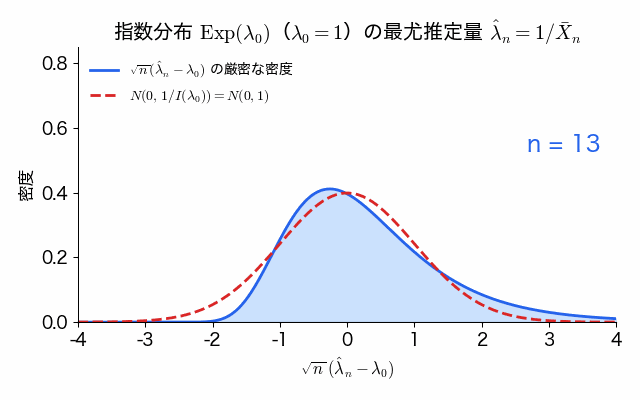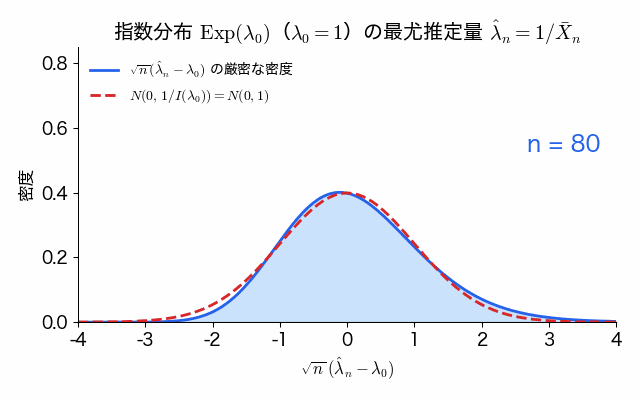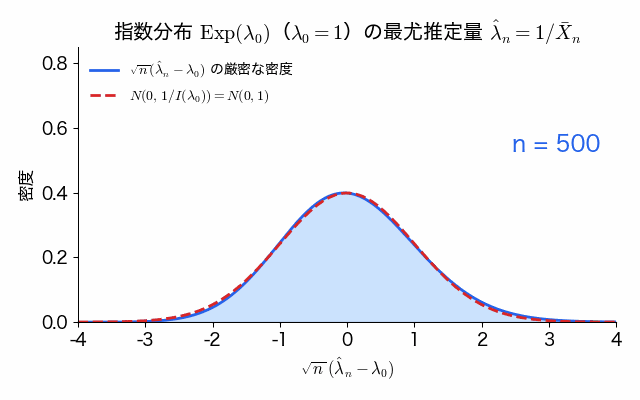
n ( θ ^ n − θ 0 ) → d N ( 0 , 1 I ( θ 0 ) ) . \sqrt n\,(\hat\theta_n-\theta_0)\xrightarrow{d}N\Bigl(0,\frac1{I(\theta_0)}\Bigr). n ( θ ^ n − θ 0 ) d N ( 0 , I ( θ 0 ) 1 ) . 標本数 n n n n ( θ ^ n − θ 0 ) \sqrt n(\hat\theta_n-\theta_0) n ( θ ^ n − θ 0 ) λ ^ n = 1 / X ˉ n \hat\lambda_n=1/\bar X_n λ ^ n = 1/ X ˉ n I ( λ ) = 1 / λ 2 I(\lambda)=1/\lambda^2 I ( λ ) = 1/ λ 2 n n n n n n
指数分布 Exp(1) の最尤推定量について、√n(λ̂ₙ − 1) の厳密な密度(青)と極限の N(0, 1/I) = N(0, 1)(赤の破線)。n = 1 から 500 まで増やす。 証明(定理 6.1) ℓ n \ell_n ℓ n θ 0 \theta_0 θ 0 テイラーの定理(定理 5.3)[平均値の定理とテイラーの定理] 、ラグランジュの剰余)。θ ^ = θ ^ n \hat\theta=\hat\theta_n θ ^ = θ ^ n θ 0 \theta_0 θ 0 θ ∗ \theta^* θ ∗ θ 0 \theta_0 θ 0 θ ^ \hat\theta θ ^
0 = ℓ n ′ ( θ ^ ) = ℓ n ′ ( θ 0 ) + ( θ ^ − θ 0 ) ℓ n ′ ′ ( θ 0 ) + 1 2 ( θ ^ − θ 0 ) 2 ℓ n ′ ′ ′ ( θ ∗ ) . 0=\ell_n'(\hat\theta)=\ell_n'(\theta_0)+(\hat\theta-\theta_0)\ell_n''(\theta_0)+\tfrac12(\hat\theta-\theta_0)^2\ell_n'''(\theta^*). 0 = ℓ n ′ ( θ ^ ) = ℓ n ′ ( θ 0 ) + ( θ ^ − θ 0 ) ℓ n ′′ ( θ 0 ) + 2 1 ( θ ^ − θ 0 ) 2 ℓ n ′′′ ( θ ∗ ) . これを整理して n \sqrt n n
n ( θ ^ − θ 0 ) [ − ℓ n ′ ′ ( θ 0 ) n − 1 2 ( θ ^ − θ 0 ) ℓ n ′ ′ ′ ( θ ∗ ) n ] = ℓ n ′ ( θ 0 ) n . \sqrt n(\hat\theta-\theta_0)\Bigl[-\frac{\ell_n''(\theta_0)}n-\frac12(\hat\theta-\theta_0)\frac{\ell_n'''(\theta^*)}n\Bigr]=\frac{\ell_n'(\theta_0)}{\sqrt n}. n ( θ ^ − θ 0 ) [ − n ℓ n ′′ ( θ 0 ) − 2 1 ( θ ^ − θ 0 ) n ℓ n ′′′ ( θ ∗ ) ] = n ℓ n ′ ( θ 0 ) . 右辺:s ( X i ; θ 0 ) s(X_i;\theta_0) s ( X i ; θ 0 ) 補題 3.2 より平均 0 0 0 I ( θ 0 ) I(\theta_0) I ( θ 0 ) 中心極限定理(定理 5.6)[大数の法則と中心極限定理] により右辺は N ( 0 , I ( θ 0 ) ) N(0,I(\theta_0)) N ( 0 , I ( θ 0 )) − ∂ θ 2 log f ( X i ; θ 0 ) -\partial_\theta^2\log f(X_i;\theta_0) − ∂ θ 2 log f ( X i ; θ 0 ) I ( θ 0 ) I(\theta_0) I ( θ 0 ) I ( θ 0 ) I(\theta_0) I ( θ 0 ) θ ^ \hat\theta θ ^ 1 1 1 ∣ ℓ n ′ ′ ′ ( θ ∗ ) ∣ / n ≤ 1 n ∑ M ( X i ) → P E θ 0 M < ∞ |\ell_n'''(\theta^*)|/n\le\frac1n\sum M(X_i)\xrightarrow{P}E_{\theta_0}M<\infty ∣ ℓ n ′′′ ( θ ∗ ) ∣/ n ≤ n 1 ∑ M ( X i ) P E θ 0 M < ∞ θ ^ − θ 0 → P 0 \hat\theta-\theta_0\xrightarrow{P}0 θ ^ − θ 0 P 0 0 0 0 I ( θ 0 ) > 0 I(\theta_0)>0 I ( θ 0 ) > 0 スルツキーの定理(命題 6.1)[大数の法則と中心極限定理] により
n ( θ ^ − θ 0 ) → d N ( 0 , I ( θ 0 ) ) I ( θ 0 ) = N ( 0 , 1 I ( θ 0 ) ) . \sqrt n(\hat\theta-\theta_0)\xrightarrow{d}\frac{N(0,I(\theta_0))}{I(\theta_0)}=N\Bigl(0,\frac1{I(\theta_0)}\Bigr). n ( θ ^ − θ 0 ) d I ( θ 0 ) N ( 0 , I ( θ 0 )) = N ( 0 , I ( θ 0 ) 1 ) . ∎ したがって MLE の漸近分散は 定理 4.1 の下界 1 / ( n I ) 1/(nI) 1/ ( n I ) 漸近有効 です。多母数でも、n ( θ ^ n − θ 0 ) → N ( 0 , I ( θ 0 ) − 1 ) \sqrt n(\hat\theta_n-\theta_0)\to N(0,I(\theta_0)^{-1}) n ( θ ^ n − θ 0 ) → N ( 0 , I ( θ 0 ) − 1 ) I I I Cramér–Wold の方法(系 4.9)[特性関数と Gauss ベクトル] から従う)で成り立ちます。
例 6.2 (指数分布のレート推定 )
λ ^ = 1 / X ˉ \hat\lambda=1/\bar X λ ^ = 1/ X ˉ I ( λ ) = 1 / λ 2 I(\lambda)=1/\lambda^2 I ( λ ) = 1/ λ 2 n ( λ ^ − λ ) → N ( 0 , λ 2 ) \sqrt n(\hat\lambda-\lambda)\to N(0,\lambda^2) n ( λ ^ − λ ) → N ( 0 , λ 2 ) λ ^ / n \hat\lambda/\sqrt n λ ^ / n n = 100 n=100 n = 100 λ ^ = 2 \hat\lambda=2 λ ^ = 2 0.2 0.2 0.2 95 % 95\% 95% 2 ± 0.4 2\pm0.4 2 ± 0.4 検定と区間推定 で信頼区間として整理します)。
推定したいのが θ \theta θ g ( θ ) g(\theta) g ( θ ) g ( θ ^ n ) g(\hat\theta_n) g ( θ ^ n )
方針は、T n T_n T n θ \theta θ g g g
定理 7.1 (delta 法 ) ✓
確率変数列 T n T_n T n n ( T n − θ ) → d N ( 0 , σ 2 ) \sqrt n(T_n-\theta)\xrightarrow{d}N(0,\sigma^2) n ( T n − θ ) d N ( 0 , σ 2 ) g g g θ \theta θ
n ( g ( T n ) − g ( θ ) ) → d N ( 0 , g ′ ( θ ) 2 σ 2 ) . \sqrt n\bigl(g(T_n)-g(\theta)\bigr)\xrightarrow{d}N\bigl(0,\,g'(\theta)^2\sigma^2\bigr). n ( g ( T n ) − g ( θ ) ) d N ( 0 , g ′ ( θ ) 2 σ 2 ) . 証明(定理 7.1) 微分可能性(ランダウの $o$ 記号(定義 5.4)[平均値の定理とテイラーの定理] で書くと)g ( t ) = g ( θ ) + g ′ ( θ ) ( t − θ ) + r ( t ) ( t − θ ) g(t)=g(\theta)+g'(\theta)(t-\theta)+r(t)(t-\theta) g ( t ) = g ( θ ) + g ′ ( θ ) ( t − θ ) + r ( t ) ( t − θ ) r ( t ) → 0 r(t)\to0 r ( t ) → 0 t → θ t\to\theta t → θ r ( θ ) = 0 r(\theta)=0 r ( θ ) = 0 T n − θ = n − 1 / 2 ⋅ n ( T n − θ ) T_n-\theta=n^{-1/2}\cdot\sqrt n(T_n-\theta) T n − θ = n − 1/2 ⋅ n ( T n − θ ) n ( T n − θ ) \sqrt n(T_n-\theta) n ( T n − θ ) T n → θ T_n\to\theta T n → θ n − 1 / 2 × n^{-1/2}\times n − 1/2 × r r r θ \theta θ r ( T n ) → P 0 r(T_n)\xrightarrow{P}0 r ( T n ) P 0
n ( g ( T n ) − g ( θ ) ) = g ′ ( θ ) n ( T n − θ ) + r ( T n ) ⋅ n ( T n − θ ) . \sqrt n\bigl(g(T_n)-g(\theta)\bigr)=g'(\theta)\sqrt n(T_n-\theta)+r(T_n)\cdot\sqrt n(T_n-\theta). n ( g ( T n ) − g ( θ ) ) = g ′ ( θ ) n ( T n − θ ) + r ( T n ) ⋅ n ( T n − θ ) . 第 2 項は「0 0 0 0 0 0 スルツキーの定理(命題 6.1)[大数の法則と中心極限定理] )。第 1 項は g ′ ( θ ) N ( 0 , σ 2 ) = N ( 0 , g ′ ( θ ) 2 σ 2 ) g'(\theta)N(0,\sigma^2)=N(0,g'(\theta)^2\sigma^2) g ′ ( θ ) N ( 0 , σ 2 ) = N ( 0 , g ′ ( θ ) 2 σ 2 )
∎ 例 7.2 (分散安定化変換 )
(i) ポアソン :n ( X ˉ − λ ) → N ( 0 , λ ) \sqrt n(\bar X-\lambda)\to N(0,\lambda) n ( X ˉ − λ ) → N ( 0 , λ ) g ( x ) = x g(x)=\sqrt x g ( x ) = x g ′ ( λ ) = 1 2 λ g'(\lambda)=\frac1{2\sqrt\lambda} g ′ ( λ ) = 2 λ 1 n ( X ˉ − λ ) → N ( 0 , 1 4 ) \sqrt n(\sqrt{\bar X}-\sqrt\lambda)\to N(0,\tfrac14) n ( X ˉ − λ ) → N ( 0 , 4 1 ) λ \lambda λ X ˉ \sqrt{\bar X} X ˉ λ \lambda λ ベルヌーイ :n ( X ˉ − p ) → N ( 0 , p ( 1 − p ) ) \sqrt n(\bar X-p)\to N(0,p(1-p)) n ( X ˉ − p ) → N ( 0 , p ( 1 − p )) g ( p ) = arcsin p g(p)=\arcsin\sqrt p g ( p ) = arcsin p g ′ ( p ) = 1 2 p ( 1 − p ) g'(p)=\frac1{2\sqrt{p(1-p)}} g ′ ( p ) = 2 p ( 1 − p ) 1 n ( arcsin X ˉ − arcsin p ) → N ( 0 , 1 4 ) \sqrt n(\arcsin\sqrt{\bar X}-\arcsin\sqrt p)\to N(0,\tfrac14) n ( arcsin X ˉ − arcsin p ) → N ( 0 , 4 1 ) 対数オッズ :g ( p ) = log p 1 − p g(p)=\log\frac p{1-p} g ( p ) = log 1 − p p g ′ = 1 p ( 1 − p ) g'=\frac1{p(1-p)} g ′ = p ( 1 − p ) 1 n ( g ^ − g ) → N ( 0 , 1 p ( 1 − p ) ) \sqrt n(\widehat{g}-g)\to N\bigl(0,\frac1{p(1-p)}\bigr) n ( g − g ) → N ( 0 , p ( 1 − p ) 1 ) 1 / ( n p ^ ( 1 − p ^ ) ) \sqrt{1/(n\hat p(1-\hat p))} 1/ ( n p ^ ( 1 − p ^ ))
ここまでの頻度論的 推定は、母数 θ \theta θ ベイズ推定 は、θ \theta θ π \pi π
定義 8.1 (事前分布・事後分布・ベイズ推定量 ) ↗
母数空間 Θ \Theta Θ π \pi π π ( θ ) \pi(\theta) π ( θ ) 事前分布 とし、θ ∼ π \theta\sim\pi θ ∼ π X ∣ θ ∼ f ( ⋅ ∣ θ ) X\mid\theta\sim f(\cdot\mid\theta) X ∣ θ ∼ f ( ⋅ ∣ θ ) x x x θ \theta θ 事後分布 といい、その密度は
π ( θ ∣ x ) = f ( x ∣ θ ) π ( θ ) ∫ f ( x ∣ θ ′ ) π ( θ ′ ) d θ ′ ∝ f ( x ∣ θ ) π ( θ ) \pi(\theta\mid x)=\frac{f(x\mid\theta)\pi(\theta)}{\int f(x\mid\theta')\pi(\theta')\,d\theta'}\ \propto\ f(x\mid\theta)\,\pi(\theta) π ( θ ∣ x ) = ∫ f ( x ∣ θ ′ ) π ( θ ′ ) d θ ′ f ( x ∣ θ ) π ( θ ) ∝ f ( x ∣ θ ) π ( θ ) (ベイズの定理)。損失 L ( θ , d ) L(\theta,d) L ( θ , d ) r ( π , δ ) = E [ L ( θ , δ ( X ) ) ] r(\pi,\delta)=E[L(\theta,\delta(X))] r ( π , δ ) = E [ L ( θ , δ ( X ))] θ \theta θ X X X δ \delta δ ベイズ推定量 という。
ベイズリスクは、損失を事前分布で重みづけして平均したもの、つまり推定量のよさを 1 つの数にまとめたものです。次の定理のねらいは、二乗損失ならその最小を与える推定量が事後平均であることを示すことです。方針は、二乗誤差を「事後平均からのずれ」と「事後平均のまわりのばらつき」に分けることで、そこで条件付き期待値 の直交射影としての性質を使います。
定理 8.2 (二乗損失のベイズ推定量は事後平均 ) ✓
二乗損失 L ( θ , d ) = ( θ − d ) 2 L(\theta,d)=(\theta-d)^2 L ( θ , d ) = ( θ − d ) 2 E θ 2 < ∞ E\theta^2<\infty E θ 2 < ∞ θ ^ B ( x ) = E [ θ ∣ X = x ] \hat\theta_B(x)=E[\theta\mid X=x] θ ^ B ( x ) = E [ θ ∣ X = x ] E [ V a r ( θ ∣ X ) ] E[\mathrm{Var}(\theta\mid X)] E [ Var ( θ ∣ X )]
証明(定理 8.2) 任意の推定量 δ ( X ) \delta(X) δ ( X ) 条件付き期待値は直交射影(定理 5.1)[条件付き期待値] より、E [ ( θ − δ ) 2 ] = E [ ( θ − E [ θ ∣ X ] ) 2 ] + E [ ( E [ θ ∣ X ] − δ ( X ) ) 2 ] E[(\theta-\delta)^2]=E[(\theta-E[\theta\mid X])^2]+E[(E[\theta\mid X]-\delta(X))^2] E [( θ − δ ) 2 ] = E [( θ − E [ θ ∣ X ] ) 2 ] + E [( E [ θ ∣ X ] − δ ( X ) ) 2 ] δ − E [ θ ∣ X ] \delta-E[\theta\mid X] δ − E [ θ ∣ X ] X X X 0 0 0 δ \delta δ E [ V a r ( θ ∣ X ) ] E[\mathrm{Var}(\theta\mid X)] E [ Var ( θ ∣ X )] δ = E [ θ ∣ X ] \delta=E[\theta\mid X] δ = E [ θ ∣ X ] 0 0 0
∎ 事前分布と尤度の組合せで事後分布が同じ型の分布になるとき、その事前分布を共役 といいます。
定理 8.3 (ベータ–二項モデル ) ✓
θ = p ∼ B e t a ( a , b ) \theta=p\sim\mathrm{Beta}(a,b) θ = p ∼ Beta ( a , b ) ∝ p a − 1 ( 1 − p ) b − 1 \propto p^{a-1}(1-p)^{b-1} ∝ p a − 1 ( 1 − p ) b − 1 a , b > 0 a,b>0 a , b > 0 X 1 , … , X n ∣ p X_1,\dots,X_n\mid p X 1 , … , X n ∣ p B e r n o u l l i ( p ) \mathrm{Bernoulli}(p) Bernoulli ( p ) t = ∑ x i t=\sum x_i t = ∑ x i B e t a ( a + t , b + n − t ) \mathrm{Beta}(a+t,\ b+n-t) Beta ( a + t , b + n − t )
p ^ B = a + t a + b + n = w ⋅ a a + b + ( 1 − w ) x ˉ , w = a + b a + b + n . \hat p_B=\frac{a+t}{a+b+n}=w\cdot\frac a{a+b}+(1-w)\,\bar x,\qquad w=\frac{a+b}{a+b+n}. p ^ B = a + b + n a + t = w ⋅ a + b a + ( 1 − w ) x ˉ , w = a + b + n a + b . すなわち、事前平均と標本平均(MLE)の重み付き平均で、重みは事前分布の「見かけの標本数」a + b a+b a + b n n n ∣ p ^ B − x ˉ ∣ ≤ a + b n |\hat p_B-\bar x|\le\dfrac{a+b}n ∣ p ^ B − x ˉ ∣ ≤ n a + b
証明(定理 8.3) 事後密度は f ( x ∣ p ) π ( p ) ∝ p t ( 1 − p ) n − t ⋅ p a − 1 ( 1 − p ) b − 1 = p a + t − 1 ( 1 − p ) b + n − t − 1 f(x\mid p)\pi(p)\propto p^t(1-p)^{n-t}\cdot p^{a-1}(1-p)^{b-1}=p^{a+t-1}(1-p)^{b+n-t-1} f ( x ∣ p ) π ( p ) ∝ p t ( 1 − p ) n − t ⋅ p a − 1 ( 1 − p ) b − 1 = p a + t − 1 ( 1 − p ) b + n − t − 1 B e t a ( a + t , b + n − t ) \mathrm{Beta}(a+t,b+n-t) Beta ( a + t , b + n − t ) B e t a ( α , β ) \mathrm{Beta}(\alpha,\beta) Beta ( α , β ) α / ( α + β ) \alpha/(\alpha+\beta) α / ( α + β ) ∫ 0 1 p α ( 1 − p ) β − 1 d p / ∫ 0 1 p α − 1 ( 1 − p ) β − 1 d p = B ( α + 1 , β ) B ( α , β ) = α α + β \int_0^1p^{\alpha}(1-p)^{\beta-1}dp\big/\int_0^1p^{\alpha-1}(1-p)^{\beta-1}dp=\frac{B(\alpha+1,\beta)}{B(\alpha,\beta)}=\frac\alpha{\alpha+\beta} ∫ 0 1 p α ( 1 − p ) β − 1 d p / ∫ 0 1 p α − 1 ( 1 − p ) β − 1 d p = B ( α , β ) B ( α + 1 , β ) = α + β α ベータ関数とガンマ関数の関係(定理 6.2)[広義積分・パラメータ積分とガンマ関数] と Γ ( α + 1 ) = α Γ ( α ) \Gamma(\alpha+1)=\alpha\Gamma(\alpha) Γ ( α + 1 ) = α Γ ( α ) a + t a + b + n \frac{a+t}{a+b+n} a + b + n a + t t = n x ˉ t=n\bar x t = n x ˉ p ^ B − x ˉ = a + t − x ˉ ( a + b + n ) a + b + n = a − x ˉ ( a + b ) a + b + n \hat p_B-\bar x=\frac{a+t-\bar x(a+b+n)}{a+b+n}=\frac{a-\bar x(a+b)}{a+b+n} p ^ B − x ˉ = a + b + n a + t − x ˉ ( a + b + n ) = a + b + n a − x ˉ ( a + b ) 0 ≤ a ≤ a + b 0\le a\le a+b 0 ≤ a ≤ a + b 0 ≤ x ˉ ≤ 1 0\le\bar x\le1 0 ≤ x ˉ ≤ 1 a + b a+b a + b n n n
∎ 系 8.4 (ベイズ推定量の漸近分布 ) ✓
上のモデルで真の値を p 0 ∈ ( 0 , 1 ) p_0\in(0,1) p 0 ∈ ( 0 , 1 ) X i ∼ B e r n o u l l i ( p 0 ) X_i\sim\mathrm{Bernoulli}(p_0) X i ∼ Bernoulli ( p 0 ) n ( p ^ B − p 0 ) → d N ( 0 , p 0 ( 1 − p 0 ) ) \sqrt n(\hat p_B-p_0)\xrightarrow{d}N(0,p_0(1-p_0)) n ( p ^ B − p 0 ) d N ( 0 , p 0 ( 1 − p 0 ))
証明(系 8.4) 定理 8.3 より n ∣ p ^ B − x ˉ ∣ ≤ ( a + b ) / n → 0 \sqrt n|\hat p_B-\bar x|\le(a+b)/\sqrt n\to0 n ∣ p ^ B − x ˉ ∣ ≤ ( a + b ) / n → 0 n ( p ^ B − p 0 ) = n ( X ˉ − p 0 ) + n ( p ^ B − X ˉ ) \sqrt n(\hat p_B-p_0)=\sqrt n(\bar X-p_0)+\sqrt n(\hat p_B-\bar X) n ( p ^ B − p 0 ) = n ( X ˉ − p 0 ) + n ( p ^ B − X ˉ ) 0 0 0 N ( 0 , p 0 ( 1 − p 0 ) ) N(0,p_0(1-p_0)) N ( 0 , p 0 ( 1 − p 0 ))
∎ 例 8.5 (正規分布の平均の共役事前分布 )
X i ∣ θ ∼ N ( θ , σ 2 ) X_i\mid\theta\sim N(\theta,\sigma^2) X i ∣ θ ∼ N ( θ , σ 2 ) σ 2 \sigma^2 σ 2 θ ∼ N ( m , τ 2 ) \theta\sim N(m,\tau^2) θ ∼ N ( m , τ 2 ) exp [ − ( θ − m ) 2 2 τ 2 − n ( x ˉ − θ ) 2 2 σ 2 ] \exp\bigl[-\frac{(\theta-m)^2}{2\tau^2}-\frac{n(\bar x-\theta)^2}{2\sigma^2}\bigr] exp [ − 2 τ 2 ( θ − m ) 2 − 2 σ 2 n ( x ˉ − θ ) 2 ] x ˉ \bar x x ˉ ∝ exp [ − n ( x ˉ − θ ) 2 / 2 σ 2 ] \propto\exp[-n(\bar x-\theta)^2/2\sigma^2] ∝ exp [ − n ( x ˉ − θ ) 2 /2 σ 2 ] θ \theta θ N ( m n , τ n 2 ) N(m_n,\tau_n^2) N ( m n , τ n 2 )
1 τ n 2 = 1 τ 2 + n σ 2 , m n = τ n 2 ( m τ 2 + n x ˉ σ 2 ) . \frac1{\tau_n^2}=\frac1{\tau^2}+\frac n{\sigma^2},\qquad m_n=\tau_n^2\Bigl(\frac m{\tau^2}+\frac{n\bar x}{\sigma^2}\Bigr). τ n 2 1 = τ 2 1 + σ 2 n , m n = τ n 2 ( τ 2 m + σ 2 n x ˉ ) . 精度(分散の逆数)が足し算 になり、事後平均は事前平均と標本平均の精度による重み付き平均です。n → ∞ n\to\infty n → ∞ τ n 2 ≈ σ 2 / n \tau_n^2\approx\sigma^2/n τ n 2 ≈ σ 2 / n m n → x ˉ m_n\to\bar x m n → x ˉ
一般に、事前分布が正の密度をもつ正則なモデルでは、事後分布は n n n N ( θ ^ n , ( n I ( θ ^ n ) ) − 1 ) N(\hat\theta_n,(nI(\hat\theta_n))^{-1}) N ( θ ^ n , ( n I ( θ ^ n ) ) − 1 ) Bernstein–von Mises の定理 。証明は省略します)。頻度論的な漸近理論とベイズ推定が、大標本では同じ結論に到達することの一般的な根拠です。
演習 9.1 易
N ( μ , σ 2 ) N(\mu,\sigma^2) N ( μ , σ 2 ) σ 2 \sigma^2 σ 2 I ( μ ) = 1 / σ 2 I(\mu)=1/\sigma^2 I ( μ ) = 1/ σ 2 X ˉ \bar X X ˉ 定理 4.1 の下界に達することを確かめよ。
解答 log f = − ( x − μ ) 2 2 σ 2 + 定数 \log f=-\frac{(x-\mu)^2}{2\sigma^2}+\text{定数} log f = − 2 σ 2 ( x − μ ) 2 + 定数 s = x − μ σ 2 s=\frac{x-\mu}{\sigma^2} s = σ 2 x − μ I = E [ s 2 ] = σ 2 σ 4 = 1 σ 2 I=E[s^2]=\frac{\sigma^2}{\sigma^4}=\frac1{\sigma^2} I = E [ s 2 ] = σ 4 σ 2 = σ 2 1 1 n I = σ 2 n \frac1{nI}=\frac{\sigma^2}n n I 1 = n σ 2 V a r ( X ˉ ) = σ 2 / n \mathrm{Var}(\bar X)=\sigma^2/n Var ( X ˉ ) = σ 2 / n
演習 9.2 標準
X ˉ \bar X X ˉ B e r n o u l l i ( p ) \mathrm{Bernoulli}(p) Bernoulli ( p ) p ( 1 − p ) p(1-p) p ( 1 − p ) X ˉ ( 1 − X ˉ ) \bar X(1-\bar X) X ˉ ( 1 − X ˉ ) p = 1 2 p=\frac12 p = 2 1 p ≠ 1 2 p\ne\frac12 p = 2 1
解答 g ( x ) = x ( 1 − x ) g(x)=x(1-x) g ( x ) = x ( 1 − x ) g ′ ( p ) = 1 − 2 p g'(p)=1-2p g ′ ( p ) = 1 − 2 p σ 2 = p ( 1 − p ) \sigma^2=p(1-p) σ 2 = p ( 1 − p ) p ≠ 1 2 p\ne\frac12 p = 2 1 定理 7.1 により n ( g ( X ˉ ) − g ( p ) ) → N ( 0 , ( 1 − 2 p ) 2 p ( 1 − p ) ) \sqrt n(g(\bar X)-g(p))\to N(0,(1-2p)^2p(1-p)) n ( g ( X ˉ ) − g ( p )) → N ( 0 , ( 1 − 2 p ) 2 p ( 1 − p )) p = 1 2 p=\frac12 p = 2 1 g ′ = 0 g'=0 g ′ = 0 0 0 0 g ( X ˉ ) − 1 4 = − ( X ˉ − 1 2 ) 2 g(\bar X)-\frac14=-(\bar X-\frac12)^2 g ( X ˉ ) − 4 1 = − ( X ˉ − 2 1 ) 2 n ( g ( X ˉ ) − 1 4 ) = − ( n ( X ˉ − 1 2 ) ) 2 → − 1 4 Z 2 n\bigl(g(\bar X)-\tfrac14\bigr)=-\bigl(\sqrt n(\bar X-\tfrac12)\bigr)^2\to-\tfrac14Z^2 n ( g ( X ˉ ) − 4 1 ) = − ( n ( X ˉ − 2 1 ) ) 2 → − 4 1 Z 2 Z ∼ N ( 0 , 1 ) Z\sim N(0,1) Z ∼ N ( 0 , 1 ) n n n
演習 9.3 標準
定理 8.3 のモデルで a = b = 1 a=b=1 a = b = 1 p ^ B = t + 1 n + 2 \hat p_B=\frac{t+1}{n+2} p ^ B = n + 2 t + 1 p p p X ˉ \bar X X ˉ p ( 1 − p ) n \frac{p(1-p)}n n p ( 1 − p )
解答 E p ^ B = n p + 1 n + 2 E\hat p_B=\frac{np+1}{n+2} E p ^ B = n + 2 n p + 1 b = n p + 1 n + 2 − p = 1 − 2 p n + 2 b=\frac{np+1}{n+2}-p=\frac{1-2p}{n+2} b = n + 2 n p + 1 − p = n + 2 1 − 2 p n p ( 1 − p ) ( n + 2 ) 2 \frac{np(1-p)}{(n+2)^2} ( n + 2 ) 2 n p ( 1 − p ) M S E = n p ( 1 − p ) + ( 1 − 2 p ) 2 ( n + 2 ) 2 \mathrm{MSE}=\frac{np(1-p)+(1-2p)^2}{(n+2)^2} MSE = ( n + 2 ) 2 n p ( 1 − p ) + ( 1 − 2 p ) 2 p = 1 2 p=\frac12 p = 2 1 n / 4 ( n + 2 ) 2 < 1 4 n \frac{n/4}{(n+2)^2}<\frac1{4n} ( n + 2 ) 2 n /4 < 4 n 1 X ˉ \bar X X ˉ p p p 0 0 0 1 1 1 M S E ≈ 1 ( n + 2 ) 2 \mathrm{MSE}\approx\frac1{(n+2)^2} MSE ≈ ( n + 2 ) 2 1 X ˉ \bar X X ˉ ≈ 0 \approx0 ≈ 0 p p p
Erich L. Lehmann and George Casella, Theory of Point Estimation , 2nd ed., Springer, 1998 — 第 6 章(漸近的最適性)、第 5 章(ベイズ推定)。
A. W. van der Vaart, Asymptotic Statistics , Cambridge University Press, 1998 — 第 3 章(delta 法)、第 5 章(M 推定量と MLE)。
Peter J. Bickel and Kjell A. Doksum, Mathematical Statistics , Vol. I, 2nd ed., CRC Press, 2015 — 第 3 章(Cramér–Rao)。
Harald Cramér, Mathematical Methods of Statistics , Princeton University Press, 1946 — MLE の一致性と漸近正規性の古典的な証明。
George Casella and Roger L. Berger, Statistical Inference , 2nd ed., Duxbury, 2002 — 第 7 章、第 10 章。