コンテキストウィンドウとプロンプトキャッシュ:前方一致とコストの式
対象読者: 本テーマ第 1 章(エージェントループ)と、言語モデルの推論(自己回帰生成・KV キャッシュ)の概要を学んだ人。等差数列の和と不等式の計算ができれば十分です。
前提となる記事:エージェントループ:モデル呼び出しとツール使用の反復、推論:自己回帰生成・温度と top-p・KV キャッシュ・量子化
0. この記事の要点
Section titled “0. この記事の要点”AI のエージェントに長い作業を任せると、返事を 1 回もらうたびに、それまでのやり取りの全部が毎回送り直されます。10 回目の質問には、1 回目から 9 回目までの内容も添えられるわけです。このとき、先頭が前回とまったく同じ部分を、安い料金で読み直す仕組みがあります。この記事では、その料金の規則を小さな式にして、どんな使い方だと得になり、どんな変更をすると高くつくのかを、計算で確かめます。
- Claude API は状態を持ちません。エージェントは要求のたびに、ツール定義(モデルが使える道具の説明)・システムプロンプト・それまでのメッセージ列の全体を送り直します。第 1 章で見たとおり、入力の合計はターン数の 2 次で増えます。
- プロンプトキャッシュは、要求の先頭からの部分(プレフィックス)が、最近処理した内容と完全に一致するとき、その部分を安い単価で読み直す仕組みです。料金は、基準の入力単価を 1 として、キャッシュへの書き込みが 倍、読み取りが 倍です。2026-10 時点の公式ドキュメントでは、5 分の有効期間の書き込みが 1.25 倍、1 時間が 2 倍、読み取りは標準で 0.1 倍です。
- 一致は前方一致です。要求の位置 の内容が変わると、 以降はキャッシュから読めません。 より前は影響を受けません。要求がツール定義・システムプロンプト・メッセージ列の順に並ぶので、ツール定義の変更は全体を無効にし、末尾への追記は何も無効にしません。
- 固定部分 とターンごとの追記 の会話では、 回目の要求のコストはキャッシュなしで 、キャッシュありで です。合計はどちらも 2 次ですが、2 次の係数が 倍になります。
- 長さ のプレフィックスを 1 回書いて 回読むと得になるのは のときです。上の倍率では、5 分の有効期間なら 1 回、1 時間なら 2 回読めば元が取れます。
- キャッシュは料金と遅延を下げますが、コンテキストウィンドウの消費は変えません。キャッシュされたプレフィックスもウィンドウを占めます。ウィンドウの上限そのものへの対処は次章で扱います。
倍率・有効期間・モデル名・ウィンドウの大きさは、2026-10-10 に確認した公式ドキュメントの値です。料金は変わるので、使う前に出典のページで確かめてください。命題では倍率を記号 ・ のまま扱います。
第 1 章の 命題 5.2[エージェントループ] は、圧縮をしないループで、 回目のモデル呼び出しの入力トークン数が の 1 次、 回の合計が の 2 次で増えることを示しました。同じ履歴を毎回送り直すからです。100 ターンの作業の最後の要求は、最初の 99 ターンの内容をすべて含みます。そのほとんどは、1 つ前の要求と 1 トークンも違いません。
送り直しが避けられないのは、API が状態を持たないからです。モデルは要求と要求のあいだで何も覚えていません。そこで、「同じ先頭部分をもう一度処理する」ことの料金と時間を下げる仕組みが要ります。それがプロンプトキャッシュです。
なぜ「先頭部分」なのかは、モデルの構造から来ます。自己回帰の言語モデルでは、因果マスクによって、位置 の内部の状態は位置 以前のトークンだけで決まります(定理 6.3[自己注意])。したがって、2 つの入力の先頭の トークンが同じなら、その 位置分の計算結果は同じで、使い回せます(定理 7.2[推論]、定理 7.3[推論])。途中の 1 トークンが違えば、それより後ろの状態はすべて変わります。「前方一致でなければ使い回せない」は、料金の規則である前に、計算の性質です。この記事は、API が公開している料金と一致の規則を出発点にし、サーバの内部でどう実装されているかには立ち入りません。
エージェントを作る側・使う側にとって、この規則は設計の制約になります。要求の中で、何を前に置き、何を後ろに置くか。会話の途中で何を変えると高くつくか。休憩のあとの最初の要求はなぜ遅いのか。どれも、前方一致という 1 つの性質から計算できます。
2. コンテキストウィンドウと要求の構成
Section titled “2. コンテキストウィンドウと要求の構成”モデルごとに定まる正の整数 をコンテキストウィンドウの大きさという。1 回の要求で、モデルに渡す入力のトークン数 と、モデルがその要求に対して生成する出力のトークン数 は、 を満たさなければならない。
公式ドキュメントは、コンテキストウィンドウを「応答を生成するときにモデルが参照できるすべての文章で、応答自身を含む」と説明し、学習データとは別の、モデルの作業記憶に当たるものと述べています。要求の中のすべて(システムプロンプト、messages のすべてのメッセージ、ツール定義)と、そのターンに生成する出力(拡張思考、つまり答える前にモデルが考えを書き出す機能の出力を含む)が数えられます。2026-10 時点の公式ドキュメントでは、ウィンドウの大きさは、列挙されている新しいモデル(Claude Opus 5.5、Claude Sonnet 5.5 など)で 100 万トークン、それ以外のモデルで 20 万トークンです。命題では のまま扱います。
トークンの集合を とする。要求は、モデルの名前 と、トークン列 の組である。 は、ツール定義の部分 、システムプロンプトの部分 、メッセージ列の部分 をこの順につないだ列
である。 について、先頭の トークン を の長さ のプレフィックスという。列 が のプレフィックスであることを と書く。
「ツール定義・システムプロンプト・メッセージ列の順」は、API のドキュメントが、キャッシュのプレフィックスが作られる順序として明記しているものです。実物の要求は構造を持った JSON で、モデルに渡る前にトークン列に直されます。模型では、直したあとの列だけを見ます。
状態を持たない API。 第 1 章のループで、モデル は「メッセージ列を受け取って応答を返す写像」でした。実物でもそのとおりで、 回目の要求は、 回目の要求の内容に、前回の応答とツール結果を足したものです。Claude Code のドキュメントは、メッセージを送るたびに新しい API 要求が作られ、モデルは要求のあいだで何も覚えていないので、文脈の全体(システムプロンプト、プロジェクトの文脈、過去のすべてのメッセージとツール結果、新しいメッセージ)を送り直す、と説明しています。新しい内容は末尾に足されるので、各要求の大部分は 1 つ前の要求と同じです。
出典(確認日 2026-10-10): Context windows、Prompt caching、How Claude Code uses prompt caching。
3. プロンプトキャッシュ:仕様と模型
Section titled “3. プロンプトキャッシュ:仕様と模型”3.1. 公開されている仕様
Section titled “3.1. 公開されている仕様”API のドキュメントが述べるプロンプトキャッシュの規則を、2026-10 時点の値とともに整理します。この小節は事実の引用で、命題ではありません。
印とプレフィックス。 要求の中のブロックに cache_control という印を付けると、その位置がブレークポイントになります。キャッシュの対象は、要求の先頭(ツール定義・システムプロンプト・メッセージ列の順)から、印の付いたブロックまで(そのブロックを含む)の全体です。命中するには、そこまでの内容が完全に一致していなければなりません。明示的なブレークポイントは 1 つの要求に 4 つまで置けます。要求の最上位に印を 1 つ置き、最後のキャッシュ可能なブロックに自動でブレークポイントを置かせる方法(自動キャッシュ)もあります。
さかのぼる範囲。 ブレークポイントの位置そのものが命中しなくても、API はそこから手前へさかのぼって、過去に書かれた項目を探します。調べる位置は、ブレークポイントごとに 20 か所まで(ブレークポイント自身を 1 つ目に数える)です。
有効期間。 キャッシュの項目の有効期間(TTL)は、既定で 5 分です。追加の料金で 1 時間も選べます("cache_control": {"type": "ephemeral", "ttl": "1h"})。キャッシュされた内容が使われるたびに、有効期間は追加料金なしで更新されます。有効期間は、その項目を書いた、または読んだ要求の開始の時点から測られます。
料金。 基準の入力単価に対する倍率は次のとおりです。
| 操作 | 倍率(基準の入力単価 = 1) |
|---|---|
| 5 分の有効期間での書き込み | 1.25 |
| 1 時間の有効期間での書き込み | 2 |
| 読み取り(命中と更新) | 0.1(Claude Opus 5.5 と Claude Sonnet 5.5 では 0.05、Claude Fable 5.1 と Claude Mythos 5.1 では 0.025) |
最小の長さ。 キャッシュできるプレフィックスには、モデルごとに最小のトークン数があります(2026-10 時点の表では、モデルによって 512・1,024・2,048・4,096 のいずれか)。それより短いプレフィックスは、印を付けてもキャッシュされず、エラーにもなりません。
使用量の報告。 応答の usage には 3 つの欄があります。cache_read_input_tokens はキャッシュから読んだトークン数、cache_creation_input_tokens はキャッシュに書いたトークン数、input_tokens はどちらでもない入力(最後のブレークポイントより後ろ)のトークン数です。入力の合計は 3 つの和です。
分離。 キャッシュは組織のあいだで共有されません(提供の経路によっては、組織の中のワークスペースごとにも分かれます)。Claude Code のドキュメントは、モデルごとに別のキャッシュがあり、内容が同じでもモデルを切り替えると全体が再計算される、と述べています。
出典(確認日 2026-10-10): Prompt caching、Pricing(“Prompt caching” の節)、How Claude Code uses prompt caching。
3.2. 模型
Section titled “3.2. 模型”ここでは、3.1 の仕様を計算できる形にします。キャッシュの中身を「どの先頭部分が、いつまで有効か」を書いた対応表と考えるだけです。以下の定義の「部分写像」は、表に載っていない項目は単に未登録のままにしておける対応、という意味です。
有効期間 、書き込みの倍率 、読み取りの倍率 ()を固定する。キャッシュの状態は、モデルの名前 とトークン列 の組(項目)から、期限の時刻への部分写像 である。項目 が時刻 に生きているとは、 が定義されていて であることをいう。
時刻 に、モデル 、トークン列 (長さ )、ブレークポイントの位置 ()の要求を処理すると、次のことが起こるとする。
- 命中の長さ を、時刻 に生きている項目 で、 かつ を満たすものの長さ の最大値と定める。そのような項目が無ければ とする。
- 使用量を、読み取り 、書き込み 、通常の入力 と定める。
- コスト(基準の入力単価を 1 とした入力の料金)を と定める。
- 項目 の期限を にする(新しく書くか、更新する)。 のとき、命中した項目 の期限も にする。
キャッシュを使わない要求のコストは とする。
注意 3.2(模型に入れた仮定)
この模型は、3.1 の仕様を、コストの計算に必要な範囲で単純にしたものです。違いを挙げます。
- さかのぼる範囲を制限していません。 模型は、 以下の長さの生きている項目をすべて見つけるとしています。実物は、ブレークポイントごとに 20 か所までしか調べません。1 回の追記が多数のブロックにまたがる場合は、実物では命中しないことがあり、そのときは途中にもブレークポイントを置く必要があります。
- ブレークポイントを 1 つにしています。 複数のブレークポイントは、それぞれの位置までのプレフィックスを項目として書く、という形で模型に足せます(7 節で、層ごとの印として使います)。
- 最小の長さを無視しています。 プレフィックスはキャッシュできる最小の長さ以上だと仮定します。
- 出力の料金を数えていません。 出力トークンの料金はキャッシュの有無で変わらないので、差の議論には影響しません。
- コストは料金です。 遅延(応答が始まるまでの時間)も同じ向きに動きますが、公式ドキュメントに式として書ける規則が無いので、命題にはしません。
3.3. 前方一致と無効化
Section titled “3.3. 前方一致と無効化”命題 3.3(位置 j の変更は j 以降を無効にし、j より前は影響を受けない)✓
トークン列 と が、ちょうど位置 で初めて食い違うとする。すなわち、 であり、かつ、「 と の両方が長さ 以上で 」または「一方の長さがちょうど で他方の長さが 以上」である。時刻 に生きているモデル の項目が、すべて のプレフィックスであるとする。このとき、時刻 に要求 を処理すると次が成り立つ。
- 命中の長さは である。したがって、 の位置 以降のトークンはキャッシュから読まれない。
- は、生きている項目のうち長さが 以下のものの長さの最大値に等しい。すなわち、 より前の項目は、 が に変わっても命中の候補のまま残る。
直感的には、途中の 1 トークンが違えば、そこから先は別の文章になるので、キャッシュにある先頭部分が新しい要求の先頭部分でもあるのは、食い違いより手前で終わっているものだけ、ということです。証明は、この同値を先に示し、そこから 1 と 2 を読み取ります。
証明(命題 3.3)
生きている項目 をとります。仮定から です。
まず、「 」を示します。 のとき、 で、 から なので、 です。逆に とします。 なので の長さは 以上で、 です。もし なら、 の長さも 以上で 、したがって となります。これは、食い違いの 2 つの場合のどちらにも反します(1 つ目は で、2 つ目は一方の長さが です)。よって です。
(1) 命中の長さ は、 かつ を満たす生きている項目の長さの最大値(無ければ )です。いま示したことから、そのような項目は を満たすので、 です。読み取られるのは だけなので、位置 以降は読まれません。
(2) 同じ同値から、条件「 かつ 」は「 かつ 」、つまり「」と同値です。
Claude Code のドキュメントは、この性質を、一致は厳密で、プレフィックスのどこかが変わるとそれより後ろがすべて再計算され、ファイルごと・区画ごとのキャッシュは無い、と書いています。
要求が の形で、生きている項目がすべて のプレフィックスであるとする。
- が とツール定義の部分の中(位置 )で初めて食い違うならば、 の要求の命中の長さは 未満である。特に、システムプロンプトの部分とメッセージ列の部分は、1 トークンもキャッシュから読まれない。
- (末尾への追記、)ならば、 のプレフィックスである生きている項目は、どれも の要求の命中の候補のままである。特に、項目 が生きていて ならば、命中の長さは である。
証明(系 3.4)
これは、コンテナイメージのビルドキャッシュの前置性(命題 4.2[Docker と Kubernetes])と同じ構造です。あちらでは、命令の列のうちキャッシュに当たるものが先頭からの連続した部分になり、変わった命令より後ろはすべて再実行されました。だから「変わりにくい命令を前に、変わりやすい命令を後ろに」書きます。プロンプトでも同じで、変わりにくいものを前に、変わりやすいものを後ろに置きます。ビルドシステムには、入力が変わっても出力が同じなら下流を再実行しない早期打ち切り(命題 4.5[ビルドと依存関係])がありますが、プロンプトキャッシュにはそれに当たるものがありません。キーが「そこまでの内容の全体」だからです(キーが内容を決めるという健全性は 命題 7.2[ビルドと依存関係] と同じ形で成り立ちます)。
出典(確認日 2026-10-10): Prompt caching、How Claude Code uses prompt caching(“How the cache is organized” の節)。
4. コストの式
Section titled “4. コストの式”4.1. 追記だけの会話
Section titled “4.1. 追記だけの会話”トークン列の列 が追記だけの会話であるとは、各 について、空でない列 があって となることをいう。 の長さを ( は固定部分、 は最初の追記)、()と書き、 と置く。
標準の設定とは、次の条件をいう。 回目の要求は、時刻 ()に、同じモデル で、トークン列 、ブレークポイントの位置 (要求の末尾)で送られる。キャッシュを変えるのはこれらの要求だけで、時刻 には の生きている項目は無い。
固定部分 は、ツール定義・システムプロンプト・最初から文脈にある指示ファイルなどに当たります。 は、 回目の要求で新しく足される分(前回の応答、ツール結果、利用者の新しいメッセージ)です。第 1 章の記号では に当たります(第 1 章の はツール結果のトークン数で、この章の倍率 とは別のものです)。
次の定理は、 回目の要求が 回目の要求の末尾に トークンを足しただけであることを使います。前回の全体 トークンが読み取りになり、足した トークンだけが書き込みになるので、1 回ごとのコストが決まり、それを足し合わせたのが合計の式です。
証明(定理 4.2)
(1) 次の主張 を、 についての帰納法で示します。「 回目の要求を処理した直後、項目 の期限は であり、 の項目は だけである」。
。時刻 に の生きている項目は無いので、命中の長さは です。使用量は読み取り 、書き込み 、通常の入力 で、コストは です。定義の 4 から の期限は になります。キャッシュを変えるのはこの会話の要求だけなので、 が成り立ちます。
とし、 を仮定します。 なので で、項目 は時刻 に生きています。 なので で、長さは です。したがって です。一方、 から、 の項目は のどれかで、その長さは高々 です( なので )。したがって です。使用量は読み取り 、書き込み 、通常の入力 で、コストは です。定義の 4 から の期限は になり、新しく書かれた項目は だけなので が成り立ちます。
(2) キャッシュを使わない要求のコストは、定義から入力の長さ です。
(3) 1 から
です。 なので、 です。両辺を で割ると比の式になります。
3 の等式 は読みやすい形をしています。キャッシュありの合計は、「キャッシュなしの合計を全部 倍にしたもの」に、「すべてのトークンが 1 回ずつ、読み取りではなく書き込みの単価で払われる分の差額 」を足したものです。どのトークンも、最初に現れた要求で 1 回だけ書かれ、あとは読まれるだけです。
証明(系 4.3)
なので、
です。定理 4.2 の 3 から
で、 の係数は です。どちらも の 2 次式で、 の係数 と は正なので、命題 3.5[計算量と O 記法] により です(定義 3.1[計算量と O 記法])。比については、定理 4.2 の 3 から で、
の右辺は で に収束するので、比は に収束します。
キャッシュは、合計が 2 次で増えるという性質そのものは変えません。変えるのは係数です。1 ターンあたりの追記 にかかる単価は から に上がり、送り直しの部分にかかる単価が から に下がります。長い会話では後者が支配的なので、合計はほぼ 倍になります。
例 4.4(10 ターンの比較)
、、、 と置きます。倍率は 2026-10-10 に確認した公式ドキュメントの、5 分の有効期間の書き込みと標準の読み取りの値で、変わりえます。 と は式を見るための仮の値です。単位は「基準の入力単価 × トークン」です。
| 読み取り | 書き込み | コスト(キャッシュあり) | コスト(キャッシュなし) | |
|---|---|---|---|---|
| 1 | 0 | 22,000 | 27,500 | 22,000 |
| 2 | 22,000 | 2,000 | 4,700 | 24,000 |
| 3 | 24,000 | 2,000 | 4,900 | 26,000 |
| 5 | 28,000 | 2,000 | 5,300 | 30,000 |
| 10 | 38,000 | 2,000 | 6,300 | 40,000 |
| 合計(1〜10) | 77,000 | 310,000 |
1 回目だけはキャッシュありのほうが高く()、2 回目からは 5 分の 1 以下です。合計の比は です。定理 4.2 の 3 で確かめると、 で一致します。表の数値は 9 節のコードの出力です。
4.2. 損益分岐
Section titled “4.2. 損益分岐”キャッシュへの書き込みは、ふつうの入力より高くつきます。読まれなければ損です。何回読めば元が取れるかを求めます。
長さ のプレフィックスを、1 回目の要求で書き込み、そのあと 回の要求で(毎回、有効期間の中で)読み取るとする。このプレフィックスにかかるコストは、キャッシュありで 、キャッシュなしで である。したがって
である。(1 回も読まれない)のとき、キャッシュありのほうが だけ高い。
証明(命題 4.5)
キャッシュありでは、1 回目に書き込みで 、あとの 回は読み取りで ずつなので、合計は です。キャッシュなしでは、 回の要求のそれぞれで なので です。 で割ると、、すなわち です。 なので で、両辺を割って を得ます。 のとき、差は です。
固定の費用を払って 1 回あたりの費用を下げ、何回使えば得かを求める、という形は、オンプレミスと従量課金の比較(命題 3.2[クラウドコンピューティング])と同じです。
例 4.6(公開されている倍率での損益分岐)
2026-10-10 に確認した倍率を入れます。
| 書き込み | 読み取り | 得になる最小の | |
|---|---|---|---|
| 1.25(5 分) | 0.1 | 1 | |
| 2(1 時間) | 0.1 | 2 | |
| 1.25(5 分) | 0.05 | 1 | |
| 2(1 時間) | 0.05 | 2 |
5 分の有効期間なら 1 回読めば元が取れ、1 時間なら 2 回読めば元が取れます。料金のページにも、同じ結論が文章で書かれています。エージェントのループでは、各要求のプレフィックスが次の要求で必ず読まれる(有効期間の中で続く限り)ので、条件はほぼいつも満たされます。満たされないのは、書いた直後に会話が終わる場合と、次の要求までに有効期間が切れる場合です。
出典(確認日 2026-10-10): Prompt caching、Pricing(“Prompt caching” の節)。
5. 有効期間
Section titled “5. 有効期間”1 と 2 は、要求の間隔が決まっている場合の話です。3 は、間隔が運しだいで 5 分を超えることがある場合に、5 分と 1 時間のどちらの有効期間が平均して安くなるかを比べます。
下の動画は 分、、 で、要求を時刻 0, 3, 7, 10, 16, 19 分に送る場合の模型の計算です。要求のたびに緑の帯(有効な期間)が延びていき、10 分から 16 分の間隔だけは 5 分を超えるので帯が切れ、5 回目の要求のコストが跳ね上がります。
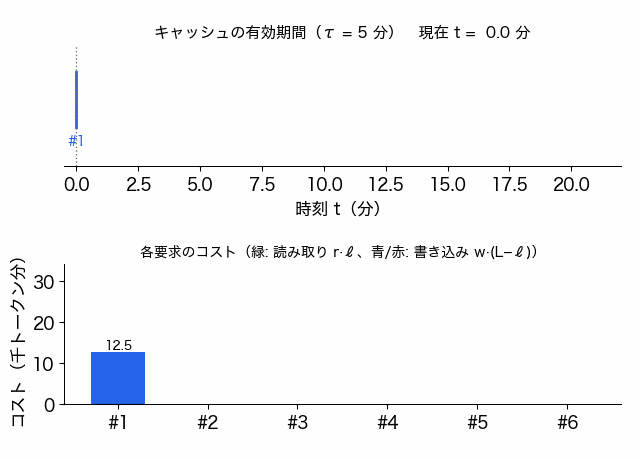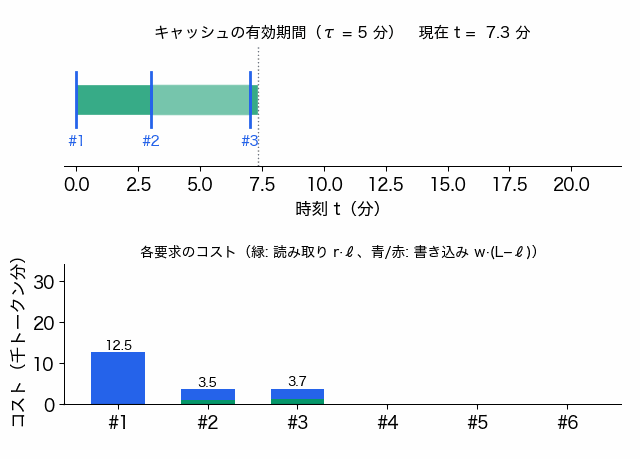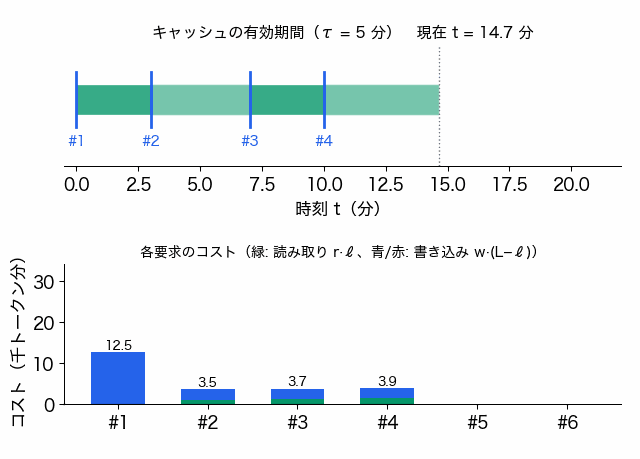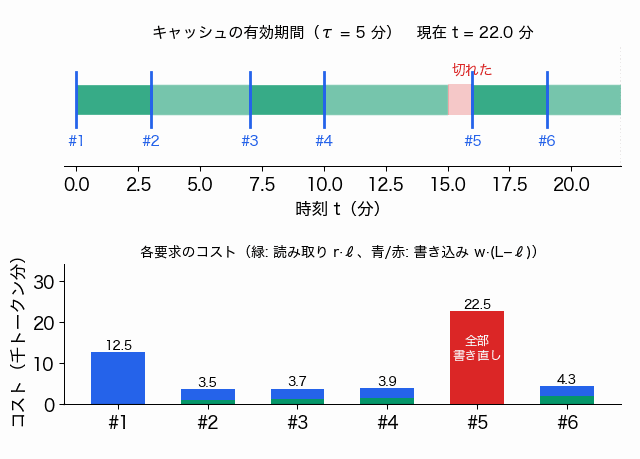
定義 4.1 の標準の設定で、次が成り立つ。
- すべての について ならば、各 の要求の時点で項目 は生きている。会話がどれだけ長く続いても( が をどれだけ超えても)、キャッシュは切れない。
- ある について、 では で、 とする。このとき 回目の要求の命中の長さは で、コストは である。これは、切れなかった場合のコスト より だけ大きい。
- 2 種類の有効期間 があり、書き込みの倍率が 、読み取りの倍率はどちらも とする。 回目の要求までの間隔 が確率変数で、、 とし、 回目までは切れていないとする。 回目の要求のコストの期待値は、短い有効期間で 、長い有効期間で である。したがって、長い有効期間のほうが期待値が小さいのは
のとき、またそのときに限る。
証明(命題 5.1)
(1) 定理 4.2 の証明の主張 から、 回目の要求の直後に の期限は で、 なので時刻 に生きています。期限は、最初の要求の時刻からではなく、直前の要求の時刻から測られるので、 の大きさは関係しません。
(2) の間隔は 未満なので、定理 4.2 の証明の までが成り立ち、 回目の要求の直後、 の項目は だけです。 の項目 の期限は、最後に書かれたか命中した時刻に を足したもので、 以下です( が命中するのは 回目の要求だけなので、期限は )。 の期限は です。 なので、時刻 にはどれも生きていません。したがって で、書き込みは 、コストは です。 なので、差は です。
(3) 短い有効期間 のもとでは、 のとき(確率 )コストは 、 のとき(確率 )は 2 からコストは です。期待値は
です。長い有効期間 のもとでは、仮定から が確率 で成り立つので、コストはつねに です。2 つを比べると、長いほうが小さいのは 、すなわち のときです。 から なので、割って主張の不等式を得ます。
3 の は模型の仮定で、実際の値は使い方で決まります。式の読み方はこうです。長い有効期間は、毎ターンの追記 に対して の割増しを払う保険で、保険が効くのは、間隔が を超えたときに失うはずだった です。 が よりずっと大きい長い会話では、右辺は小さくなります。、、、、 なら、右辺は です。この数値のもとでは、ターンのあいだの休止の 3.3% 以上が 5 分を超える(1 時間は超えない)なら、1 時間の有効期間のほうが期待値は小さくなります。複数のターンにわたる合計の期待値は、各ターンの期待値の和です(定理 6.3[確率]。間隔どうしが独立でなくても成り立ちます)。
Claude Code のドキュメントは、有効期間の扱いについて、要求を「主な会話」と「それ以外(サブエージェント、つまり仕事の一部を任せる別の会話や、圧縮のための要求など)」の 2 つの区分に分け、区分ごとに既定の有効期間が課金の形態に応じて決まること、利用者が設定と環境変数で区分ごとに 5 分か 1 時間を選べることを説明しています。既定の表は課金の形態に依存して変わりうるので、ここには写しません。同じページは、長い有効期間は、席を外して戻ってくる使い方では得で、5 分を超える休止のない短い作業では、高い書き込みの単価だけがかかる、と述べています。命題 5.1 の 3 は、その損得の境目を式にしたものです。
出典(確認日 2026-10-10): Prompt caching、How Claude Code uses prompt caching(“Cache lifetime” の節)。
6. モデルの切り替えと、末尾に足す設計
Section titled “6. モデルの切り替えと、末尾に足す設計”定義 4.1 の標準の設定で、 回目までの要求はモデル で、間隔は 未満とする。 回目の要求を別のモデル で送り、その時点で、 の生きている項目で のプレフィックスであるものは無いとする。このとき次が成り立つ。
- 回目の要求の命中の長さは で、コストは である。切り替えなかった場合より だけ大きい。
- このような切り替えを 回目の要求で行うと、それらの要求のコストの和は である。
証明(命題 6.1)
コストの単位は、要求を送ったモデルの基準の入力単価です。モデルが違えば単価も違うので、金額で比べるときはそれぞれの単価を掛ける必要があります。この命題が言っているのは、切り替えのたびに、その時点の会話の全長を書き込みの単価で払い直すということです。会話が長くなってからの切り替えほど高くつきます。なお、元のモデルに有効期間の中で戻る場合は、元のモデルの古い項目が生きていれば、そこまでは読めます(命題の仮定「生きている項目が無い」が成り立たない場合です)。
- 追記だけの会話 (定義 4.1)では、 ならば である。特に、連続する 2 つの要求は、長いほうが短いほうをプレフィックスとして含む。
- 追記だけの会話の途中で、 回目の要求を、 の位置 以降を書き換えた列 ( は と位置 で初めて食い違う)にしたとする。標準の設定で、 回目までの間隔は 未満、ブレークポイントは の末尾とすると、この要求のコストは 以上である。
- 同じ場面で、書き換えの代わりに、長さ の通知と新しい内容 を末尾に足した列 ()を送ると、コストは である。
証明(命題 6.2)
2 と 3 の差が、設計の選択を説明します。Claude Code のドキュメントによれば、ファイルの内容が文脈に入るのはモデルがそのファイルを読んだときだけで、読み取りの結果は会話に追記されます。前に読んだファイルがあとで編集されても、履歴の中の過去の読み取り結果はさかのぼって書き換えられず、ファイルが変わったことを知らせる通知が追記され、必要ならモデルが読み直します。3 の方式です。もし 2 の方式(履歴の中の古い内容を新しい内容で置き換える)を採ると、そのファイルを読んだ位置 より後ろの会話がすべて書き込みの単価で払い直しになります。早い段階で読んだファイルほど が小さく、被害が大きくなります。
例 6.3(さかのぼって書き換える場合と、通知を足す場合)
の会話で、位置 から始まる トークンのファイルの内容が古くなったとします。、、次のターンの新しい内容を とします。
書き換える方式で、新しい内容が同じ トークンで先頭から違うとすると、 で、コストは 以上です。通知を足す方式で、通知が トークンなら、コストは です。モデルがファイルを読み直して トークンが次のターンに足されるとしても、追加は で、合わせて です。追記の方式は、古い内容の トークンを文脈に残すぶんウィンドウを余計に使いますが、料金は約 4 分の 1 です。
出典(確認日 2026-10-10): How Claude Code uses prompt caching(“Switching models”・“Editing files in your repository” の節)。
7. Claude Code での並べ方
Section titled “7. Claude Code での並べ方”7.1. 3 つの層
Section titled “7.1. 3 つの層”Claude Code のドキュメントは、前方一致を最大限に生かすために、各要求を、ターンのあいだで変わりにくい内容が先に来るように並べる、と説明し、次の 3 つの層を挙げています(2026-10 時点)。
| 層 | 内容 | 変わるとき |
|---|---|---|
| システムプロンプト | 中核の指示、ツール定義 | 読み込まれたツール定義の集合が変わるとき |
| プロジェクトの文脈 | CLAUDE.md、自動メモリ、範囲指定のない規則 | セッションの開始時、または /clear・/compact のあと |
| 会話 | 利用者のメッセージ、モデルの応答、ツール結果 | 毎ターン |
同じページは、会話の層の変更はシステムプロンプトとプロジェクトの文脈をキャッシュに残し、システムプロンプトの変更は、後ろの内容がすべて別のプレフィックスの後ろに来ることになるので全体を無効にする、と述べています。系 3.4 の 2 と 1 です。層の境目にも項目があれば(注意 3.2 で触れた、複数のブレークポイント)、後ろの層だけが変わったとき、前の層は読み取りで済みます。Claude Code が要求のどのブロックに印を付けているかの一覧は、公開ドキュメントには書かれていません。書かれているのは、この層の順序と、会話の途中に足すシステム文脈のかたまり(ファイルの変更の通知など)に印を付けること、です。ここではそれ以上を推測しません。
7.2. キャッシュを無効にする行為と保つ行為
Section titled “7.2. キャッシュを無効にする行為と保つ行為”公式ドキュメントは、次の要求がキャッシュの一部または全部を外す行為と、キャッシュを保つ行為を一覧にしています。それぞれが 命題 3.3 と「モデルごとに別のキャッシュ」から説明できることを、1 つずつ確かめます(説明の列は、公式ドキュメントが述べる理由を、この記事の命題に対応させたものです)。
| 無効にする行為 | 模型での説明 |
|---|---|
| モデルの切り替え | 項目のキーにモデルが入っている(命題 6.1) |
| effort(モデルにどれだけ深く考えさせるかの設定)の水準の変更(モデルによる) | 多くのモデルでは水準ごとに別のキャッシュになる、とされている。キーが変わるので、モデルの切り替えと同じ形 |
| fast mode を有効にする | キーの一部である要求ヘッダが足される、とされている。キーが変わる |
| MCP サーバ(外部のツールをモデルにつなぐ仕組み)の接続・削除(ツール定義が最初から読み込まれている場合) | ツール定義は先頭の層にある。食い違う位置 が先頭の層の中(系 3.4 の 1) |
| MCP サーバを含むプラグインの有効化・無効化 | 上と同じ |
| ツール全体の deny(ツール定義の遅延読み込みが使えない場合) | 定義が要求から取り除かれる。上と同じ |
| 会話の圧縮 | メッセージの履歴が要約に置き換わるので、会話の層は前の要求とプレフィックスを共有しない。システムプロンプトの層は(再開した会話での例外を除いて)再利用され、プロジェクトの文脈はディスクから読み直されて、開始時から変わっていなければ命中する、とされている |
| 多数の画像の蓄積 | 上限に近づくと古い画像がまとめて取り除かれ、それを含んでいたメッセージが変わる。 はその最も古いメッセージの位置 |
| Claude Code の更新 | システムプロンプトやツール定義がふつう変わる。 は先頭の層の中 |
| 保つ行為 | 模型での説明 |
|---|---|
| リポジトリのファイルの編集 | 過去の読み取り結果は書き換えられず、通知が追記される(命題 6.2 の 3) |
| セッション中の CLAUDE.md の編集 | 開始時に読んだ版が使われ続け、要求は変わらない(だから編集もその時点では反映されない) |
| 権限モードの変更 | システムプロンプトもツール定義も変わらない(plan モードの出入りでモデルが切り替わる設定を使っている場合は、モデルの切り替えになる) |
| 出力スタイルの変更 | 新しい指示が会話のメッセージとして届けられる(追記) |
| スキル・コマンドの呼び出し | 指示が、呼び出した時点の user メッセージとして注入される(追記) |
/recap | 要約がコマンドの出力として追記され、履歴を置き換えない |
/rewind | 会話を以前のターンまで切り詰める。残る列は、以前の要求のプレフィックスそのもの |
| サブエージェントの起動 | サブエージェントは自分のシステムプロンプトとツールで別の会話を始める。親の側には呼び出しと結果が追記されるだけ |
2 つ注意があります。1 つ目は、「保つ」行為の多くが、設定の変更がその場では反映されないことと表裏であることです。CLAUDE.md を編集してもキャッシュが保たれるのは、編集が要求に入らないからで、新しい内容が読み込まれるのは次の /clear・/compact・再起動のときです。前方一致を保つことと、変更をすぐ反映することは、同じ位置については両立しません。2 つ目は、サブエージェントの最初の要求は親のキャッシュを読まないことです。システムプロンプトとツールが違えば先頭から食い違うからです。会話の全体をそのまま引き継いで枝分かれさせる fork は、親と同じプレフィックスを持つので親のキャッシュを読みます。サブエージェントの文脈の扱いは次章で扱います。
圧縮についても、ドキュメントは模型どおりの説明をしています。要約を作るための別の要求は、会話と同じシステムプロンプト・ツール・履歴の末尾に要約の指示を足したもので、キャッシュが生きていればプレフィックスを読み取りで済ませます(系 3.4 の 2)。有効期間を超えた休止のあとでは、履歴の全体が通常の入力として処理されます(命題 5.1 の 2)。
確認の方法。 応答ごとの cache_creation_input_tokens と cache_read_input_tokens を見ます。読み取りが書き込みに対して大きければ、キャッシュは働いています。書き込みが毎ターン大きいままなら、プレフィックスのどこかが毎回変わっています。Claude Code では /usage の表示にも、主な会話のキャッシュの命中の割合が出ます(版の条件があります)。
出典(確認日 2026-10-10): How Claude Code uses prompt caching(“How the cache is organized”・“Actions that invalidate the cache”・“Actions that keep the cache”・“Subagents and the cache”・“Check cache performance” の節)。
8. ウィンドウの上限はキャッシュで変わらない
Section titled “8. ウィンドウの上限はキャッシュで変わらない”証明(命題 8.1)
API のドキュメントは、この点を、キャッシュされたプレフィックスもコンテキストウィンドウを占め、キャッシュはそのトークンに払う額を変えるのであって、数に入るかどうかを変えるのではない、と書いています。したがって、第 1 章の 命題 5.2[エージェントループ] の 3(圧縮なしで続けられる呼び出しの回数の上界)は、キャッシュを使っても同じです。キャッシュは 2 次で増える料金への対処で、1 次で増える 1 回の入力の長さへの対処ではありません。
ウィンドウを超えたときの挙動も公開されています。入力だけでウィンドウを超える要求は、どのモデルでも 400 のエラーになります。入力と max_tokens の和が超える要求は、2026-10 時点のドキュメントによれば、新しいモデルでは受け付けられ、生成が上限に達した時点で stop_reason が model_context_window_exceeded になって止まります(第 1 章の 定義 2.3[エージェントループ])。
注意 8.2(長い文脈についての経験的な注意)
API のドキュメントは、ウィンドウが大きいほどよいとは限らず、トークン数が増えると正確さと想起が落ちる、と述べ、これを context rot と呼んでいます。これは仕組みから導ける命題ではなく、観察に基づく主張です。この記事では定理にせず、出典つきの注意にとどめます。この主張が正しいとすると、ウィンドウに収まっていても、文脈を小さく保つ理由があることになります。それが次章の主題です。
出典(確認日 2026-10-10): Context windows。
9. コード
Section titled “9. コード”9.1. コストの模型(実行済み)
Section titled “9.1. コストの模型(実行済み)”定義 3.1 を Python で書きます。要求を「名前とトークン数を持つ区画の列」で表し、プレフィックスの一致を区画の列の一致で判定します。API は呼びません。仕組みを確かめるための模型で、実物の実装の再現ではありません。
# Python 3.9(標準ライブラリのみ)。プロンプトキャッシュのコストの模型。API は呼ばない。def simulate(requests, w, r, ttl):    """requests: (時刻, モデル, [(区画の名前, トークン数), ...]) の列。印は毎回、要求の末尾に置く。"""    cache, rows = {}, []                      # (モデル, プレフィックス) -> 有効期限    for t, model, segs in requests:        total = sum(n for _, n in segs)        read, hit = 0, None        for i in range(len(segs), 0, -1):     # 生きている最長のプレフィックスを探す            key = (model, tuple(segs[:i]))            if cache.get(key, -1) > t:                read, hit = sum(n for _, n in segs[:i]), key                break        write = total - read        if hit: cache[hit] = t + ttl          # 命中した項目は期限が更新される        cache[(model, tuple(segs))] = t + ttl # 印までのプレフィックスを書き込む        rows.append((read, write, r * read + w * write, total))    return rows
def conversation(turns, gap=60, tools=("tools", 12000), new_tools_from=None,                 pause_before=None, switch_from=None):    reqs, t = [], 0    for k in range(1, turns + 1):        t += 3600 if k == pause_before else gap        tl = ("tools+1", 12500) if new_tools_from and k >= new_tools_from else tools        model = "B" if switch_from and k >= switch_from else "A"        reqs.append((t, model, [tl, ("system", 8000)] + [("turn%d" % i, 2000) for i in range(1, k + 1)]))    return reqs
W, R, TTL = 1.25, 0.1, 300base = simulate(conversation(10), W, R, TTL)print(" k   read  write  cost(cache)  cost(no cache)")for k, (rd, wr, c, tot) in enumerate(base, 1):    print("%2d %6d %6d %12.0f %15d" % (k, rd, wr, c, tot))print("sum %25.0f %15d  ratio %.3f" % (sum(x[2] for x in base), sum(x[3] for x in base),                                        sum(x[2] for x in base) / sum(x[3] for x in base)))s, d, K = 20000, 2000, 10print("closed form:", W * (s + K * d) + R * ((K - 1) * s + d * K * (K - 1) / 2), K * s + d * K * (K + 1) // 2)for label, kw in [("tools changed at k=5", {"new_tools_from": 5}), ("1h pause before k=6", {"pause_before": 6}),                  ("model switch at k=6", {"switch_from": 6})]:    rows = simulate(conversation(10, **kw), W, R, TTL)    k = [i for i, x in enumerate(rows, 1) if x[0] == 0][1]    print("%-21s miss at k=%d: write=%d cost=%.0f | total=%.0f (baseline %.0f)"          % (label, k, rows[k - 1][1], rows[k - 1][2], sum(x[2] for x in rows), sum(x[2] for x in base)))for w, r in [(1.25, 0.1), (2.0, 0.1), (1.25, 0.05), (2.0, 0.05)]:    bound = (w - 1) / (1 - r)    print("w=%.2f r=%.2f: (w-1)/(1-r)=%.3f -> smallest n = %d" % (w, r, bound, int(bound) + 1))L, dd, w1, w2 = 40000, 2000, 1.25, 2.0print("q* = %.4f" % ((w2 - w1) * dd / ((w1 - R) * L)))
実行結果(Python 3.9.6、2026-10-10):
k read write cost(cache) cost(no cache) 1 0 22000 27500 22000 2 22000 2000 4700 24000 3 24000 2000 4900 26000 4 26000 2000 5100 28000 5 28000 2000 5300 30000 6 30000 2000 5500 32000 7 32000 2000 5700 34000 8 34000 2000 5900 36000 9 36000 2000 6100 3800010 38000 2000 6300 40000sum 77000 310000 ratio 0.248closed form: 77000.0 310000tools changed at k=5 miss at k=5: write=30500 cost=38125 | total=110075 (baseline 77000)1h pause before k=6 miss at k=6: write=32000 cost=40000 | total=111500 (baseline 77000)model switch at k=6 miss at k=6: write=32000 cost=40000 | total=111500 (baseline 77000)w=1.25 r=0.10: (w-1)/(1-r)=0.278 -> smallest n = 1w=2.00 r=0.10: (w-1)/(1-r)=1.111 -> smallest n = 2w=1.25 r=0.05: (w-1)/(1-r)=0.263 -> smallest n = 1w=2.00 r=0.05: (w-1)/(1-r)=1.053 -> smallest n = 2q* = 0.0326表の部分は 例 4.4、closed form の行は 系 4.3 の式に を入れた値で、シミュレーションの合計と一致します。そのあとの 3 行は、1 回のキャッシュの外れが合計をどれだけ増やすかを示しています。5 回目の要求でツール定義が 1 つ増える(先頭の区画が から トークンに変わる)と、その要求は トークンの全体が書き込みになり(系 3.4 の 1)、10 回の合計は から に増えます。6 回目の前に有効期間を超える休止があった場合(命題 5.1 の 2)と、6 回目でモデルを切り替えた場合(命題 6.1)は、どちらも トークンの書き込みで、同じ額です。たった 1 回の外れが、10 回分の合計を 4 割以上増やしています。
9.2. Messages API で使用量の 3 つの欄を見る(未実行)
Section titled “9.2. Messages API で使用量の 3 つの欄を見る(未実行)”システムプロンプトにキャッシュの印を付け、同じ要求を 2 回送って、使用量の 3 つの欄を表示するコードです。このコードは執筆時に実行していません(API を呼んでいないので、出力は載せません)。印の書式と欄の名前は、3.1 の出典のページに従っています。API キーは環境変数 ANTHROPIC_API_KEY から SDK が読みます。モデル名の既定値は、2026-10 時点の公式ドキュメントの例に現れる値です(執筆時点の例で、変わりえます)。
# 未実行。pip install anthropic が必要。API キーは環境変数 ANTHROPIC_API_KEY から読まれる。import osimport anthropic
client = anthropic.Anthropic()MODEL = os.environ.get("ANTHROPIC_MODEL", "claude-opus-5-5")   # 執筆時点の公式の例の値
# キャッシュできる最小の長さ(モデルごとに違う)を超える、長い固定の文章を用意する。SYSTEM_TEXT = "\n".join("規約 %d: 変数名は内容が分かる英語の名詞にする。" % i for i in range(1, 801))
def ask(question):    response = client.messages.create(        model=MODEL,        max_tokens=64,        system=[{"type": "text", "text": SYSTEM_TEXT,                 "cache_control": {"type": "ephemeral"}}],     # ここまでがキャッシュの対象        messages=[{"role": "user", "content": question}],    )    u = response.usage    print("input=%d  cache_creation=%d  cache_read=%d"          % (u.input_tokens, u.cache_creation_input_tokens, u.cache_read_input_tokens))
ask("規約は全部でいくつありますか。数だけ答えてください。")ask("規約は全部でいくつありますか。数だけ答えてください。")
仕様どおりなら、1 回目は cache_creation が正で cache_read が 0、有効期間の中で送った 2 回目は cache_read が正で cache_creation が 0 になるはずです(定理 4.2 の と で、追記が印より後ろにだけある場合)。実行して確かめるときの注意が 2 つあります。固定の文章がモデルの最小の長さに満たないと、印を付けてもキャッシュされず、エラーも出ません(両方の欄が 0 のままになります)。また、公式ドキュメントによれば、項目が使えるようになるのは最初の応答が始まってからなので、2 つの要求を同時に送ると 2 つ目も書き込みになります。
出典(確認日 2026-10-10): Prompt caching。
10. 演習
Section titled “10. 演習”、、、 とする。標準の設定で間隔はすべて 未満とする。3 回の要求のコスト と合計 を求め、キャッシュなしの合計 と比べよ。定理 4.2 の 3 の等式で検算せよ。
解答
、、 です。、、 で、 です。キャッシュなしは です。検算: で一致します。3 回でも合計は約半分です。
演習 10.2標準
例 4.4 の会話(、、、、10 ターン)で、システムプロンプトの先頭に「現在の時刻」を毎回書き込む実装にしたとする(時刻は要求ごとに違う)。(1) 各要求の命中の長さとコストを求めよ。(2) 10 回の合計を、キャッシュなしの場合・正しく並べた場合と比べよ。(3) どう直せばよいか。
解答
(1) 回目の要求の列を とすると、 は、それまでのどの要求の列とも位置 で食い違います。命題 3.3 の 1 で なので、命中の長さは 、つまり です。毎回、全体が書き込みになり、コストは です。
(2) 合計は です。キャッシュなしの より高く、正しく並べた場合の の約 5 倍です。キャッシュの印を付けているのに、1 回も読めない書き込みを毎回払っています(命題 4.5 の の場合が毎ターン起きています)。
(3) 変わるものを後ろへ動かします。時刻は、その時点の user メッセージの中(会話の末尾)に書けば、追記になり、それより前のプレフィックスはそのまま読めます。Claude Code のドキュメントが、会話の途中で変わる情報をメッセージとして末尾に足すと説明しているのと同じ考え方です。
演習 10.3標準
9.1 の出力の tools changed at k=5 の行を、手で計算して確かめよ。すなわち、先頭の区画が 5 回目の要求から トークンでなく トークンの別の内容になるとき、(1) 5 回目の要求のコスト、(2) 6〜10 回目の要求のコストの、変更がない場合との差、(3) 10 回の合計を求めよ。
解答
(1) 5 回目の要求の列は、それまでの項目のどれとも先頭の区画の中で食い違うので、命中の長さは です(系 3.4 の 1。この模型では区画が丸ごと変わるので、読めるのは トークンです)。長さは で、コストは です。
(2) 6 回目以降は、新しい列への追記なので、読み取りは 1 つ前の要求の全長です。固定部分が トークン増えたので、読み取りが変更なしの場合より 多く、コストは ずつ高くなります。5 回分で です。
(3) 変更がない場合の合計は 、5 回目のコストは でした。合計は で、出力と一致します。
定義 3.1 を、ブレークポイントを 2 つ持てるように広げる。要求が位置 にブレークポイントを持つとき、命中の長さは 以下の生きている最長の項目の長さ、コストは とし、処理のあと と の両方の期限を にする、と定める。固定部分(長さ )の末尾と要求の末尾にブレークポイントを置いた追記だけの会話を、間隔 未満で 回続けたあと、会話の部分を長さ の要約に置き換えた要求(長さ 、同じ 2 か所にブレークポイント)を、間隔 未満で送る。(1) この要求のコストを求めよ。(2) ブレークポイントが要求の末尾の 1 つだけだった場合のコストと比べよ。
解答
(1) 回目の要求の直後、生きている項目には、固定部分のプレフィックス (毎回、期限が更新されています)があります。要約に置き換えた列 は、 と位置 で初めて食い違うとします(要約の最初のトークンが、元の会話の最初のトークンと違うとします)。命題 3.3 の 2 から、命中の長さは、長さ 以下の生きている項目の最大の長さ、つまり です。コストは です。
(2) ブレークポイントが末尾だけなら、項目は だけで、どの長さも 以上です。命中の長さは 以下でなければならないので で、コストは です。差は です。、、 なら で、固定部分の全体を書き込みの単価で払い直すかどうかの違いです。層の境目に項目を置く意味は、後ろの層が丸ごと入れ替わる操作(圧縮や /clear)のあとでも、前の層を読み取りで済ませられることにあります。Claude Code のドキュメントが、圧縮のあともシステムプロンプトの層は再利用されると述べているのは、この形です。
- Anthropic, Prompt caching, Claude API ドキュメント — プレフィックスの順序、ブレークポイント、有効期間、倍率、最小の長さ、使用量の欄(確認日 2026-10-10)。
- Anthropic, Pricing, Claude API ドキュメント — キャッシュの倍率の表と損益分岐の説明(確認日 2026-10-10)。
- Anthropic, Context windows, Claude API ドキュメント — ウィンドウに数えられるもの、大きさ、超過時の挙動(確認日 2026-10-10)。
- Anthropic, How Claude Code uses prompt caching, Claude Code ドキュメント — 層の順序、キャッシュを無効にする行為と保つ行為、有効期間の区分(確認日 2026-10-10)。
- Anthropic, How Claude Code works および How the agent loop works, Claude Code ドキュメント — 文脈が積み上がること、変わらない部分が自動でキャッシュされること(確認日 2026-10-10)。
- A. Vaswani ほか, “Attention Is All You Need”, Advances in Neural Information Processing Systems 30 (2017). arXiv:1706.03762 — 因果マスクつきの自己注意(プレフィックスの計算が後続のトークンに依らないことの出どころ)。
執筆: Claude Code(Opus 5.5)、Claude Code(Sonnet 5.5)・監査 2 回(Claude Code)・最終 2026-10-12
この記事の誤りを報告する ・運営: 夢現技研合同会社 ・料金 ・利用条件 ・特定商取引法に基づく表記
© 2026 夢現技研合同会社 ・コード例は MIT ライセンスです。