# ビルドと依存関係：依存グラフ・増分ビルドの正しさ・版の解決

> ビルドを入力から成果物への関数とみて、トポロジカル順の存在、増分ビルドとクリーンビルドの一致、早期打ち切り、並列ビルドの時間の上下界、キャッシュのキーの健全性、版の解決の NP 完全性を証明し、最小のビルド系の実行例で確かめる。
> https://rikai.mugen-giken.com/computer-science/software-design-testing/build-systems-and-dependencies

## 0. この記事の要点

ソースを少し直しただけなのに、ビルドが古い結果のまま変わらない。あるいは、念のため全部消して作り直したら数十分かかった。そんな経験はないでしょうか。この記事では、ビルドを「何を読んで何を作るかの対応」として整理し、一部だけ作り直した結果が全部作り直した結果と同じになる条件と、作り直す範囲をどこまで小さくできるかを確かめます。読み終えると、ビルドが信用できなくなる原因と、並列にして速くなる限界、ライブラリの版を固定する理由を説明できるようになります。

- ビルドは「入力ファイルの集合から成果物への関数」です。タスクの出力が**宣言した依存だけ**で決まる（密閉性）なら、依存グラフのどのトポロジカル順で実行しても結果は同じになります（<Ref to="thm-build-correctness" />）。
- 有限の有向グラフがトポロジカル順をもつことと、有向閉路をもたないことは同値で、順序は $O(|V| + |E|)$ 時間で求まります（<Ref to="thm-topological-order" />）。
- 変更された入力から依存グラフで到達できるタスクだけを再実行する増分ビルドは、密閉性のもとでクリーンビルドと同じ結果になります（<Ref to="thm-incremental-correctness" />）。宣言の漏れが 1 つあるだけで、この保証は消えます。
- 内容ハッシュ（[ハッシュ関数](/computer-science/algorithms/searching#def-hash-table)でファイルの中身から計算した短い指紋）で比べると、再実行した出力が前回と同じときに下流を止められます（<Ref to="prop-early-cutoff" />）。出力の内容を見ない方法では、到達可能な集合より小さくは削れません（<Ref to="prop-minimal-rebuild" />）。
- [仕事量](/computer-science/research-computing/parallel-and-gpu-computing#def-work-span)の合計 $W$、最長の依存鎖 $L$ のビルドを $p$ 並列で実行する時間は $\max(W/p, L)$ 以上、貪欲な割り当てで $W/p + L(1 - 1/p)$ 以下です（<Ref to="thm-parallel-build-bound" />）。並列度を $W/L$ より上げても、時間は半分にもなりません。
- 「各パッケージに 1 つの版を選んですべての制約を満たす」問題は NP 完全です（<Ref to="thm-version-resolution-np" />）。ロックファイルは、解決の結果を内容ハッシュつきで固定して、取得を入力の関数にするための記録です（<Ref to="prop-lockfile-determinism" />）。

<Aside type="tip" title="この記事で使う事前知識">

- **有向グラフと歩道**: 頂点を矢印（有向辺）でつないだ図と、矢印をたどってできる道筋。→ [歩道](/computer-science/algorithms/graph-algorithms#def-path)
- **DFS・BFS**: グラフの頂点をたどる 2 通りの探索（深さ優先・幅優先）。→ [グラフアルゴリズム](/computer-science/algorithms/graph-algorithms)
- **ハッシュ関数**: データから固定長の値を計算する関数。同じ内容なら同じ値になる。→ [ハッシュ関数](/computer-science/algorithms/searching#def-hash-table)
- **多項式時間多対一帰着**: 問題 A の答えを、多項式時間で問題 B の答えに読み替える手続き。B が易しければ A も易しい。→ [多項式時間多対一帰着](/computer-science/algorithms/p-vs-np#def-reduction)
- **Git のコミット履歴**: 内容のハッシュで版を指す仕組み（§7 で同じ作りが出る）。→ [バージョン管理システム Git](/computer-science/software-engineering/version-control-git)

</Aside>

## 1. 動機：`make clean` を打つのはなぜか

ビルドが変な結果を出したとき、多くの人は成果物をすべて消して最初から作り直します。それで直ることが多いのは事実ですが、これは「増分ビルドの結果を信用していない」という表明でもあります。信用できない理由を突き止めずに作り直しを習慣にすると、プロジェクトが大きくなったときに 1 回のビルドが数十分になり、テストを走らせる回数が減ります。

この記事の問いは 3 つです。

1. 一部だけを作り直した結果が、全部を作り直した結果と一致するのはどんなときか。
2. 一致を保ったまま、作り直す範囲をどこまで小さくできるか。
3. 自分のコードの外にある依存（ライブラリの版）を、同じ結果になるように固定するにはどうするか。

1970 年代後半に Stuart Feldman が作った Make は、1 の問いに「ファイルの依存関係を書かせ、更新時刻を比べる」という答えを与えました。この方式は今も広く使われていますが、依存の書き漏らしと時刻の比較という 2 つの弱点をもちます。その後のビルドシステム（Bazel、Buck、Nix、Shake など）は、依存の宣言を強制すること（密閉性）と、時刻ではなく内容のハッシュで比べることで、この弱点を塞いできました。以下では、これらの設計がどの定理に支えられているのかを順に確かめます。

テストとの関係も先に述べておきます。[テストの理論](/computer-science/software-design-testing/testing-theory) と [性質ベーステスト](/computer-science/software-design-testing/property-based-testing) で作ったテストは、変更のたびに走らせて初めて役に立ちます。「変更のたびに、必要なものだけを、誰の手元でも同じ結果になるように」走らせる土台がビルドシステムで、それを共有の場所で実行する仕組みが次章の [継続的インテグレーション](/computer-science/software-design-testing/continuous-integration) です。

## 2. 準備：ビルドの模型

グラフの用語（頂点・有向辺・入次数・歩道・閉路・到達可能）は <Ref to="computer-science/algorithms/graph-algorithms#def-graph" /> と <Ref to="computer-science/algorithms/graph-algorithms#def-path" /> のとおりに使います。有向閉路をもたない有向グラフを DAG（directed acyclic graph）と呼びます。

<Definition id="def-build-model" title="ビルドの模型">
次の組を**ビルドの記述**という。

- 有限集合 $I$（**入力**。人が書くソースファイルの名前）と有限集合 $T$（**タスク**。生成されるファイルの名前と同一視する）。$I \cap T = \emptyset$ とし、$N = I \cup T$ とおく。
- 値の集合 $\mathcal{V}$（ファイルの内容になりうるバイト列の全体）。
- 各タスク $t \in T$ に、**宣言された依存** $D(t) \subseteq N$。

有向グラフ $G = (N, E)$、$E = \{(u, t) : t \in T,\ u \in D(t)\}$ を**依存グラフ**という。辺 $(u, t)$ は「$t$ を作るのに $u$ を読む」ことを表す。以下では依存グラフが DAG であるものだけを考える。

写像 $x : I \to \mathcal{V}$ を**入力の状態**、写像 $s : N \to \mathcal{V}$ を**ストア**（作業ディレクトリの中身）という。タスク $t$ を**実行する**とは、ストア $s$ の $t$ の値だけを書き換えて新しいストアにする操作である。
</Definition>

入力は入次数 $0$ の頂点です（$D$ はタスクにしか定めていないので、入力へ向かう辺はありません）。コンパイルの例では、$I$ が `.c` と `.h`、$T$ が `.o` と実行ファイル、$D(\texttt{main.o}) = \{\texttt{main.c}, \texttt{util.h}\}$ といった具合です。

次の密閉性は、「タスクの出力は、宣言した依存の中身だけで決まる」という約束です。たとえば `main.o` を作るコンパイルが、宣言していない `config.h` を読んでいると、`config.h` を書き換えても `main.o` は作り直されません。この失敗は §4.2 の例（宣言の漏れ）で詳しく見ます。

<Definition id="def-hermetic" title="密閉性">
ビルドの記述が**密閉的**（hermetic）であるとは、各タスク $t \in T$ に写像 $f_t : \mathcal{V}^{D(t)} \to \mathcal{V}$ があり、どのストア $s$ のもとで、いつ、どの計算機で $t$ を実行しても、$t$ に書き込まれる値が
$$
f_t\bigl(s|_{D(t)}\bigr)
$$
であることをいう。ここで $s|_{D(t)}$ は $s$ の $D(t)$ への制限である。すなわち、タスクの出力は宣言された依存の現在の値だけの関数である。
</Definition>

密閉性は、プログラミング言語の言葉でいえば、タスクが参照透過な式であること（<Ref to="computer-science/cs-basics/programming-language-theory#def-referential-transparency" />）に当たります。密閉性を破るものは、宣言していないファイルの読み込み（インクルードの漏れ）、環境変数、現在時刻、乱数、ネットワークの先にあるもの、並列に走る別のタスクの途中結果などです。

<Definition id="def-topological-order" title="トポロジカル順">
有限の有向グラフ $G = (V, E)$、$|V| = n$ の**トポロジカル順**とは、全単射 $\sigma : V \to \{1, \ldots, n\}$ であって、すべての辺 $(u, v) \in E$ について $\sigma(u) < \sigma(v)$ を満たすものをいう。
</Definition>

<Definition id="def-clean-incremental" title="クリーンビルドと増分ビルド">
入力の状態 $x$ に対し、ストアの入力の部分を $x$ にしてから、**すべての**タスクを依存グラフのトポロジカル順に 1 回ずつ実行することを**クリーンビルド**という。前回のビルドの結果が残っているストアから始めて、タスクの**一部**だけを実行することを**増分ビルド**という。
</Definition>

<Figure caption="§5 のコード例の依存グラフ。辺は左（読まれる側）から右（読む側）へ向かう。a.md だけを変えたときに到達できるタスクは parse_a・index・page_a・page_b・site の 5 つ">
<svg viewBox="0 0 760 330" width="100%" role="img" aria-label="入力 a.md, b.md, style.css と、タスク parse_a, parse_b, index, page_a, page_b, site の依存グラフ">
  <g fill="none" stroke="currentColor" stroke-width="1.5">
    <rect x="10" y="50" width="100" height="32" rx="4" stroke-dasharray="5 3" />
    <rect x="10" y="200" width="100" height="32" rx="4" stroke-dasharray="5 3" />
    <rect x="330" y="285" width="100" height="32" rx="4" stroke-dasharray="5 3" />
    <rect x="170" y="50" width="100" height="32" rx="4" />
    <rect x="170" y="200" width="100" height="32" rx="4" />
    <rect x="330" y="125" width="100" height="32" rx="4" />
    <rect x="490" y="50" width="100" height="32" rx="4" />
    <rect x="490" y="200" width="100" height="32" rx="4" />
    <rect x="650" y="125" width="100" height="32" rx="4" />
    <line x1="110" y1="66" x2="170" y2="66" />
    <line x1="110" y1="216" x2="170" y2="216" />
    <line x1="270" y1="66" x2="330" y2="132" />
    <line x1="270" y1="216" x2="330" y2="150" />
    <line x1="430" y1="132" x2="490" y2="72" />
    <line x1="430" y1="150" x2="490" y2="210" />
    <path d="M 110 54 C 240 5, 380 5, 490 54" />
    <path d="M 110 228 C 240 272, 380 272, 490 228" />
    <line x1="430" y1="292" x2="520" y2="232" />
    <path d="M 430 300 C 665 300, 645 150, 578 82" />
    <line x1="590" y1="66" x2="650" y2="132" />
    <line x1="590" y1="216" x2="650" y2="150" />
  </g>
  <g fill="currentColor" font-size="14" text-anchor="middle">
    <text x="60" y="71">a.md</text>
    <text x="60" y="221">b.md</text>
    <text x="380" y="306">style.css</text>
    <text x="220" y="71">parse_a</text>
    <text x="220" y="221">parse_b</text>
    <text x="380" y="146">index</text>
    <text x="540" y="71">page_a</text>
    <text x="540" y="221">page_b</text>
    <text x="700" y="146">site</text>
    <text x="60" y="30" font-size="12">入力（破線）</text>
    <text x="700" y="110" font-size="12">成果物</text>
  </g>
</svg>
</Figure>

## 3. トポロジカル順：実行の順序はいつ存在するか

タスクを実行するには、その依存がすでに出来ていなければなりません。全タスクについてこれを満たす実行順がトポロジカル順です。

次の補題は、Kahn の算法が途中で行き詰まったとき、残った頂点の中に閉路があると言うための部品です。直感的には、「どの頂点にも矢印が入ってくる」グラフで矢印を逆にたどり続けると、頂点の数は有限なので、いつか同じ頂点に戻ってくる、ということです。

<Lemma id="lem-source-exists" title="閉路のないグラフには入次数 0 の頂点がある">
$G = (V, E)$ を有限の有向グラフ、$V \ne \emptyset$ とする。すべての頂点の入次数が $1$ 以上ならば、$G$ は有向閉路をもつ。
</Lemma>

<Proof of="lem-source-exists">
$n = |V|$ とおきます。頂点 $v_0$ を 1 つ取ります。$v_0$ の入次数は $1$ 以上なので、$(v_1, v_0) \in E$ となる $v_1$ があります。$v_1$ についても同じで、$(v_2, v_1) \in E$ となる $v_2$ があります。これを繰り返して $v_0, v_1, \ldots, v_n$ を作ります。

添字の集合 $\{0, 1, \ldots, n\}$ は $n + 1$ 個の元をもち、$V$ は $n$ 個なので、写像 $i \mapsto v_i$ は単射ではありません（鳩の巣原理、<Ref to="mathematics/combinatorics/enumeration-generating-functions#thm-pigeonhole" />）。そこで $v_i = v_j$、$i < j$ となる組のうち $j - i$ が最小のものを取ります。このとき $v_i, v_{i+1}, \ldots, v_{j-1}$ は相異なります。もし $v_a = v_b$（$i \le a < b \le j - 1$）なら $b - a < j - i$ となって最小性に反するからです。

列 $(v_j, v_{j-1}, \ldots, v_i)$ は、隣り合う 2 つが辺 $(v_{k+1}, v_k) \in E$ で結ばれた長さ $j - i \ge 1$ の歩道で、始点と終点が等しく、終点を除く頂点が相異なります。これは有向閉路です。
</Proof>

<Theorem id="thm-topological-order" title="トポロジカル順の存在と計算">
$G = (V, E)$ を有限の有向グラフとする。

(a) $G$ がトポロジカル順をもつことと、$G$ が有向閉路をもたないことは同値である。

(b) 次の算法（Kahn の算法）は隣接リスト表現のもとで $O(|V| + |E|)$ 時間で止まる。$G$ が有向閉路をもたなければ全頂点を出力し、出力した順がトポロジカル順になる。有向閉路をもてば、出力されない頂点が残る。

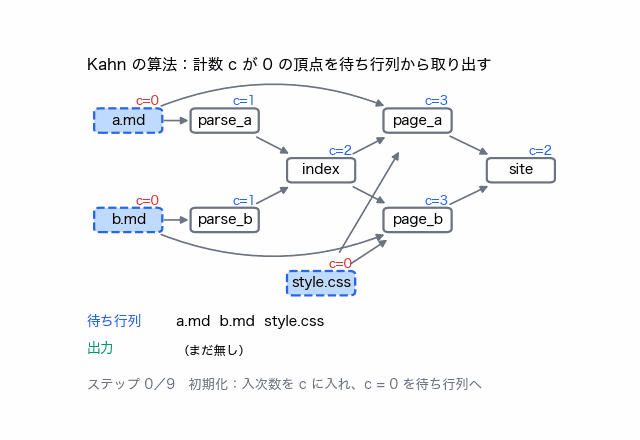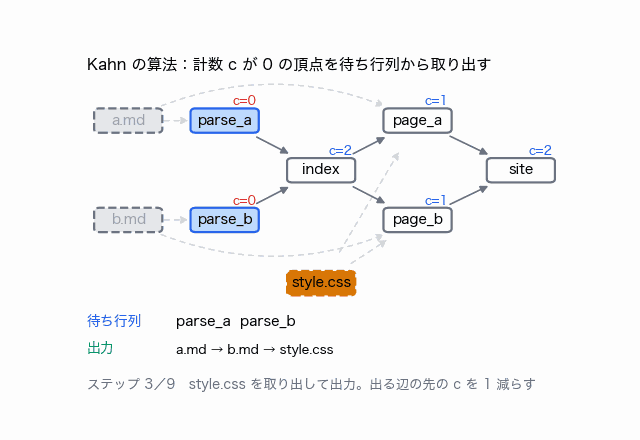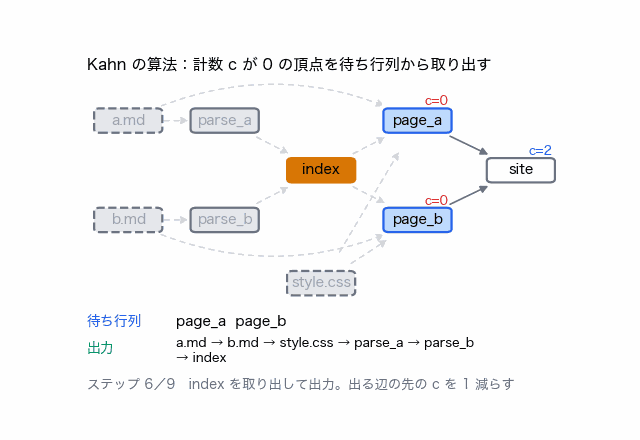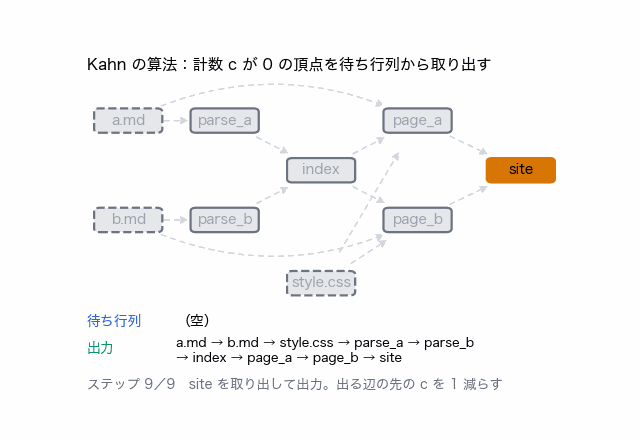
> 各頂点 $v$ の計数 $c[v]$ を入次数で初期化し、$c[v] = 0$ の頂点をすべて待ち行列に入れる。待ち行列が空でないかぎり、頂点 $u$ を 1 つ取り出して出力し、$u$ から出る各辺 $(u, v)$ について $c[v]$ を $1$ 減らし、$0$ になったら $v$ を待ち行列に入れる。

(c) $G$ が有向閉路をもたないとき、深さ優先探索の終了時刻 $f[v]$ の大きい順に頂点を並べたものはトポロジカル順である。これも $O(|V| + |E|)$ 時間で求まる。
</Theorem>

Kahn の算法の証明の方針は、「出力した頂点を取り除いたと思って、残りの入次数を数え直している」ことを不変条件 (K1)〜(K3) で言い直すことです。(K1) は計数が残りの辺の数と合っていること、(K2) は待ち行列が「いま取り出せる頂点」ちょうどであること、(K3) は出力が辺の向きに反していないことを表します。

§2 の依存グラフに Kahn の算法を実際に走らせると、次のように進みます。各頂点の右上の c が計数で、0 になった頂点が待ち行列に入る様子を見てください。

<Figure caption="Kahn の算法を §2 の依存グラフで 1 ステップずつ実行したもの。橙が今回取り出した頂点、青が待ち行列にいる頂点、灰色が出力済みの頂点。出力のたびに、出る辺の先の計数が 1 減る">
<img src="/figures/kahn-queue.gif" alt="入力 3 つが待ち行列に入った状態から始まり、頂点を 1 つ取り出すたびに出る辺の先の計数が減り、0 になった頂点が待ち行列に加わって、最後に site が出力されるまでの動画" loading="lazy" />
</Figure>

<Proof of="thm-topological-order">
**(a) の「もつ ⇒ 閉路がない」。** $\sigma$ をトポロジカル順とし、有向閉路 $(v_0, v_1, \ldots, v_k)$、$k \ge 1$、$v_k = v_0$ があったとします。各辺 $(v_i, v_{i+1})$ について $\sigma(v_i) < \sigma(v_{i+1})$ なので、$\sigma(v_0) < \sigma(v_1) < \cdots < \sigma(v_k) = \sigma(v_0)$ となり矛盾します。

**(b)。** 出力済みの頂点の集合を $O$ と書きます。算法の各反復の前後で、次の 3 つが成り立つことを示します。

- (K1) すべての $v \notin O$ について、$c[v] = \#\{u \notin O : (u, v) \in E\}$。
- (K2) 待ち行列の中身は、$O$ に属さず $c[v] = 0$ である頂点の全体と一致する。同じ頂点が 2 度入ることはない。
- (K3) 出力された列において、どの頂点も、自分へ向かう辺の始点がすべて出力された後に出力されている。

初期状態では $O = \emptyset$ で、$c[v]$ は入次数なので (K1) が成り立ち、(K2) は初期化のとおり、(K3) は列が空なので成り立ちます。反復で $u$ を取り出すとき、(K2) より $c[u] = 0$、(K1) より $u$ へ向かう辺の始点はすべて $O$ に属します。したがって $u$ を出力しても (K3) は保たれます。$u$ を $O$ に加えると、(K1) の右辺は $u$ から辺が出ている先の $v \notin O$ についてちょうど $1$ 減り、算法も同じ $v$ の $c[v]$ を $1$ 減らします（自己ループ $(u, u)$ があるとすると $c[u] \ge 1$ なので $u$ は取り出されません。よって $v \ne u$ です）。$c[v]$ が $0$ になるのは、正の値から $1$ 減らした瞬間の 1 度だけなので、頂点が待ち行列に入るのは高々 1 度で、(K2) が保たれます。

各頂点が待ち行列に入るのは高々 1 度なので、反復は高々 $|V|$ 回で止まります。入次数の計算は全辺を 1 度走査すればよく、$u$ を取り出したときの仕事は $u$ から出る辺の本数に比例します。隣接リスト表現では全辺の走査が $\Theta(|V| + |E|)$ 時間なので（<Ref to="computer-science/algorithms/graph-algorithms#prop-representation-cost" /> (b)）、全体で $O(|V| + |E|)$ 時間です。

止まったとき待ち行列は空です。$R = V \setminus O$ とおきます。$R = \emptyset$ なら全頂点が出力されており、(K3) より、出力の順番を $\sigma$ とすれば各辺 $(u, v)$ について $\sigma(u) < \sigma(v)$ です。$R \ne \emptyset$ なら、(K2) より $R$ のどの頂点も $c[v] \ge 1$ で、(K1) より $R$ の中に自分へ向かう辺の始点をもちます。$G$ を $R$ に制限したグラフはすべての頂点の入次数が $1$ 以上なので、<Ref to="lem-source-exists" /> より有向閉路をもち、それは $G$ の有向閉路でもあります。対偶をとると、$G$ が有向閉路をもたなければ $R = \emptyset$ です。逆に $G$ が有向閉路をもてば、(a) の前半よりトポロジカル順は存在しないので、全頂点が出力されることはありません。

**(a) の「閉路がない ⇒ もつ」。** (b) で、閉路がなければ算法の出力がトポロジカル順になることを示しました。

**(c)。** 深さ優先探索は、頂点を白（未発見）・灰色（走査中）・黒（走査完了）に塗り分け、頂点 $v$ の走査が終わった時刻を $f[v]$ に記録するものとします（<Ref to="computer-science/algorithms/graph-algorithms#lem-dfs-stack" /> と同じ設定）。$G$ が有向閉路をもたないとき、各辺 $(u, v) \in E$ について $f[v] < f[u]$ を示せば十分です。$f$ の大きい順に $1, 2, \ldots$ と番号を振ったものを $\sigma$ とすれば、$\sigma(u) < \sigma(v)$ となるからです。

辺 $(u, v)$ が調べられるのは $u$ の走査中、つまり $u$ が灰色のときです。その瞬間の $v$ の色で場合を分けます。

- $v$ が白のとき。$v$ は $u$ が灰色である間に発見されるので、<Ref to="computer-science/algorithms/graph-algorithms#lem-dfs-stack" /> (b) より $f[v] < f[u]$ です。
- $v$ が灰色のとき。$(u, v)$ は後退辺として記録されます。<Ref to="computer-science/algorithms/graph-algorithms#thm-dfs-cycle" /> より、後退辺が記録されるのは $G$ が有向閉路をもつときに限るので、この場合は起こりません。
- $v$ が黒のとき。$v$ の走査はすでに終わっているので、$f[v]$ は現在の時刻より前です。$u$ はまだ灰色なので $f[u]$ は現在の時刻より後です。よって $f[v] < f[u]$ です。

深さ優先探索の時間は $O(|V| + |E|)$ で（<Ref to="computer-science/algorithms/graph-algorithms#thm-dfs-cycle" />）、頂点を走査が終わった順にリストの先頭へ挿入していけば、整列の手間なしに $f$ の大きい順の列が得られます。
</Proof>

(b) と (c) は同じ問題への 2 つの答えですが、ビルドシステムでの使われ方が違います。Kahn の算法は「いま実行できるタスクの集合」（待ち行列）を明示的にもつので、並列実行に向きます。深さ優先探索は、欲しい成果物から依存をさかのぼるので、「この成果物に必要なタスクだけを作る」のに向きます。閉路があった場合、Kahn の算法は残った頂点の集合を、深さ優先探索は後退辺とその時点の灰色頂点の列（閉路そのもの）を報告できます。

<Example id="ex-latex-cycle" title="依存が巡回する場合：LaTeX の複数回の実行">
LaTeX で相互参照のある文書を組むとき、処理系は補助ファイル（`.aux`）から前回の実行で記録した番号を読み、組版しながら同じ補助ファイルに今回の番号を書き出します。「補助ファイルを作るタスク」が補助ファイル自身に依存するので、依存グラフには自己ループがあり、<Ref to="thm-topological-order" /> (a) よりトポロジカル順は存在しません。

実務では、補助ファイルの内容 $a$ を 1 回の実行で $g(a)$ に写す関数 $g$ を考え、$a_{k+1} = g(a_k)$ を内容が変わらなくなるまで繰り返します。これは不動点 $g(a) = a$ を反復で探しているのであって、DAG の上のビルドとは別の問題です。番号の桁数が変わってページ割りがずれ、それがまた番号を変える、という形で反復が止まらない文書を作ることもできます。閉路を含む依存は、この記事の定理の適用範囲の外にあります。
</Example>

## 4. クリーンビルドと増分ビルドの正しさ

### 4.1. クリーンビルドは関数である

<Theorem id="thm-build-correctness" title="クリーンビルドの一意性">
密閉的なビルドの記述（依存グラフは DAG）と入力の状態 $x : I \to \mathcal{V}$ に対し、次が成り立つ。

(a) 写像 $v_x : N \to \mathcal{V}$ で
$$
v_x(i) = x(i)\ \ (i \in I), \qquad v_x(t) = f_t\bigl(v_x|_{D(t)}\bigr)\ \ (t \in T)
$$
を満たすものがただ 1 つ存在する。

(b) ストアの入力の部分を $x$ にしてから、すべてのタスクを依存グラフのトポロジカル順に 1 回ずつ実行すると、トポロジカル順の選び方によらず、最後のストアは $v_x$ に一致する。

$v_x$ を入力 $x$ に対する**ビルドの結果**と呼ぶ。
</Theorem>

<Proof of="thm-build-correctness">
依存グラフは DAG なので、<Ref to="thm-topological-order" /> (a) よりトポロジカル順が存在します。

**(b) の実行が (a) の条件を満たす写像を与えること。** トポロジカル順 $\sigma$ を 1 つ固定し、その順に実行します。「$\sigma$ の順で $k$ 番目までの頂点 $u$ について、$u$ が入力なら $s(u) = x(u)$、タスクなら実行済みで、以後 $s(u)$ は書き換えられない」ことに注意します。入力はどのタスクの実行でも書き換えられず、各タスクは 1 回しか実行されないからです。

タスク $t$ を実行する時点で、$D(t)$ の各元 $u$ は辺 $(u, t)$ の始点なので $\sigma(u) < \sigma(t)$ を満たし、$u$ がタスクなら実行済みです。したがって $t$ に書き込まれる値は、密閉性（<Ref to="def-hermetic" />）より $f_t(s|_{D(t)})$ で、右辺に現れる $s(u)$ は以後変わりません。全タスクの実行後のストアを $s^{\sigma}$ と書くと、$s^{\sigma}(i) = x(i)$、$s^{\sigma}(t) = f_t(s^{\sigma}|_{D(t)})$ が成り立ちます。これで (a) の存在が示されました。

**(a) の一意性。** $v, v'$ がともに (a) の条件を満たすとします。「$\sigma(u) = k$ である頂点 $u$ について $v(u) = v'(u)$」を $k$ についての完全帰納法（<Ref to="mathematics/foundations/proof-techniques#thm-strong-induction" />）で示します。$\sigma(u) < k$ である頂点では一致していると仮定します。$\sigma(u) = k$ の頂点 $u$ が入力なら $v(u) = x(u) = v'(u)$ です。タスクなら、$D(u)$ の元はすべて $\sigma$ の値が $k$ より小さいので $v|_{D(u)} = v'|_{D(u)}$ で、$v(u) = f_u(v|_{D(u)}) = f_u(v'|_{D(u)}) = v'(u)$ です。

**(b)。** 別のトポロジカル順 $\tau$ で実行した結果 $s^{\tau}$ も、上の議論より (a) の条件を満たします。一意性より $s^{\sigma} = s^{\tau} = v_x$ です。
</Proof>

この定理が言っているのは、密閉性のもとでは「ビルドの結果」が入力 $x$ だけで決まり、実行の順序・並列度・計算機に依存しないということです。$(N, D, f)$ は動的計画法の部分問題族（<Ref to="computer-science/algorithms/dynamic-programming#def-dp-formulation" />）と同じ形をしていて、ビルドは「依存グラフに沿って表を埋める」計算の一種です。

### 4.2. 増分ビルド

前回のビルドのあとで入力の一部を編集したとします。編集された入力から影響を受けうるタスクは、依存グラフの上で到達できるタスクです。

<Theorem id="thm-incremental-correctness" title="増分ビルドの正しさ">
密閉的なビルドの記述（依存グラフ $G$ は DAG）と、入力の状態 $x, x'$ を考える。$C = \{i \in I : x(i) \ne x'(i)\}$ を変更された入力の集合とし、
$$
R = \{t \in T : \text{ある } c \in C \text{ から } t \text{ へ } G \text{ の歩道がある}\}
$$
とおく。ストアが $v_x$（$x$ に対するビルドの結果）である状態から、入力の部分を $x'$ に書き換え、$R$ のタスクだけを $G$ のトポロジカル順に 1 回ずつ実行する。このとき最後のストアは $v_{x'}$ に一致する。
</Theorem>

証明のねらいは、「変更が届くのは、辺をたどって行ける範囲 $R$ だけ」と言うことです。第 1 段では、$R$ の外のタスクは読んでいるものがすべて前回と同じなので、値も同じだと示します。第 2 段では、$R$ の中のタスクを依存の順に作り直せば、どれも新しい正しい値になると示します。

<Proof of="thm-incremental-correctness">
$G$ のトポロジカル順 $\sigma$ を固定します。

**第 1 段：$R$ の外のタスクの値は変わらない。** 「$\sigma(t) = k$ かつ $t \in T \setminus R$ ならば $v_{x'}(t) = v_x(t)$」を $k$ についての完全帰納法（<Ref to="mathematics/foundations/proof-techniques#thm-strong-induction" />）で示します。$t \in T \setminus R$ とし、$u \in D(t)$ を取ります。

- $u$ が入力のとき、$u \notin C$ です。もし $u \in C$ なら、辺 $(u, t)$ が $C$ の元から $t$ への歩道になり、$t \in R$ となってしまうからです。よって $x'(u) = x(u)$、すなわち $v_{x'}(u) = v_x(u)$ です。
- $u$ がタスクのとき、$u \notin R$ です。もし $u \in R$ なら、$C$ の元から $u$ への歩道に辺 $(u, t)$ を継ぎ足して $t \in R$ となるからです。$\sigma(u) < \sigma(t)$ なので、帰納法の仮定より $v_{x'}(u) = v_x(u)$ です。

したがって $v_{x'}|_{D(t)} = v_x|_{D(t)}$ で、<Ref to="thm-build-correctness" /> (a) の等式より
$$
v_{x'}(t) = f_t\bigl(v_{x'}|_{D(t)}\bigr) = f_t\bigl(v_x|_{D(t)}\bigr) = v_x(t)
$$
です。

**第 2 段：再実行したタスクは正しい値になる。** 増分ビルドの開始時のストア $s$ は、入力では $x' = v_{x'}|_I$、$R$ の外のタスクでは $v_x(t) = v_{x'}(t)$（第 1 段）です。$R$ のタスクを $\sigma$ の順に実行します。「$R$ のタスクのうち $\sigma$ の順で $j$ 番目に実行されるタスク $t$ について、実行後 $s(t) = v_{x'}(t)$ となる」ことを $j$ についての完全帰納法で示します。$t$ を実行する時点で、$u \in D(t)$ は、入力であるか、$R$ の外のタスクであるか、$R$ のタスクで $\sigma(u) < \sigma(t)$ を満たすので先に実行されているかのいずれかです。どの場合も $s(u) = v_{x'}(u)$ です（最後の場合は帰納法の仮定）。密閉性より、$t$ に書き込まれる値は $f_t(s|_{D(t)}) = f_t(v_{x'}|_{D(t)}) = v_{x'}(t)$ です。

以上より、最後のストアはすべての頂点で $v_{x'}$ に一致します。
</Proof>

証明で密閉性を使ったのは、「依存の値が同じなら出力も同じ」という 1 点です。ここが崩れる例を見ます。

<Example id="ex-undeclared-header" title="宣言の漏れ：ヘッダファイルを書き忘れた Makefile">
C の小さなプロジェクトで、`main.c` が `config.h` を取り込んでいるのに、Makefile には次のように書いたとします。

```make
app: main.o util.o
	cc -o app main.o util.o
main.o: main.c
	cc -c main.c
util.o: util.c
	cc -c util.c
```

宣言された依存は $D(\texttt{main.o}) = \{\texttt{main.c}\}$ ですが、コンパイラは実際には `config.h` も読みます。`config.h` の定数を書き換えると、$C = \{\texttt{config.h}\}$ から宣言上の依存グラフで到達できるタスクはなく、$R = \emptyset$ です。増分ビルドは何も再実行せず、古い定数で作られた `main.o` が残ります。クリーンビルドは新しい定数で作るので、2 つの結果は一致しません。

この記述は密閉的ではありません。`main.o` の出力が $D(\texttt{main.o})$ に属さない `config.h` に依存しているからです。<Ref to="thm-incremental-correctness" /> の仮定が満たされていないので、結論が成り立たなくても定理には反しません。直し方は、依存に `config.h` を足すか、コンパイラに依存の一覧を出力させて（`cc -MMD`）それを Makefile に取り込むことです。
</Example>

逆に、依存を多めに宣言するのは安全です。

<Proposition id="prop-over-declaration" title="過剰な宣言は正しさを損なわない">
密閉的なビルドの記述 $(I, T, D, f)$ に対し、$D'(t) \supseteq D(t)$ をすべての $t$ について満たす $D'$ で、$D'$ の依存グラフも DAG であるものを取る。このとき $(I, T, D')$ も、$f'_t(a) = f_t(a|_{D(t)})$ によって密閉的であり、ビルドの結果 $v_x$ は $D$ のときと同じである。変更 $C$ に対する再実行の集合は $R' \supseteq R$ となる。
</Proposition>

<Proof of="prop-over-declaration">
タスク $t$ の出力は $f_t(s|_{D(t)})$ で、これは $s|_{D'(t)}$ から $D(t)$ への制限を経て決まるので、$f'_t(s|_{D'(t)}) = f_t(s|_{D(t)})$ と書けます。よって $D'$ についても <Ref to="def-hermetic" /> の条件が成り立ちます。$D$ についてのビルドの結果 $v_x$ は $v_x(t) = f_t(v_x|_{D(t)}) = f'_t(v_x|_{D'(t)})$ を満たすので、<Ref to="thm-build-correctness" /> (a) の一意性より、$D'$ についてのビルドの結果でもあります。$D'$ の依存グラフは $D$ の依存グラフに辺を足したものなので、$C$ から到達できるタスクの集合は小さくなりません。
</Proof>

宣言の漏れは結果を誤らせ、過剰な宣言は再実行を増やすだけです。この非対称性が、「迷ったら依存に入れる」「ビルドシステムの側で宣言していないファイルを読めなくする（サンドボックス）」という設計の根拠です。

### 4.3. 早期打ち切り：内容で比べる

<Ref to="thm-incremental-correctness" /> の $R$ は、「変更が届きうる」タスクの集合です。実際には、コメントだけを直したソースを再コンパイルしても同じ出力が得られることがあり、そのときは下流を作り直す必要がありません。これを使うのが**早期打ち切り**（early cutoff）です。

<Proposition id="prop-early-cutoff" title="内容の比較による早期打ち切り">
<Ref to="thm-incremental-correctness" /> の設定で、次の手続きを考える。ストアが $v_x$ である状態から入力の部分を $x'$ に書き換え、**すべての**タスクを依存グラフのトポロジカル順に 1 つずつ見ていく。タスク $t$ について、$D(t)$ のすべての元 $u$ で現在の値 $s(u)$ が前回の値 $v_x(u)$ に等しければ $t$ を実行せず、そうでなければ実行する。このとき次が成り立つ。

(a) 最後のストアは $v_{x'}$ に一致する。

(b) 実行されるタスクはすべて $R$ に属する。

(c) 値の比較を、$H(s(u)) = H(v_x(u))$ という内容ハッシュの比較で置き換えても、$H$ がビルドに現れる値の集合の上で単射であるかぎり、(a)(b) は変わらない。

特に、あるタスク $t$ を再実行した出力が前回と同じ $v_x(t)$ であれば、$t$ だけを通って変更が届くタスクは再実行されない。
</Proposition>

<Proof of="prop-early-cutoff">
トポロジカル順 $\sigma$ を固定し、「$\sigma$ の順で $k$ 番目までの頂点 $u$ を処理した時点で、それらの $u$ について $s(u) = v_{x'}(u)$ が成り立ち、以後変わらない」ことを $k$ についての完全帰納法（<Ref to="mathematics/foundations/proof-techniques#thm-strong-induction" />）で示します。入力については $s(u) = x'(u) = v_{x'}(u)$ です。タスク $t$ を見るとき、$D(t)$ の元はすべて処理済みなので、帰納法の仮定より $s|_{D(t)} = v_{x'}|_{D(t)}$ です。

- $t$ を実行しない場合。条件より $s|_{D(t)} = v_x|_{D(t)}$ なので、$v_{x'}|_{D(t)} = v_x|_{D(t)}$ です。よって $v_{x'}(t) = f_t(v_{x'}|_{D(t)}) = f_t(v_x|_{D(t)}) = v_x(t)$ で、これはストアに残っている値 $s(t)$ です。
- $t$ を実行する場合。密閉性より、書き込まれる値は $f_t(s|_{D(t)}) = f_t(v_{x'}|_{D(t)}) = v_{x'}(t)$ です。

どちらの場合も $s(t) = v_{x'}(t)$ となり、(a) が示されました。

(b) 「実行されるタスクは $R$ に属する」を、同じく $\sigma$ の順についての完全帰納法で示します。$t$ が実行されるなら、$s(u) \ne v_x(u)$ となる $u \in D(t)$ があります。$u$ が入力なら $x'(u) \ne x(u)$、すなわち $u \in C$ で、辺 $(u, t)$ により $t \in R$ です。$u$ がタスクなら、$u$ は実行されています（実行されなかったタスクの値は $v_x(u)$ のままだからです）。帰納法の仮定より $u \in R$ で、$C$ の元から $u$ への歩道に辺 $(u, t)$ を継ぎ足して $t \in R$ です。

(c) $H$ が単射なら、$H(a) = H(b)$ と $a = b$ は同値なので、手続きの分岐はまったく同じになります。

最後の主張は手続きの定義そのものです。$t$ の出力が $v_x(t)$ のままなら、$t$ を依存にもつタスク $t'$ の判定で $u = t$ は「変わっていない」と数えられ、ほかの依存も変わっていなければ $t'$ は実行されません。
</Proof>

$H$ の単射性は、暗号学的ハッシュ関数の衝突困難性（<Ref to="computer-science/software-engineering/version-control-git#def-content-addressable" />）で置き換えて使います。$b$ ビットのハッシュで $N$ 個の値を扱うとき、どこかで衝突が起きる確率は $N^2 / 2^{b+1}$ 以下です（<Ref to="computer-science/software-engineering/version-control-git#prop-birthday" />）。SHA-256 で $N = 10^{9}$ なら $10^{18} / 2^{257} < 10^{-59}$ で、ハードウェアの誤りの確率よりはるかに小さい値です。

<Example id="ex-mtime-failures" title="更新時刻による判定が誤る場合">
Make の規則は「$t$ が存在しないか、$D(t)$ のどれかの更新時刻が $t$ の更新時刻より新しければ、$t$ を実行する」です。この規則には 3 つの弱点があります。

1. **打ち切れない。** タスク $u$ を再実行すると、出力の内容が同じでも $u$ の更新時刻は新しくなります。$u$ を依存にもつ $t$ は必ず再実行され、その下流もすべて再実行されます。更新時刻は「内容が変わったか」ではなく「書き込まれたか」しか伝えないからです。
2. **古い時刻の付いた新しい内容。** 時計が遅れている計算機で編集したファイルを持ち込んだ場合や、更新時刻を保存する展開（`tar` の既定の動作、`cp -p`）で別の版のソースを上書きした場合、内容は変わっているのに更新時刻が成果物より古くなり、再実行されません。
3. **同じ時刻の書き込み。** 更新時刻の分解能が 1 秒のファイルシステムで、成果物を作った直後の同じ 1 秒のうちにソースをもう一度書き換えると、2 つの更新時刻は等しく、「新しい」とは判定されません。

2 と 3 は、変更が検出されないので、古い成果物が残ります。内容ハッシュによる判定は、時計を使わないので、この 3 つのいずれも起こしません。代わりに、判定のたびにファイルを読んでハッシュを計算する手間がかかります。実装では「大きさと更新時刻が前回と同じならハッシュの計算を省く」という折衷がよく使われますが、これは 2 と 3 の弱点を一部引き継ぎます。
</Example>

早期打ち切りは出力の内容を見ています。内容を見ない方法では、$R$ より小さくはできません。

<Proposition id="prop-minimal-rebuild" title="内容を見ない方法では到達可能集合が最小">
$\mathcal{V}$ を有限バイト列の全体とし、ビルドの記述の形 $(I, T, D)$（依存グラフは DAG）を固定する。変更された入力の集合 $C \subseteq I$ だけから、再実行するタスクの集合 $\rho(C) \subseteq T$ を決める規則 $\rho$ を考える。$\rho$ が、密閉的になるような**すべての** $f = (f_t)_{t \in T}$ と、$\{i : x(i) \ne x'(i)\} = C$ を満たすすべての $x, x'$ について「$v_x$ から始めて入力を $x'$ に書き換え、$\rho(C)$ のタスクをトポロジカル順に実行すると $v_{x'}$ になる」を満たすならば、すべての $C$ について $\rho(C) \supseteq R$ である（$R$ は <Ref to="thm-incremental-correctness" /> のもの）。
</Proposition>

<Proof of="prop-minimal-rebuild">
ある $C$ について $t^{*} \in R \setminus \rho(C)$ があったとして、規則が誤るような $f, x, x'$ を構成します。

$N$ の元に通し番号を付けておき、有限個のバイト列の並び $(a_1, \ldots, a_m)$ を 1 つのバイト列に単射に符号化する写像 $\mathrm{enc}$ を取ります（各 $a_j$ の前にその長さを固定幅で書いて連結すればよい）。各タスク $t$ について
$$
f_t(a) = \mathrm{enc}\bigl((a(u))_{u \in D(t)}\bigr) \qquad (\text{$D(t)$ の元は通し番号の順に並べる})
$$
と定めます。これは依存の値だけの関数なので、密閉的な記述を与えます。入力は、$x(i) = \texttt{0}$（すべての $i$）、$x'(i) = \texttt{1}$（$i \in C$）、$x'(i) = \texttt{0}$（$i \notin C$）とします。

トポロジカル順 $\sigma$ を固定し、「$t \in R$ ならば $v_{x'}(t) \ne v_x(t)$」を $\sigma(t)$ についての完全帰納法（<Ref to="mathematics/foundations/proof-techniques#thm-strong-induction" />）で示します。$t \in R$ なら、ある $c \in C$ から $t$ への歩道 $(u_0 = c, u_1, \ldots, u_k = t)$、$k \ge 1$ があります。最後の辺の始点 $u = u_{k-1}$ は $D(t)$ に属します。$k = 1$ なら $u = c \in C$ で、$v_{x'}(u) = \texttt{1} \ne \texttt{0} = v_x(u)$ です。$k \ge 2$ なら $u$ は $c$ から到達できるタスクなので $u \in R$ で、$\sigma(u) < \sigma(t)$ と帰納法の仮定より $v_{x'}(u) \ne v_x(u)$ です。どちらの場合も、並び $(v_{x'}(u'))_{u' \in D(t)}$ と $(v_x(u'))_{u' \in D(t)}$ は $u$ の成分で異なり、$\mathrm{enc}$ は単射なので $v_{x'}(t) \ne v_x(t)$ です。

$t^{*}$ は再実行されないので、増分ビルドの後もストアの値は $v_x(t^{*})$ のままです。$t^{*} \in R$ なので $v_x(t^{*}) \ne v_{x'}(t^{*})$ で、結果は $v_{x'}$ に一致しません。これは $\rho$ についての仮定に反します。
</Proof>

したがって、「依存グラフと変更されたファイルの一覧」だけで再実行の範囲を決める方式（<Ref to="thm-incremental-correctness" />）はそれ以上削れず、さらに削るには <Ref to="prop-early-cutoff" /> のように出力の内容を見るしかありません。

## 5. 実行例：50 行のビルド系

内容ハッシュと早期打ち切りをもつ最小のビルド系を書いて、§4 の命題が予言する再実行の集合と比べます。題材は、2 つの文書 `a.md`・`b.md` とスタイルシートからページを作る小さなサイトです（§2 の図）。文書は「環境 id の並び `|` 本文」という 1 行で表し、`parse_*` は id の並びだけを取り出し、`index` はそれを集め、`page_*` は本文・索引・スタイルから 1 ページを作ります。タスクは純粋関数で、状態（前回の値と、前回の依存のハッシュ）は JSON にできる[辞書](/computer-science/algorithms/searching#def-dictionary)です。

```python
# Python 3.9.6（標準ライブラリのみ）
import hashlib, json

def h(value):                                   # 内容ハッシュ
    return hashlib.sha256(value.encode()).hexdigest()[:12]

# タスク = (宣言した依存の並び, 純粋関数)。定義した順がトポロジカル順になっている
TASKS = {
    "parse_a": (["a.md"], lambda d: "ids=" + d["a.md"].split("|")[0]),
    "parse_b": (["b.md"], lambda d: "ids=" + d["b.md"].split("|")[0]),
    "index":   (["parse_a", "parse_b"], lambda d: d["parse_a"] + ";" + d["parse_b"]),
    "page_a":  (["a.md", "index", "style.css"], lambda d: "A[" + d["a.md"] + "][" + d["index"] + "][" + d["style.css"] + "]"),
    "page_b":  (["b.md", "index", "style.css"], lambda d: "B[" + d["b.md"] + "][" + d["index"] + "][" + d["style.css"] + "]"),
    "site":    (["page_a", "page_b"], lambda d: d["page_a"] + "+" + d["page_b"]),
}

def build(inputs, state):
    """state: {"values": 名前→値, "keys": タスク→前回の依存ハッシュの並び}。再実行したタスクの一覧を返す"""
    values, keys, ran = dict(inputs), {}, []
    for name, (deps, fn) in TASKS.items():
        key = [h(values[u]) for u in deps]
        if state["keys"].get(name) == key:      # 依存の内容が前回と同じ → 再実行しない
            values[name] = state["values"][name]
        else:
            values[name] = fn({u: values[u] for u in deps})
            ran.append(name)
        keys[name] = key
    state["values"], state["keys"] = values, keys
    return ran

state = {"values": {}, "keys": {}}
src = {"a.md": "thm-x,def-y|本文その一", "b.md": "lem-z|本文その二", "style.css": "serif"}
print("1 回目      :", build(src, state))
print("変更なし    :", build(src, state))
src["a.md"] = "thm-x,def-y|本文を書き直した"          # id の並びは同じで本文だけ変える
print("a.md の本文 :", build(src, state))
src["a.md"] = "thm-x,def-y,cor-w|本文を書き直した"    # id を 1 つ足す
print("a.md の id  :", build(src, state))
src["style.css"] = "sans"
print("style.css   :", build(src, state))
clean = {"values": {}, "keys": {}}
build(src, clean)
print("クリーンビルドと一致:", clean["values"] == state["values"])
```

```text
1 回目      : ['parse_a', 'parse_b', 'index', 'page_a', 'page_b', 'site']
変更なし    : []
a.md の本文 : ['parse_a', 'page_a', 'site']
a.md の id  : ['parse_a', 'index', 'page_a', 'page_b', 'site']
style.css   : ['page_a', 'page_b', 'site']
クリーンビルドと一致: True
```

読み方は次のとおりです。

- `a.md` から到達できるタスクは `parse_a`・`index`・`page_a`・`page_b`・`site` の 5 つで、これが <Ref to="thm-incremental-correctness" /> の $R$ です。
- 本文だけを変えた 3 回目は、`parse_a` を再実行した出力（id の並び）が前回と同じなので、`index` と `page_b` が実行されません。実行された 3 つは $R$ の部分集合で、<Ref to="prop-early-cutoff" /> (b) のとおりです。`page_a` は `a.md` を直接読むので再実行されます。
- id を足した 4 回目は `parse_a` の出力が変わり、`index` を経て `page_b` まで届きます。別の文書の id の追加が `page_b` に届くのは、ページが索引（相互参照の解決の結果）を読むからです。この構造は [事例研究](/computer-science/software-design-testing/case-study-textbook-checks) でもう一度現れます。
- 最後に、増分ビルドを 4 回重ねたストアが、同じ入力のクリーンビルドの結果と一致しています（<Ref to="prop-early-cutoff" /> (a)）。

次に、宣言していない依存を入れます。`page` が、依存に書いていない `footer.txt` を読むようにしたものです（`h` と `build` は上と同じ）。

```python
ENV = {"footer.txt": "(c) 2025"}                 # タスクが宣言せずに読むファイル

TASKS = {
    "page": (["a.md"], lambda d: d["a.md"] + " / " + ENV["footer.txt"]),   # footer.txt を宣言していない
    "site": (["page"], lambda d: "<" + d["page"] + ">"),
}

state = {"values": {}, "keys": {}}
src = {"a.md": "本文"}
build(src, state)
ENV["footer.txt"] = "(c) 2026"                   # 宣言されていない依存だけを変える
print("増分ビルドで再実行:", build(src, state))
clean = {"values": {}, "keys": {}}
build(src, clean)
print("増分  :", state["values"]["site"])
print("クリーン:", clean["values"]["site"])
print("一致:", state["values"] == clean["values"])
```

```text
増分ビルドで再実行: []
増分  : <本文 / (c) 2025>
クリーン: <本文 / (c) 2026>
一致: False
```

増分ビルドは何も再実行せず、古いフッタが残りました。<Ref to="ex-undeclared-header" /> と同じ現象です。上のコードのように、タスクに渡す辞書を宣言した依存だけに限っておけば、宣言していない名前を `d[...]` で読もうとした時点で `KeyError` になります。大域変数や環境を通る読み込みは、この仕組みでは防げません。本物のビルドシステムがサンドボックスを使うのはそのためです。

## 6. 並列ビルドの時間：仕事量と最長の依存鎖

<Ref to="thm-build-correctness" /> より、結果は実行順によらないので、依存のないタスクは同時に実行できます。並列度を上げるとどこまで速くなるかを評価します。

<Theorem id="thm-parallel-build-bound" title="並列ビルドの時間の上下界">
依存グラフが DAG であるビルドの記述で、各タスク $t$ の所要時間を $w_t > 0$ とする。$W = \sum_{t \in T} w_t$ を**仕事量**、タスクだけを通る有向の道 $(t_1, \ldots, t_k)$ についての $\sum_j w_{t_j}$ の最大値 $L$ を**最長の依存鎖**（クリティカルパス）の長さとする。

$p \ge 1$ 台のワーカーによる**スケジュール**とは、各タスク $t$ に開始時刻 $\beta_t \ge 0$ を割り当て、$t$ が区間 $[\beta_t, \beta_t + w_t)$ の間 1 台を占有し、(i) どの時刻にも実行中のタスクは $p$ 個以下、(ii) $u \in D(t) \cap T$ ならば $\beta_u + w_u \le \beta_t$、を満たすものをいう。完了時刻を $\Theta = \max_t (\beta_t + w_t)$ とする。

(a) どのスケジュールも $\Theta \ge \max(W/p,\ L)$ を満たす。

(b) スケジュールが**貪欲**である、すなわち「依存がすべて完了していてまだ開始されていないタスクがある時刻には、$p$ 台すべてが実行中である」ならば、
$$
\Theta \le \frac{W}{p} + L\Bigl(1 - \frac{1}{p}\Bigr)
$$
が成り立つ。

(c) 貪欲なスケジュールの完了時刻は、最適なスケジュールの完了時刻の $(2 - 1/p)$ 倍以下である。
</Theorem>

(b) の証明を時間軸の絵で言うと次のとおりです。まず、最後に終わったタスクから、いつも「最後に終わった依存」を選んでさかのぼり、1 本の依存鎖を作ります。鎖のタスクが動いている時間は少なくとも 1 台が働いていて、その合計は $L$ 以下です。鎖のタスクが動いていない隙間の時間は、貪欲なので全 $p$ 台が埋まっています。この 2 種類の時間で仕事量 $W$ を数えると、完了時刻の上界が出ます。

<Proof of="thm-parallel-build-bound">
時刻 $\tau$ に実行中のタスクの個数を $m(\tau)$ と書きます。$m$ は区分的に定数で、$0 \le m(\tau) \le p$、$\int_0^{\Theta} m(\tau)\, d\tau = \sum_t w_t = W$ です（各タスク $t$ は長さ $w_t$ の区間で $1$ ずつ寄与します）。

**(a)。** $m(\tau) \le p$ より $W = \int_0^{\Theta} m \le p\,\Theta$、すなわち $\Theta \ge W/p$ です。また、$L$ を与える道 $(t_1, \ldots, t_k)$ では $t_j \in D(t_{j+1})$ なので、条件 (ii) より $\beta_{t_j} + w_{t_j} \le \beta_{t_{j+1}}$ です。これを順に使うと $\beta_{t_k} + w_{t_k} \ge \beta_{t_1} + \sum_j w_{t_j} \ge L$ となり、$\Theta \ge L$ です。

**(b)。** 最後に完了するタスクを $t_1$ とします（$\beta_{t_1} + w_{t_1} = \Theta$）。$t_j$ まで決めたとき、$D(t_j) \cap T = \emptyset$ なら止め、そうでなければ $D(t_j) \cap T$ の元のうち完了時刻が最も遅いものを $t_{j+1}$ とします。タスクは有限個で、$t_{j+1}$ から $t_j$ へ辺があるので、DAG の上でこの操作は有限回で止まります。止まったときの添字を $k$ とすると、$(t_k, t_{k-1}, \ldots, t_1)$ はタスクだけを通る有向の道で、$\sum_{j=1}^{k} w_{t_j} \le L$ です。

区間 $[0, \Theta)$ を、鎖のタスクの実行区間 $A_j = [\beta_{t_j}, \beta_{t_j} + w_{t_j})$（$j = 1, \ldots, k$）と、その隙間
$$
B_k = [0, \beta_{t_k}), \qquad B_j = [\beta_{t_{j+1}} + w_{t_{j+1}},\ \beta_{t_j}) \quad (j = 1, \ldots, k-1)
$$
に分けます。条件 (ii) より $\beta_{t_{j+1}} + w_{t_{j+1}} \le \beta_{t_j}$ なので、これらは互いに交わらず、合わせると $[0, \Theta)$ になります。

隙間 $B_j$ の時刻 $\tau$ では、$m(\tau) = p$ です。実際、$j \le k - 1$ のとき、$t_{j+1}$ は $t_j$ の依存のうち最後に完了するものなので、$\tau \ge \beta_{t_{j+1}} + w_{t_{j+1}}$ では $t_j$ の依存はすべて完了しています。$\tau < \beta_{t_j}$ なので $t_j$ はまだ開始されていません。貪欲であることから、この時刻には $p$ 台すべてが実行中です。$j = k$ のときは、$t_k$ がタスクの依存をもたないので、時刻 $0$ から依存はすべて完了しており、同じ結論になります。

鎖の実行区間 $A_j$ の時刻 $\tau$ では、少なくとも $t_j$ が実行中なので $m(\tau) \ge 1$ です。$a = \sum_j w_{t_j}$（$A_j$ の長さの合計）とおくと、隙間の長さの合計は $\Theta - a$ で、
$$
W = \int_0^{\Theta} m(\tau)\, d\tau \ \ge\ p\,(\Theta - a) + 1 \cdot a .
$$
これを $\Theta$ について解くと $\Theta \le W/p + a(1 - 1/p)$ で、$a \le L$ より主張が従います。

**(c)。** 最適なスケジュールの完了時刻を $\Theta^{*}$ とすると、(a) より $W/p \le \Theta^{*}$ かつ $L \le \Theta^{*}$ です。(b) に代入して $\Theta \le \Theta^{*} + \Theta^{*}(1 - 1/p) = (2 - 1/p)\,\Theta^{*}$ です。
</Proof>

(a) と (b) を並べると、並列化の効き方が見えます。$p \le W/L$ の範囲では下界が $W/p$ で、台数にほぼ比例して速くなります。$p \ge W/L$ では下界が $L$ になり、(b) の上界は $L(2 - 1/p)$ 以下、したがって $2L$ 未満なので、**そこから先は台数をいくら増やしても時間は半分にもなりません**。$W/L$ は「このビルドが使い切れる並列度」の目安で、ビルドを速くしたければ、台数を足す前に最長の依存鎖を短くする（大きなタスクを分ける、不要な依存を外す）のが先です。所要時間がすべて $1$ の場合の同じ型の評価（上界は $\lfloor W/p \rfloor + L$ の形）は <Ref to="computer-science/research-computing/parallel-and-gpu-computing#prop-work-span" /> にあります。

貪欲なスケジュールが最適とは限らないことは、演習（<Ref to="exr-greedy-not-optimal" />）で確かめます。

乱数で作った依存グラフで、貪欲なスケジュールの長さを両側の評価と比べます。

```python
# Python 3.9.6（標準ライブラリのみ）／乱数種 20261008
import heapq, random

rng = random.Random(20261008)
n = 300
w = [rng.randint(1, 10) for _ in range(n)]                        # タスクの所要時間
deps = [[u for u in range(max(0, v - 30), v) if rng.random() < 0.06] for v in range(n)]
users = [[] for _ in range(n)]
for v in range(n):
    for u in deps[v]:
        users[u].append(v)

W = sum(w)
longest = [0] * n                                                # v で終わる依存鎖の所要時間の最大
for v in range(n):
    longest[v] = w[v] + max((longest[u] for u in deps[v]), default=0)
L = max(longest)

def greedy(p):
    missing = [len(d) for d in deps]
    ready = [v for v in range(n) if missing[v] == 0]             # 番号の小さい順に取り出す
    heapq.heapify(ready)
    running, now, idle = [], 0, p                                # running: (終了時刻, タスク)
    while ready or running:
        while ready and idle > 0:                                # 空きがあれば実行可能なタスクを始める
            v = heapq.heappop(ready)
            heapq.heappush(running, (now + w[v], v))
            idle -= 1
        now, v = heapq.heappop(running)                          # 次の終了まで時刻を進める
        idle += 1
        for x in users[v]:
            missing[x] -= 1
            if missing[x] == 0:
                heapq.heappush(ready, x)
    return now

print(f"n = {n}, 辺 = {sum(map(len, deps))}, W = {W}, L = {L}, W/L = {W / L:.2f}")
print("  p   下界 max(W/p, L)   貪欲   上界 W/p + L(1-1/p)   貪欲/下界")
for p in (1, 2, 4, 8, 16, 32, 64):
    lo, t, up = max(W / p, L), greedy(p), W / p + L * (1 - 1 / p)
    assert lo <= t <= up
    print(f"{p:3d} {lo:14.1f} {t:10d} {up:16.1f} {t / lo:13.3f}")
```

```text
n = 300, 辺 = 505, W = 1538, L = 206, W/L = 7.47
  p   下界 max(W/p, L)   貪欲   上界 W/p + L(1-1/p)   貪欲/下界
  1         1538.0       1538           1538.0         1.000
  2          769.0        772            872.0         1.004
  4          384.5        387            539.0         1.007
  8          206.0        214            372.5         1.039
 16          206.0        206            289.2         1.000
 32          206.0        206            247.6         1.000
 64          206.0        206            226.8         1.000
```

貪欲なスケジュールの長さは、すべての $p$ で定理の両側の評価の間にあります。$W/L = 7.47$ を超える $p = 8$ 以降は下界が $L = 206$ に張り付き、$p = 16$ 以上では完了時刻が変わりません。この 1 つのグラフでは貪欲な方法が下界にほぼ届いていますが、それは定理が保証することではありません。保証されるのは上界までです。

## 7. キャッシュと再現可能なビルド

増分ビルドは「自分の前回の結果」を再利用します。同じ考えを「誰かがどこかで作った結果」に広げたものがビルドキャッシュです。再利用してよいかどうかを決めるのがキャッシュのキーです。

<Definition id="def-reproducible-build" title="再現可能なビルドとキャッシュのキー">
ビルドが**再現可能**であるとは、同じ入力の状態 $x$ から、いつ・どの計算機で実行しても、ビット単位で同じ成果物が得られることをいう。

各タスク $t$ に、その**定義の直列化** $\delta_t$（実行するコマンド、道具の版、オプションなど、$f_t$ と依存の並びを決める情報を 1 つのバイト列にしたもの）が与えられているとする。$\mathrm{enc}$ をバイト列の並びの単射な符号化、$H$ をハッシュ関数として、ストア $s$ のもとでのタスク $t$ の**キャッシュのキー**を
$$
\kappa(t, s) = H\Bigl(\mathrm{enc}\bigl(\delta_t,\ (H(s(u)))_{u \in D(t)}\bigr)\Bigr)
$$
と定める。キャッシュは、キーから出力の値への対応表である。
</Definition>

密閉的なビルドは、<Ref to="thm-build-correctness" /> より再現可能です。再現可能でないビルドは、密閉性のどこかが破れています。成果物に埋め込まれた日時、ファイルの列挙順、作業ディレクトリの絶対パス、並列実行の順序などが典型です。

<Proposition id="prop-cache-key-soundness" title="キャッシュのキーの健全性">
2 つのビルドの記述（同じものでもよい）がともに密閉的で、定義の直列化が等しいタスクは同じ依存の並びと同じ関数をもつ（$\delta_t = \delta_{t'}$ ならば $f_t = f_{t'}$）とする。$H$ は、現れる値と符号化の全体の上で単射とする。

(a) $\kappa(t, s) = \kappa(t', s')$ ならば、ストア $s$ のもとで $t$ を実行した出力と、ストア $s'$ のもとで $t'$ を実行した出力は等しい。したがって、キャッシュに $\kappa(t, s)$ の項目があればその値を使ってよく、結果は再実行した場合と変わらない。

(b) 入力の状態 $x$ に対し、キーを再帰的に
$$
k_x(i) = H\bigl(\mathrm{enc}(\texttt{input}, x(i))\bigr)\ \ (i \in I), \qquad k_x(t) = H\Bigl(\mathrm{enc}\bigl(\delta_t,\ (k_x(u))_{u \in D(t)}\bigr)\Bigr)\ \ (t \in T)
$$
と定める。$k_x(t) = k_{x'}(t')$ ならば、ビルドの結果について $v_x(t) = v_{x'}(t')$ である。
</Proposition>

<Proof of="prop-cache-key-soundness">
**(a)。** $H$ と $\mathrm{enc}$ は単射なので、$\kappa(t, s) = \kappa(t', s')$ から $\delta_t = \delta_{t'}$ と、依存の並びの各成分について $H(s(u_j)) = H(s'(u'_j))$ が従います。再び $H$ の単射性より $s(u_j) = s'(u'_j)$ です。仮定より $f_t = f_{t'}$ で、引数の並びも等しいので、密閉性（<Ref to="def-hermetic" />）より 2 つの出力は等しくなります。

**(b)。** 頂点 $u$ の**深さ**を、$u$ で終わる歩道の長さの最大値とします（DAG なので有限で、入力の深さは $0$、タスクの深さは依存の深さの最大値に $1$ を足したものです）。「$k_x(u) = k_{x'}(u')$ ならば $v_x(u) = v_{x'}(u')$」を、$u$ の深さについての完全帰納法（<Ref to="mathematics/foundations/proof-techniques#thm-strong-induction" />）で示します。

$H$ と $\mathrm{enc}$ の単射性より、$k_x(u) = k_{x'}(u')$ ならばハッシュする前の並びが等しくなります。$u$ が入力なら、先頭の成分が $\texttt{input}$ なので $u'$ も入力で（タスクの $\delta$ は $\texttt{input}$ と異なるように取っておきます）、$x(u) = x'(u')$、すなわち $v_x(u) = v_{x'}(u')$ です。$u$ がタスクなら、$\delta_u = \delta_{u'}$ で、依存の並びの各成分について $k_x(u_j) = k_{x'}(u'_j)$ です。$u_j$ の深さは $u$ の深さより小さいので、帰納法の仮定より $v_x(u_j) = v_{x'}(u'_j)$ です。$f_u = f_{u'}$ なので、<Ref to="thm-build-correctness" /> (a) の等式より $v_x(u) = f_u\bigl((v_x(u_j))_j\bigr) = f_{u'}\bigl((v_{x'}(u'_j))_j\bigr) = v_{x'}(u')$ です。
</Proof>

(b) のキーは、Git のオブジェクト ID と同じ作り方をしています。子のキーを含めて直列化したものをハッシュするので、キーが一致すれば、そこからさかのぼれる入力とタスクの定義がすべて一致します。これは <Ref to="computer-science/software-engineering/version-control-git#thm-merkle-integrity" /> と同じ構造の主張で、証明も同じ帰納法です。

2 つのキーには使い分けがあります。(b) のキーは、何も実行しなくても入力だけから計算できるので、最終成果物のキーを先に計算して、遠隔のキャッシュから中間生成物を作らずに取ってこられます。(a) のキーは依存の**値**を見るので、<Ref to="prop-early-cutoff" /> の早期打ち切りが効きます（§5 のコードは (a) の方式です）。参照透過な式の同じ出現を 1 つの値で置き換えてよいという <Ref to="computer-science/cs-basics/programming-language-theory#prop-cse" /> を、プロセスと計算機をまたいで行っているのがビルドキャッシュだと言えます。

<Example id="ex-compiler-version-key" title="キーに入れ忘れた入力：コンパイラの版">
$\delta_t$ を「`cc -O2 -c main.c`」というコマンド文字列だけにしたとします。計算機のコンパイラを新しい版に上げると、同じソースから違う機械語が出るようになりますが、キーは変わりません。キャッシュは古いコンパイラで作ったオブジェクトを返し、新しく作ったオブジェクトと混ざった実行ファイルができます。

これは <Ref to="prop-cache-key-soundness" /> の仮定「$\delta_t$ が等しければ $f_t$ が等しい」が破れた例です。コンパイラは、このタスクの宣言されていない依存でした。直し方は、コンパイラの実行ファイルの内容ハッシュ（か、少なくとも版の文字列）を $\delta_t$ に入れることです。同じ理由で、キャッシュに影響しうる環境変数・対象のアーキテクチャ・ビルドシステム自身の版もキーに入れます。
</Example>

<Example id="ex-layer-cache" title="コンテナのレイヤキャッシュは鎖の上の増分ビルド">
コンテナイメージ（<Ref to="computer-science/software-engineering/containers-and-kubernetes#def-image" />）は命令の列 $I_1, \ldots, I_n$ から作られ、$i$ 番目のレイヤは $i - 1$ 番目までの結果と $I_i$ から決まります。依存グラフは 1 本の鎖 $L_1 \to L_2 \to \cdots \to L_n$ で、各 $L_i$ はさらに自分の命令（とコピーするファイル）を入力にもちます。

$j$ 番目の命令を変えると、そこから到達できるタスクは $L_j, L_{j+1}, \ldots, L_n$ です。<Ref to="thm-incremental-correctness" /> の $R$ がちょうど後ろの切片になり、これは「キャッシュが効くのは前置部分だけ」という <Ref to="computer-science/software-engineering/containers-and-kubernetes#prop-cache-prefix" /> と同じ内容です。変わりにくい命令（依存ライブラリの導入）を前に、変わりやすい命令（自分のソースのコピー）を後ろに置くという定石は、鎖の上で $R$ を小さくする工夫です。
</Example>

<Remark id="rem-build-systems-landscape">
ビルドシステムの設計を「実行の順序をどう決めるか（スケジューラ）」と「再実行するかどうかをどう判定するか（再構築の判定）」の 2 軸で分類し、Make・Shake・Bazel・Excel などを同じ枠組みで説明したのが、Mokhov・Mitchell・Peyton Jones の論文です（参考文献）。この記事の更新時刻・内容ハッシュ・2 種類のキーは、その分類の「再構築の判定」の代表例に当たります。実行して初めて依存が分かるタスク（動的な依存）や、多数の計算機でタスクを分担する分散ビルドは、この記事では扱いません。
</Remark>

## 8. 外部の依存：版の解決とロックファイル

ここまでは、自分のリポジトリの中の依存でした。外部のライブラリには**版**があり、「どの版を使うか」を決める問題が加わります。

<Definition id="def-version-resolution" title="版の制約と依存の解決">
次の組を**依存の解決問題の入力**という。

- パッケージの有限集合 $P$ と、各 $a \in P$ の版の有限集合 $V_a \subseteq \mathbb{N}$。
- 各パッケージ $a$ の各版 $v \in V_a$ がもつ**制約**の有限集合 $\mathrm{Req}(a, v)$。制約は組 $(b, S)$（$b \in P$、$S \subseteq V_b$）で、「$b$ が必要で、その版は $S$ に属すること」を表す。
- 作ろうとしているプログラム自身の制約の有限集合 $\mathrm{Req}_0$（**根の制約**）。

部分写像 $\rho : P \rightharpoonup \mathbb{N}$ で、$\rho(a) \in V_a$ であり、

- (R1) $(b, S) \in \mathrm{Req}_0$ ならば、$b$ は $\rho$ の定義域に属し $\rho(b) \in S$、
- (R2) $a$ が $\rho$ の定義域に属し $(b, S) \in \mathrm{Req}(a, \rho(a))$ ならば、$b$ は $\rho$ の定義域に属し $\rho(b) \in S$、

を満たすものを**解決**という。$\rho$ は各パッケージに高々 1 つの版を選ぶ。入力（$S$ は元を列挙して表す）が与えられたとき、解決が存在するかを問う判定問題を $\mathrm{RESOLVE}$ と書く。
</Definition>

<Theorem id="thm-version-resolution-np" title="版の解決は NP 完全">
$\mathrm{RESOLVE}$ は NP 完全である。
</Theorem>

NP 困難性の証明は、3SAT の論理式をパッケージの入力に読み替えます。変数 $x_i$ をパッケージ $X_i$（版 1 が偽、版 2 が真）に、節 $C_j$ をパッケージ $K_j$（版 $r$ は「節の $r$ 番目のリテラルで節を満たす」という選択）に対応させます。$K_j$ の版を選ぶと、そのリテラルが真になるような版を $X_i$ に要求するので、すべての節が満たされることと解決があることが一致します。§9 の演習の論理式での具体例を、次の図に描きました。

<Figure caption="演習の論理式（2 つの節）から作る入力。K1・K2 から出る 3 本の線は、上から順に版 1・2・3 を選んだときの制約で、線の先の数字は X に要求される版（1 が偽、2 が真）">
<svg viewBox="0 0 640 260" width="100%" role="img" aria-label="節のパッケージ K1, K2 の各版から、変数のパッケージ X1, X2, X3 の要求される版への制約を結んだ図">
  <g fill="none" stroke="currentColor" stroke-width="1.5">
    <rect x="20" y="60" width="100" height="32" rx="4" />
    <rect x="20" y="200" width="100" height="32" rx="4" />
    <rect x="520" y="20" width="100" height="32" rx="4" stroke-dasharray="5 3" />
    <rect x="520" y="110" width="100" height="32" rx="4" stroke-dasharray="5 3" />
    <rect x="520" y="200" width="100" height="32" rx="4" stroke-dasharray="5 3" />
    <line x1="120" y1="76" x2="520" y2="36" />
    <line x1="120" y1="76" x2="520" y2="126" />
    <line x1="120" y1="76" x2="520" y2="216" />
    <line x1="120" y1="216" x2="520" y2="36" />
    <line x1="120" y1="216" x2="520" y2="126" />
    <line x1="120" y1="216" x2="520" y2="216" />
  </g>
  <g fill="currentColor" font-size="13" text-anchor="middle">
    <text x="70" y="81" font-size="14">K1</text>
    <text x="70" y="221" font-size="14">K2</text>
    <text x="570" y="41" font-size="14">X1</text>
    <text x="570" y="131" font-size="14">X2</text>
    <text x="570" y="221" font-size="14">X3</text>
    <text x="205" y="62">版1</text>
    <text x="205" y="85">版2</text>
    <text x="205" y="108">版3</text>
    <text x="205" y="167">版1</text>
    <text x="205" y="190">版2</text>
    <text x="205" y="212">版3</text>
    <text x="450" y="39">2</text>
    <text x="450" y="113">1</text>
    <text x="450" y="187">2</text>
    <text x="450" y="63">1</text>
    <text x="450" y="138">2</text>
    <text x="450" y="212">1</text>
  </g>
</svg>
</Figure>

<Proof of="thm-version-resolution-np">
**$\mathrm{RESOLVE} \in \mathrm{NP}$。** 証明書として解決 $\rho$ そのもの（パッケージと版の組の一覧）を取ります。その長さは入力の長さ以下です。検証器は、(R1) を根の制約ごとに、(R2) を $\rho$ の定義域の各 $a$ と $\mathrm{Req}(a, \rho(a))$ の各制約ごとに調べます。1 つの制約の検査は $S$ の列挙の中から $\rho(b)$ を探すだけなので、全体は入力の長さの多項式時間です。<Ref to="computer-science/algorithms/p-vs-np#def-np" /> より $\mathrm{RESOLVE} \in \mathrm{NP}$ です。

**NP 困難性。** $\mathrm{3SAT}$（<Ref to="computer-science/algorithms/p-vs-np#def-sat" />）から多項式時間多対一帰着（<Ref to="computer-science/algorithms/p-vs-np#def-reduction" />）を作ります。変数 $x_1, \ldots, x_n$ の上の 3CNF 論理式 $\varphi = C_1 \land \cdots \land C_m$、$C_j = (\ell_{j,1} \lor \ell_{j,2} \lor \ell_{j,3})$ に対し、次の入力 $F(\varphi)$ を作ります。

- 各変数 $x_i$ にパッケージ $X_i$ を置き、版を $V_{X_i} = \{1, 2\}$ とする。版 $2$ が「真」、版 $1$ が「偽」を表す。どちらの版も制約をもたない。
- 各節 $C_j$ にパッケージ $K_j$ を置き、版を $V_{K_j} = \{1, 2, 3\}$ とする。版 $r$ の制約は 1 つだけで、$\ell_{j,r} = x_i$ なら $(X_i, \{2\})$、$\ell_{j,r} = \lnot x_i$ なら $(X_i, \{1\})$ とする。
- 根の制約は $(K_j, \{1, 2, 3\})$（$j = 1, \ldots, m$）とする。

パッケージは $n + m$ 個、制約は $4m$ 個で、$F(\varphi)$ は $\varphi$ の長さの多項式時間で書き出せます。「$\varphi$ が充足可能 $\iff$ $F(\varphi)$ に解決がある」を示します。

（$\Rightarrow$）$\alpha$ が $\varphi$ を充足するとします。$\rho(X_i) = 2$（$\alpha(x_i)$ が真のとき）、$\rho(X_i) = 1$（偽のとき）と定めます。各節 $C_j$ には $\alpha$ のもとで真になるリテラルがあるので、その番号の 1 つを $r_j$ として $\rho(K_j) = r_j$ と定めます。(R1) は $\rho(K_j) \in \{1, 2, 3\}$ なので成り立ちます。(R2) を確かめます。$K_j$ の版 $r_j$ の制約は、$\ell_{j, r_j} = x_i$ なら $(X_i, \{2\})$ で、$\ell_{j,r_j}$ が真なので $\alpha(x_i)$ は真、よって $\rho(X_i) = 2$ です。$\ell_{j,r_j} = \lnot x_i$ なら $(X_i, \{1\})$ で、$\alpha(x_i)$ は偽なので $\rho(X_i) = 1$ です。$X_i$ は制約をもちません。よって $\rho$ は解決です。

（$\Leftarrow$）$\rho$ が解決であるとします。割り当て $\alpha$ を「$X_i$ が $\rho$ の定義域に属し $\rho(X_i) = 2$ のとき $\alpha(x_i)$ は真、それ以外は偽」と定めます。各 $j$ について、(R1) より $K_j$ は定義域に属します。$r = \rho(K_j)$ とおくと、(R2) より、$\ell_{j,r} = x_i$ なら $\rho(X_i) = 2$ なので $\alpha(x_i)$ は真で、リテラル $\ell_{j,r}$ は真です。$\ell_{j,r} = \lnot x_i$ なら $\rho(X_i) = 1$ なので $\alpha(x_i)$ は偽で、リテラル $\ell_{j,r}$ はやはり真です。どの節にも真のリテラルがあるので、$\alpha$ は $\varphi$ を充足します。この向きで、$\rho$ が各 $X_i$ に**1 つの**版しか選べないことを使っています。

以上で $\mathrm{3SAT} \le_{\mathrm{p}} \mathrm{RESOLVE}$ です。$\mathrm{3SAT}$ は NP 完全なので（<Ref to="computer-science/algorithms/p-vs-np#cor-3sat" />）、すべての $L \in \mathrm{NP}$ について $L \le_{\mathrm{p}} \mathrm{3SAT}$ で、帰着の推移律（<Ref to="computer-science/algorithms/p-vs-np#thm-closure" /> の 3）より $L \le_{\mathrm{p}} \mathrm{RESOLVE}$ です。<Ref to="computer-science/algorithms/p-vs-np#def-np-complete" /> より $\mathrm{RESOLVE}$ は NP 完全です。
</Proof>

難しさの源は、「1 つのパッケージに 1 つの版」という排他的な選択と、版ごとに異なる制約の組み合わせです。どちらかを外すと問題は易しくなります。

<Proposition id="prop-resolution-polynomial" title="多項式時間で解ける 2 つの変種">
(a) （版の共存を許す）組の集合 $M \subseteq \{(a, v) : a \in P,\ v \in V_a\}$ で、根の制約 $(b, S)$ ごとに $(b, v') \in M$ となる $v' \in S$ があり、$(a, v) \in M$ と $(b, S) \in \mathrm{Req}(a, v)$ ごとに $(b, v') \in M$ となる $v' \in S$ があるものを**多重解決**という。多重解決が存在するかどうかは多項式時間で判定できる。

(b) （下限だけの制約）すべての制約が $(b, \{v \in V_b : v \ge m\})$、$m \in V_b$ の形（これを $(b, \ge m)$ と書く）であるとする。このとき解決は必ず存在し、制約の総数について線形の時間で 1 つ求まる。
</Proposition>

<Proof of="prop-resolution-polynomial">
**(a)。** $M_0$ をすべての組 $(a, v)$ の集合とします。$M_k$ の中に、ある制約 $(b, S) \in \mathrm{Req}(a, v)$ について「$(b, v') \in M_k$ となる $v' \in S$ がない」ような組 $(a, v)$ があれば、それを 1 つ取り除いて $M_{k+1}$ とします。なければ止めて、そのときの集合を $M^{*}$ とします。取り除ける回数は組の総数以下で、1 回の探索は入力の長さの多項式時間なので、全体も多項式時間です。

止まったとき、$M^{*}$ は多重解決の 2 番目の条件を満たします。次に、任意の多重解決 $M$ について $M \subseteq M_k$ を $k$ についての帰納法（<Ref to="mathematics/foundations/proof-techniques#thm-induction" />）で示します。$M \subseteq M_0$ です。$M \subseteq M_k$ とし、$M_k$ から取り除かれる組を $(a, v)$、その理由になった制約を $(b, S)$ とします。もし $(a, v) \in M$ なら、$M$ が多重解決であることから $(b, v') \in M \subseteq M_k$ となる $v' \in S$ があり、取り除かれる理由に反します。よって $(a, v) \notin M$ で、$M \subseteq M_{k+1}$ です。

したがって、多重解決が存在すればそれは $M^{*}$ に含まれ、根の制約についての条件は集合を大きくしても保たれるので、$M^{*}$ も根の制約の条件を満たします。逆に $M^{*}$ が根の制約の条件を満たせば、$M^{*}$ 自身が多重解決です。よって「$M^{*}$ が根の制約の条件を満たすか」を調べれば判定できます。

**(b)。** 頂点を「根」とすべての組 $(a, v)$ とし、根から根の制約 $(b, \ge m)$ ごとに $(b, m)$ へ、$(a, v)$ から制約 $(b, \ge m) \in \mathrm{Req}(a, v)$ ごとに $(b, m)$ へ辺を引いた有向グラフを考えます。根から到達できる組の集合を $Q$ とし、$Q$ に版が現れるパッケージ $b$ について
$$
\rho(b) = \max\{m : (b, m) \in Q\}
$$
と定めます。$Q$ は幅優先探索で、頂点と辺の数について線形の時間で求まります（<Ref to="computer-science/algorithms/graph-algorithms#thm-bfs-correctness" />、<Ref to="computer-science/algorithms/graph-algorithms#prop-bfs-complexity" />）。

$\rho$ が解決であることを確かめます。(R1): 根の制約 $(b, \ge m)$ について $(b, m) \in Q$ なので、$b$ は定義域に属し $\rho(b) \ge m$ です。(R2): $a$ が定義域に属するとき、$\rho(a)$ は最大値を与える元なので $(a, \rho(a)) \in Q$ です。制約 $(b, \ge m) \in \mathrm{Req}(a, \rho(a))$ について、$(a, \rho(a))$ から $(b, m)$ へ辺があるので $(b, m) \in Q$ で、$b$ は定義域に属し $\rho(b) \ge m$ です。
</Proof>

(a) は、依存ごとに別の版を入れ子で持てる方式（Node.js の `node_modules` が原則として採る方式）に、(b) は Go のモジュールが採る「最小の版の選択」に対応します。(b) の $\rho$ は、要求された下限のうち最大のものを選ぶので、「誰かが明示的に要求した版」しか選ばれず、新しい版が公開されただけでは結果が変わりません。一方、上限や除外を書ける方式（多くの言語のパッケージ管理）は、<Ref to="thm-version-resolution-np" /> の難しさを引き受ける代わりに、既知の不具合のある版を避けるといった表現力を得ています。実務の解決器は、SAT ソルバと同じ探索の技法（後戻りと、衝突からの学習）を使います。

<Proposition id="prop-lockfile-determinism" title="ロックファイルによる取得の決定性">
解決 $\rho$ と、選ばれた各版の配布物の内容ハッシュを記録した表
$$
\ell = \{(a,\ \rho(a),\ h_a) : a \text{ は } \rho \text{ の定義域に属する}\}
$$
を**ロックファイル**という。取得の手続きを「各 $(a, v, h) \in \ell$ について、配布元から $a$ の版 $v$ の内容 $c$ を取り、$H(c) = h$ ならば採用し、そうでなければ失敗して止まる」と定める。$H$ が現れる内容の上で単射ならば、取得が成功したときに得られる内容の族 $(c_a)_a$ は $\ell$ だけで決まり、取得の時刻・配布元の状態・取得する計算機によらない。
</Proposition>

<Proof of="prop-lockfile-determinism">
2 回の取得がともに成功し、パッケージ $a$ についてそれぞれ $c_a$、$c'_a$ を得たとします。手続きの定義より $H(c_a) = h_a = H(c'_a)$ で、$H$ の単射性より $c_a = c'_a$ です。$h_a$ は $\ell$ に書かれた値なので、$c_a$ は $\ell$ だけで決まります。
</Proof>

取得した内容を入力 $I$ に含めれば、<Ref to="thm-build-correctness" /> より、ビルドの結果は「自分のソースとロックファイル」の関数になります。ロックファイルをリポジトリに入れておけば、過去のコミットを取り出して同じ依存で作り直せます。

<Example id="ex-no-lockfile" title="ロックファイルがないと、同じ宣言から時刻によって違う解が出る">
宣言が「`lib` の版 1.2 以上、2 未満」だけだとします。月曜に配布元にある `lib` の版が 1.2.0 と 1.2.1 なら、新しいものを優先する解決器は 1.2.1 を選びます。火曜に 1.3.0 が公開されると、同じ宣言から 1.3.0 が選ばれます。月曜に通ったテストが火曜に落ちても、自分のリポジトリには差分がありません。解決器は「宣言と、その時刻の配布元の状態」の関数であって、宣言だけの関数ではないからです。

Python では、宣言（`requirements.in` や `pyproject.toml`）から、推移的な依存をすべて版まで固定しハッシュを付けた一覧を生成し、導入時にハッシュの照合を要求する（pip の `--require-hashes`）のが、この命題の手続きに当たります。仮想環境は、取得した内容を置く場所をプロジェクトごとに分けて、計算機に元から入っているパッケージという宣言されていない依存を断つ仕組みです。版の番号だけを記録してハッシュを記録しない場合、同じ版番号で内容が差し替えられたことを検出できません。
</Example>

最後に、版の番号に意味を持たせる約束を、契約の言葉で述べます。

<Definition id="def-semver" title="意味的バージョニング">
ライブラリの版を**主版**と**副版**の組 $(M, m)$ で表す（修正版は省く）。各版は、公開する操作の集合 $\mathrm{Op}_{M,m}$ と、各操作 $o$ の契約（事前条件 $P^{M,m}_o$ と事後条件 $Q^{M,m}_o$）をもつ。**意味的バージョニングの約束**とは、同じ主版 $M$ の中で $m \le m'$ ならば

- $\mathrm{Op}_{M,m} \subseteq \mathrm{Op}_{M,m'}$（操作はなくならない）、
- 各 $o \in \mathrm{Op}_{M,m}$ について $P^{M,m}_o \Rightarrow P^{M,m'}_o$ かつ $Q^{M,m'}_o \Rightarrow Q^{M,m}_o$（事前条件は強めず、事後条件は弱めない）

が成り立つことをいう。主版が違う版の間には何も約束しない。
</Definition>

<Proposition id="prop-diamond-dependency" title="菱形の依存と高いほうの副版">
プログラムが A と B に依存し、A はライブラリ C の版 $(M, m_A)$ の契約だけを使って、B は同じ主版の $(M, m_B)$ の契約だけを使って、それぞれ自分の正しさ（C の操作を呼び出すコードについての Hoare の三つ組）を証明しているとする。C が意味的バージョニングの約束（<Ref to="def-semver" />）を守っているならば、C の版を $(M, \max(m_A, m_B))$ の 1 つにしても、A と B の証明した三つ組はどちらも成り立つ。
</Proposition>

<Proof of="prop-diamond-dependency">
$m^{*} = \max(m_A, m_B)$ とおきます。$m_A \le m^{*}$ なので、約束より、A が使う各操作 $o \in \mathrm{Op}_{M, m_A}$ は $\mathrm{Op}_{M, m^{*}}$ にあり、$P^{M,m_A}_o \Rightarrow P^{M,m^{*}}_o$ かつ $Q^{M,m^{*}}_o \Rightarrow Q^{M,m_A}_o$ です。これは、版 $(M, m^{*})$ の実装の契約が、版 $(M, m_A)$ の契約に対して「事前条件が弱く、事後条件が強い」という、振る舞いの部分型の条件そのものです。<Ref to="computer-science/software-design-testing/contracts-and-invariants#thm-behavioral-subtyping" /> より、上位の契約（版 $(M, m_A)$ の契約）だけを使って証明された呼び出し側の三つ組は、実装を下位のもの（版 $(M, m^{*})$）に差し替えても成り立ちます。B についても $m_B \le m^{*}$ から同じ議論が成り立ちます。
</Proof>

この命題は、<Ref to="prop-resolution-polynomial" /> (b) の「下限のうち最大のものを選ぶ」解決が意味をもつ理由でもあります。ただし、約束が守られているかどうかを機械は保証しません。利用者が契約に書かれていない振る舞い（例外のメッセージの文面、返る列の順序、実行時間）に頼っていれば、副版の更新でも壊れます。主版が違う場合は約束がないので、1 つの版にまとめることはできず、共存させる（<Ref to="prop-resolution-polynomial" /> (a)）か、どちらかの利用者を直すしかありません。

## 9. 演習

<Exercise id="exr-reachable-set" difficulty="易">
§2 の図（§5 のコード例）の依存グラフについて、次に答えよ。

1. Kahn の算法（<Ref to="thm-topological-order" /> (b)）の出力を 1 つ書け。
2. `style.css` だけを変更したときの再実行の集合 $R$（<Ref to="thm-incremental-correctness" />）を求めよ。
3. `b.md` の本文だけを変更し、環境 id の並びは変えなかった。早期打ち切り（<Ref to="prop-early-cutoff" />）のもとで実行されるタスクを答えよ。

<Solution>
1. 入次数 $0$ の頂点は 3 つの入力である。待ち行列を先入れ先出しにし、名前の順に入れると、出力の 1 つは `a.md`, `b.md`, `style.css`, `parse_a`, `parse_b`, `index`, `page_a`, `page_b`, `site` である。`a.md` を出力すると `parse_a` の計数が $0$ になり、`b.md` で `parse_b` が $0$ になる。`style.css` を出力しても `page_a`・`page_b` の計数は残り（`index` と文書を待つ）、`parse_a`・`parse_b` の出力で `index` が $0$、`index` の出力で `page_a`・`page_b` が $0$、最後に `site` が $0$ になる。
2. `style.css` から辺が出ている先は `page_a` と `page_b`、そこから `site` に届く。$R = \{\texttt{page\_a}, \texttt{page\_b}, \texttt{site}\}$。§5 の実行結果の 5 行目と一致する。
3. `parse_b` は `b.md` が変わったので実行され、出力（id の並び）は前回と同じである。`index` の依存 `parse_a`・`parse_b` はどちらも前回と同じ値なので実行されない。`page_a` の依存 `a.md`・`index`・`style.css` はどれも変わっていないので実行されない。`page_b` は `b.md` を直接読むので実行され、出力が変わる。`site` は `page_b` が変わったので実行される。答えは `parse_b`, `page_b`, `site` である。到達できる集合 $\{\texttt{parse\_b}, \texttt{index}, \texttt{page\_a}, \texttt{page\_b}, \texttt{site}\}$ の真部分集合になっている。
</Solution>
</Exercise>

<Exercise id="exr-greedy-not-optimal" difficulty="標準">
ワーカーが $p = 2$ 台で、依存のない 3 つのタスク A・B・C の所要時間が $w_A = w_B = 1$、$w_C = 2$ であるとする。

1. $W$、$L$ と、<Ref to="thm-parallel-build-bound" /> の (a) の下界、(b) の上界を求めよ。
2. 上界に一致する完了時刻をもつ貪欲なスケジュールと、下界に一致するスケジュールをそれぞれ 1 つ挙げよ。
3. このことから、(c) の倍率 $2 - 1/p$ について何が言えるか。

<Solution>
1. $W = 1 + 1 + 2 = 4$。依存がないので道は 1 つのタスクだけからなり、$L = \max(1, 1, 2) = 2$。下界は $\max(4/2, 2) = 2$、上界は $4/2 + 2(1 - 1/2) = 3$。
2. 時刻 $0$ に A と B を始めるスケジュールを考える。時刻 $0$ から $1$ までは 2 台とも実行中である。時刻 $1$ に 2 台が空き、未開始で依存が完了しているタスクは C だけなので、C を始める。C の実行中、もう 1 台は空いているが、未開始のタスクはないので貪欲の条件に反しない。完了時刻は $1 + 2 = 3$ で、上界に一致する。一方、時刻 $0$ に C を 1 台目で、A を 2 台目で始め、時刻 $1$ に B を 2 台目で始めると、完了時刻は $2$ で、下界に一致する（これも貪欲である）。
3. 最適な完了時刻は $2$ で、貪欲なスケジュールの中に完了時刻 $3$ のものがある。比は $3/2 = 2 - 1/2$ で、$p = 2$ のとき (c) の倍率は改善できない。貪欲であること（空きを作らないこと）だけでは最適にならず、実行可能なタスクのうちどれを先に始めるかという優先順位が効く。長いタスクや、長い依存鎖の先頭にあるタスクを先に始めるのが定石である。
</Solution>
</Exercise>

<Exercise id="exr-reduction-instance" difficulty="標準">
$\varphi = (x_1 \lor \lnot x_2 \lor x_3) \land (\lnot x_1 \lor x_2 \lor \lnot x_3)$ に対して、<Ref to="thm-version-resolution-np" /> の証明の入力 $F(\varphi)$ を書き下し、解決を 1 つ挙げよ。また、版の共存を許した場合（<Ref to="prop-resolution-polynomial" /> (a) の多重解決）には、この構成が充足可能性を反映しなくなることを、充足不能な論理式の例で説明せよ。

<Solution>
パッケージは $X_1, X_2, X_3$（版は $\{1, 2\}$、制約なし）と $K_1, K_2$（版は $\{1, 2, 3\}$）。制約は

- $K_1$ の版 $1$: $(X_1, \{2\})$、版 $2$: $(X_2, \{1\})$、版 $3$: $(X_3, \{2\})$、
- $K_2$ の版 $1$: $(X_1, \{1\})$、版 $2$: $(X_2, \{2\})$、版 $3$: $(X_3, \{1\})$、

根の制約は $(K_1, \{1,2,3\})$ と $(K_2, \{1,2,3\})$ である。

$\alpha(x_1) = \alpha(x_2) =$ 真、$\alpha(x_3) =$ 偽 は $\varphi$ を充足する（第 1 節は $x_1$、第 2 節は $x_2$ が真）。対応する解決は $\rho(X_1) = 2$、$\rho(X_2) = 2$、$\rho(X_3) = 1$、$\rho(K_1) = 1$、$\rho(K_2) = 2$ である。$K_1$ の版 $1$ の制約 $(X_1, \{2\})$ と、$K_2$ の版 $2$ の制約 $(X_2, \{2\})$ がどちらも満たされている。

共存を許すと、すべての組 $(a, v)$ を集めた集合がつねに多重解決になる。$K_j$ の版 $r$ の制約 $(X_i, \{2\})$ または $(X_i, \{1\})$ は、$X_i$ の両方の版が入っているので満たされるからである。たとえば充足不能な $(x_1 \lor x_1 \lor x_1) \land (\lnot x_1 \lor \lnot x_1 \lor \lnot x_1)$ から作った入力にも多重解決がある。「$x_1$ が真でも偽でもある」ことが許されてしまうためで、帰着の逆向き（解決から割り当てを作る段）が壊れる。排他的な選択が NP 困難性の源であることが、ここからも分かる。
</Solution>
</Exercise>

## 参考文献

- A. Mokhov, N. Mitchell, S. Peyton Jones, "Build systems à la carte", *Proceedings of the ACM on Programming Languages* 2 (ICFP) (2018), Article 79. [https://doi.org/10.1145/3236774](https://doi.org/10.1145/3236774) — スケジューラと再構築の判定の 2 軸によるビルドシステムの分類。早期打ち切りと 2 種類のキーの整理はこの論文に基づきます。
- S. I. Feldman, "Make — a program for maintaining computer programs", *Software: Practice and Experience* 9(4) (1979), 255–265 — 依存の宣言と更新時刻の比較という方式の原典。
- A. B. Kahn, "Topological sorting of large networks", *Communications of the ACM* 5(11) (1962), 558–562 — <Ref to="thm-topological-order" /> (b) の算法。
- R. L. Graham, "Bounds on multiprocessing timing anomalies", *SIAM Journal on Applied Mathematics* 17(2) (1969), 416–429 — 貪欲なスケジュールが最適の $(2 - 1/p)$ 倍以内であることを示した論文（最初の証明は同じ著者の 1966 年の論文にあります）。
- R. Cox, "Version SAT" (2016), [https://research.swtch.com/version-sat](https://research.swtch.com/version-sat) および "Minimal Version Selection" (2018), [https://research.swtch.com/vgo-mvs](https://research.swtch.com/vgo-mvs) — 版の解決の NP 完全性と、下限だけの制約による多項式時間の方式。
- T. Preston-Werner, "Semantic Versioning 2.0.0", [https://semver.org/](https://semver.org/) — 意味的バージョニングの仕様。
- Reproducible Builds project, [https://reproducible-builds.org/](https://reproducible-builds.org/) — ビット単位で同じ成果物を得るための非決定性の源の一覧と対策。