# 推論：自己回帰生成・温度と top-p・KV キャッシュ・量子化

> 学習済みの重みから文章を生成する手続きを定義し、温度の極限とエントロピーの単調性、top-p 集合の一意性と最小性、貪欲復号が最適でない反例、KV キャッシュの正しさと計算量、一様量子化の誤差の上界を証明して NumPy で確かめる。
> https://rikai.mugen-giken.com/computer-science/llm-architecture/inference-and-sampling

## 0. この記事の要点

ChatGPT のような言語モデルは、文章を丸ごと一度に作るのではなく、「次の 1 語（トークン）は何か」を毎回予想して、1 つ選んで付け足すことを繰り返しています。予想の仕方（重み）が同じでも、どう選ぶか、計算をどう節約するか、重みをどこまで粗く保存するかで、出力の内容も速さも変わります。この記事では、その「選び方」（温度・top-p など）、「計算の節約」（KV キャッシュ）、「重みの粗い保存」（量子化）が、それぞれ何を保証するのかを、数式と小さな数値例で確かめます。

- 生成は「次のトークンの分布から 1 つ選び、入力の末尾に足す」ことの反復です。同じ重みでも、選び方（復号の方法）を変えると出力の分布が変わります。毎回いちばん確率の高いトークンを選ぶ貪欲復号は、確率最大の列を返すとは限りません（<Ref to="prop-greedy-not-optimal" />）。
- 温度 $\tau$ はロジット（softmax に入れる前の、各トークンのスコア）を $\tau$ で割ってから softmax を取る操作です。$\tau \to 0$ で最大成分だけに集中し、$\tau \to \infty$ で一様分布になり、エントロピー（分布の散らばり具合を表す数）は $\tau$ について単調に増えます。その導関数は $\mathrm{Var}(z) / \tau^3$ です（<Ref to="thm-softmax-temperature-limit" />）。
- top-k と top-p は、ある集合 $S$ への条件付き分布を取る操作です（<Ref to="prop-truncation-renormalization" />）。top-p 集合は並べ方を決めれば一意で、その大きさは「確率の和がしきい値以上になる集合の最小の大きさ」に等しくなります（<Ref to="thm-top-p-uniqueness" />）。
- KV キャッシュは、[因果マスク](/computer-science/llm-architecture/self-attention#def-attention)（各位置が自分より後ろのトークンを見ないようにする制限）のもとでは過去の位置のキーとバリューが後のトークンに依らないことを使います。出力は計算し直した場合と一致し（<Ref to="thm-kv-cache-correct" />）、$n$ トークンの生成の計算量は 1 層あたり $O(n^3 d + n^2 d^2)$ から $O(n^2 d + n d^2)$ に減ります（<Ref to="thm-kv-cache-cost" />）。
- 重みを $b$ ビットに丸める一様量子化の誤差は、1 成分あたり刻みの半分以下で、ビットを 1 つ増やすと上界はほぼ半分になります（<Ref to="prop-quantization-error" />）。

<Aside type="tip" title="この記事で使う事前知識">

- **自己回帰言語モデル**: 接頭辞から次のトークンの確率分布を返し、その積で列の確率を表すモデル。→ [自己回帰言語モデル](/computer-science/llm-architecture/training-language-models#def-autoregressive-lm)
- **因果マスク**: 位置 $t$ の注意が $t$ 以前の位置だけを見るようにする制限。→ [因果マスク](/computer-science/llm-architecture/self-attention#def-attention)
- **層正規化**: 各位置のベクトルを、成分の平均と散らばりでそろえる操作。→ [層正規化](/computer-science/llm-architecture/transformer-block#def-layer-norm)
- **エントロピー**: 確率分布の散らばりを表す数 $H(p) = -\sum_i p_i \log p_i$。1 点に集中すれば $0$、一様分布で最大になります。
- **分散**: 平均からのずれの二乗の平均。→ [分散](/mathematics/probability/random-variables#def-variance-covariance)
- **条件付き確率**: ある事象が起きたと分かったうえでの、別の事象の確率。→ [条件付き確率](/mathematics/probability/probability-spaces#def-conditional)

</Aside>

## 1. 動機：重みが決まっても、出力は決まらない

[学習](/computer-science/llm-architecture/training-language-models)で決まるのは重み $\theta$、すなわち接頭辞から次のトークンの確率分布への写像 $p_\theta(\cdot \mid x_{<t})$ です。これは文章そのものではありません。分布から実際の文章を作るには、次のことを決める必要があります。

1. 分布からトークンをどう選ぶか。いちばん確率の高いものを取るのか、分布に従って乱数で選ぶのか、分布を加工してから選ぶのか。
2. 1 トークン選ぶたびに、モデルの順伝播を最初からやり直すのか。
3. 重みをどの精度で持つのか。

1 は出力の内容を、2 と 3 は計算の速さと記憶の量を左右します。この章では、それぞれについて厳密に言えることを命題にします。「どの温度が良い文章を出すか」「何ビットまで落としても品質が保たれるか」は経験的な問いで、この章の命題は答えません。命題が与えるのは、各操作が分布や計算量や誤差に対して確実に行うことです。

## 2. 準備：記号

語彙を $V = \{1, \ldots, N\}$（$N = |V|$）とし、トークンを添字で表します。モデルは接頭辞 $x_{<t}$ に対してロジット $\boldsymbol{z} \in \mathbb{R}^N$（softmax に入れる前の、各トークンのスコア）を返し、$p = \mathrm{softmax}(\boldsymbol{z})$ が次のトークンの分布です。softmax の基本性質（成分が正で和が $1$、定数を足しても変わらない、成分の大小を保つ）は <Ref to="computer-science/llm-architecture/self-attention#prop-softmax-basic" /> を使います。

確率分布 $p = (p_1, \ldots, p_N)$ と集合 $S \subset V$ に対して $p(S) = \sum_{i \in S} p_i$ と書きます。エントロピーは $H(p) = -\sum_i p_i \log p_i$（$p_i = 0$ の項は $0$）で、対数は自然対数です。モデルの次元を $d$、層数を $L$、MLP の幅を $d_{\mathrm{ff}}$ と書きます。

## 3. 自己回帰生成と復号

<Definition id="def-autoregressive-generation" title="自己回帰生成">
プロンプト（与えられた接頭辞）$x_{\le t_0}$ から始めて、$t = t_0 + 1, t_0 + 2, \ldots$ について

1. モデルで $p_\theta(\cdot \mid x_{<t})$ を計算する、
2. **復号規則**に従って $x_t \in V$ を 1 つ決める、
3. $x_t$ を列の末尾に足す、

を繰り返す手続きを**自己回帰生成**といいます。$x_t$ が終端を表す[特殊トークン](/computer-science/llm-architecture/tokenization-bpe#def-utf8)になったとき、または列の長さがあらかじめ決めた最大長に達したときに止めます。最大長があるので、手続きは必ず止まります。
</Definition>

復号規則として、$x_t$ を $p_\theta(\cdot \mid x_{<t})$ に従う乱数で選ぶと（**祖先サンプリング**）、生成された列は前章の自己回帰の積 $\prod_t p_\theta(x_t \mid x_{<t})$ の分布（<Ref to="computer-science/llm-architecture/training-language-models#thm-autoregressive-distribution" />）に従います。それ以外の規則では、列の分布は別のものになります。

<Definition id="def-greedy-beam" title="貪欲復号とビーム探索">
- **貪欲復号**: 各ステップで $x_t = \operatorname{arg\,max}_{v} p_\theta(v \mid x_{<t})$ とします。最大が複数あるときは添字の最も小さいものを取ります。
- **ビーム探索**（幅 $B \ge 1$、長さ $n$）: 長さ $t$ の接頭辞の集合 $\mathcal{B}_t$ を、$\mathcal{B}_0 = \{\text{空列}\}$ から順に次で定めます。候補の集合を $C_t = \{ (y, v) : y \in \mathcal{B}_{t-1},\ v \in V \}$ とし、$C_t$ の元を列の確率 $p_\theta(y, v) = p_\theta(y)\, p_\theta(v \mid y)$ の大きい順（同じ値はあらかじめ決めた順）に並べて、上から $\min(B, |C_t|)$ 個を $\mathcal{B}_t$ とします。出力は $\mathcal{B}_n$ のうち確率が最大の列です。
</Definition>

次の命題の 1 は、二文字だけの小さな例で見ると分かりやすくなります。1 文字目で確率の高いほう（a）を選ぶと、そのあとに続く文字の確率が低くなり、列全体では損をすることがあります。証明の 1 で使う確率を木にすると次のようになります。

<Figure caption="2 文字の列の確率の木。各枝の数は条件付き確率で、右端は列の確率（枝の数の積）。貪欲復号は色つきの道をたどって aa（0.33）に着くが、確率が最大なのは ba（0.36）である。">

<svg viewBox="0 0 760 260" width="100%" role="img" aria-label="2 文字の列の確率の木">
  <g fill="none" stroke="currentColor" stroke-width="1.2">
    <path d="M 80 130 L 240 70" stroke="var(--sl-color-accent)" stroke-width="2.4" />
    <path d="M 80 130 L 240 190" />
    <path d="M 300 70 L 455 30" stroke="var(--sl-color-accent)" stroke-width="2.4" />
    <path d="M 300 70 L 455 100" />
    <path d="M 300 190 L 455 160" />
    <path d="M 300 190 L 455 230" />
  </g>
  <g fill="currentColor" font-size="13">
    <text x="20" y="135">空列</text>
    <text x="255" y="75">a</text>
    <text x="255" y="195">b</text>
    <text x="130" y="88" text-anchor="middle">0.6</text>
    <text x="130" y="178" text-anchor="middle">0.4</text>
    <text x="385" y="40" text-anchor="middle">0.55</text>
    <text x="385" y="95" text-anchor="middle">0.45</text>
    <text x="385" y="165" text-anchor="middle">0.9</text>
    <text x="385" y="225" text-anchor="middle">0.1</text>
    <text x="470" y="35">aa : 0.33（貪欲復号の結果）</text>
    <text x="470" y="105">ab : 0.27</text>
    <text x="470" y="165">ba : 0.36（確率が最大）</text>
    <text x="470" y="235">bb : 0.04</text>
  </g>
</svg>

</Figure>

<Proposition id="prop-greedy-not-optimal" title="貪欲復号とビーム探索は確率最大の列を保証しない">
長さ $n$ の列の上の自己回帰言語モデル $p_\theta$ を考えます。

1. 貪欲復号が返す列は、確率 $p_\theta(x)$ が最大の列とは限りません。
2. 幅 $B = 1$ のビーム探索は貪欲復号と同じ列を返します（同じ値の扱いが同じなら）。
3. $B \ge |V|^{n-1}$ なら、ビーム探索は確率最大の列を返します。
4. $1 < B < |V|^{n-1}$ では、確率最大の列を返すとは限りません。
5. ビーム探索が計算する候補の確率の個数は $n B |V|$ 以下です。
</Proposition>

<Proof of="prop-greedy-not-optimal">
**1.** $V = \{\mathrm{a}, \mathrm{b}\}$、$n = 2$ とし、

$$
p(\mathrm{a}) = 0.6,\quad p(\mathrm{b}) = 0.4,\qquad p(\mathrm{a} \mid \mathrm{a}) = 0.55,\quad p(\mathrm{b} \mid \mathrm{a}) = 0.45,\qquad p(\mathrm{a} \mid \mathrm{b}) = 0.9,\quad p(\mathrm{b} \mid \mathrm{b}) = 0.1
$$

とします。4 つの列の確率は $p(\mathrm{aa}) = 0.33$、$p(\mathrm{ab}) = 0.27$、$p(\mathrm{ba}) = 0.36$、$p(\mathrm{bb}) = 0.04$ で、和は $1$ です。貪欲復号は 1 文字目に $\mathrm{a}$（$0.6 > 0.4$）、2 文字目に $\mathrm{a}$（$0.55 > 0.45$）を選んで $\mathrm{aa}$ を返しますが、最大は $\mathrm{ba}$ の $0.36$ です。

**2.** $B = 1$ のとき $\mathcal{B}_{t-1}$ はただ 1 つの接頭辞 $y$ からなり、$C_t = \{(y, v) : v \in V\}$ です。$p_\theta(y, v) = p_\theta(y)\, p_\theta(v \mid y)$ で、$p_\theta(y)$ は $v$ に依らないので、$p_\theta(y) > 0$ なら $C_t$ の中で最大のものは $p_\theta(v \mid y)$ が最大の $v$ に対応します。これは貪欲復号の選び方です（$p_\theta(y) = 0$ となることは、softmax の出力が正なので起こりません）。

**3.** $t \le n - 1$ について $\mathcal{B}_t = V^t$ であることを帰納法で示します。$\mathcal{B}_0$ は空列だけで、$V^0$ です。$\mathcal{B}_{t-1} = V^{t-1}$ なら $C_t = V^t$ で、$|C_t| = |V|^t \le |V|^{n-1} \le B$ なので、$\min(B, |C_t|) = |C_t|$ 個、つまり全部が残り、$\mathcal{B}_t = V^t$ です。したがって $C_n = V^n$ で、$\mathcal{B}_n$ は $V^n$ の確率の上位 $\min(B, |V|^n) \ge 1$ 個からなり、確率最大の列を含みます。出力はその中の最大なので、確率最大の列です。

**4.** $V = \{\mathrm{a}, \mathrm{b}, \mathrm{c}\}$、$n = 2$、$B = 2$（$1 < 2 < 3 = |V|^{n-1}$）とし、

$$
p(\mathrm{a}) = 0.4,\ p(\mathrm{b}) = 0.35,\ p(\mathrm{c}) = 0.25, \qquad
p(\cdot \mid \mathrm{a}) = p(\cdot \mid \mathrm{b}) = (0.4, 0.3, 0.3), \qquad p(\cdot \mid \mathrm{c}) = (0.9, 0.05, 0.05)
$$

とします。$\mathcal{B}_1 = \{\mathrm{a}, \mathrm{b}\}$ で、$\mathrm{c}$ は捨てられます。$C_2$ の中の最大は $p(\mathrm{aa}) = 0.16$（ほかは $p(\mathrm{ba}) = 0.14$ など）なので、出力は $\mathrm{aa}$ です。ところが $p(\mathrm{ca}) = 0.25 \times 0.9 = 0.225 > 0.16$ です。

**5.** 各ステップで $|C_t| = |\mathcal{B}_{t-1}| \cdot |V| \le B|V|$ で、ステップは $n$ 回です。
</Proof>

3 の条件 $B \ge |V|^{n-1}$ は、全部の列を調べるのと同じです。語彙が数万、長さが数十の列では現実的でなく、確率最大の列を厳密に求める方法は実用上ありません。一方で、確率最大の列が望ましい出力であるとも限りません。Holtzman らは、確率を最大化する復号が、繰り返しの多い不自然な文章を生みやすいことを報告し、次節以降の「分布を加工してから乱数で選ぶ」方法を提案しました。これは経験的な観察で、この章の命題の外にあります。

## 4. 温度

<Definition id="def-temperature" title="温度つき softmax">
ロジット $\boldsymbol{z} \in \mathbb{R}^N$ と $\tau > 0$ に対して

$$
p_\tau = \mathrm{softmax}(\boldsymbol{z} / \tau), \qquad p_{\tau, i} = \frac{e^{z_i / \tau}}{\sum_{j=1}^{N} e^{z_j / \tau}}
$$

を**温度** $\tau$ の分布といいます。$\tau = 1$ が元の分布です。
</Definition>

<Theorem id="thm-softmax-temperature-limit" title="温度の極限・順位の保存・エントロピーの単調性">
$\boldsymbol{z} \in \mathbb{R}^N$ とし、最大値を $z_{\max} = \max_i z_i$、それを取る添字の集合を $I = \{ i : z_i = z_{\max} \}$ とします。

1. $\tau \to 0+$ のとき、$p_{\tau, i} \to 1 / |I|$（$i \in I$）、$p_{\tau, i} \to 0$（$i \notin I$）です。
2. $\tau \to \infty$ のとき、すべての $i$ で $p_{\tau, i} \to 1 / N$ です。
3. 任意の $\tau > 0$ について、$z_i > z_j$ なら $p_{\tau, i} > p_{\tau, j}$、$z_i = z_j$ なら $p_{\tau, i} = p_{\tau, j}$ です。温度は成分の順位を変えません。
4. $h(\tau) = H(p_\tau)$ は $\tau > 0$ で微分可能で、
$$
\frac{dh}{d\tau} = \frac{\mathrm{Var}_{p_\tau}(z)}{\tau^3} \ \ge\ 0, \qquad \mathrm{Var}_{p_\tau}(z) = \sum_i p_{\tau, i} z_i^2 - \Bigl(\sum_i p_{\tau, i} z_i\Bigr)^2
$$
です。したがって $h$ は広義単調増加で、$z$ の成分がすべて等しい場合を除いて狭義単調増加です。
</Theorem>

証明の方針です。1〜3 は式を見直すだけです。4 では、温度の逆数 $\beta = 1/\tau$ を変数にして、確率の変化の速さ、ロジットの平均、エントロピーの順に微分します。途中に現れる量は「分布のもとでの平均」だけで、最後に分散が現れます。分散は負にならないので、温度を上げてもエントロピーは減らない、という結論になります。

<Proof of="thm-softmax-temperature-limit">
**1.** 分子と分母を $e^{z_{\max} / \tau}$ で割ると

$$
p_{\tau, i} = \frac{e^{(z_i - z_{\max}) / \tau}}{\sum_{j} e^{(z_j - z_{\max}) / \tau}}
$$

です。$j \in I$ なら指数は $0$ で、その項は $\tau$ に依らず $1$ です。$j \notin I$ なら $z_j - z_{\max} < 0$ で、$\tau \to 0+$ のとき $(z_j - z_{\max})/\tau \to -\infty$、その項は $0$ に収束します。したがって分母は $|I|$ に、分子は $i \in I$ なら $1$、$i \notin I$ なら $0$ に収束します。

**2.** $\tau \to \infty$ のとき、各 $j$ で $z_j / \tau \to 0$ なので $e^{z_j / \tau} \to 1$ です。分子は $1$ に、分母は $N$ に収束します。

**3.** 分母は共通で正です。$\tau > 0$ なので $z_i > z_j$ は $z_i / \tau > z_j / \tau$ と同値で、指数関数は狭義単調増加なので $e^{z_i/\tau} > e^{z_j/\tau}$ です。等しい場合も同様です。

**4.** $\beta = 1/\tau$ とおき、$Z(\beta) = \sum_j e^{\beta z_j}$、$p_i = e^{\beta z_i} / Z(\beta)$、$\mu = \sum_i p_i z_i$ と書きます。まず $p_i$ の $\beta$ についての導関数を計算します。$Z'(\beta) = \sum_j z_j e^{\beta z_j} = Z \mu$ なので、商の微分により

$$
\frac{dp_i}{d\beta} = \frac{z_i e^{\beta z_i} Z - e^{\beta z_i} Z \mu}{Z^2} = p_i (z_i - \mu)
$$

です。したがって

$$
\frac{d\mu}{d\beta} = \sum_i z_i \frac{dp_i}{d\beta} = \sum_i p_i z_i (z_i - \mu) = \sum_i p_i z_i^2 - \mu^2 = \mathrm{Var}_{p}(z)
$$

です。次に、$\log p_i = \beta z_i - \log Z$ から、エントロピーは

$$
H = -\sum_i p_i (\beta z_i - \log Z) = \log Z - \beta \mu
$$

と書けます（$\sum_i p_i = 1$ を使いました）。$\frac{d}{d\beta} \log Z = Z'/Z = \mu$ なので

$$
\frac{dH}{d\beta} = \mu - \mu - \beta \frac{d\mu}{d\beta} = -\beta\, \mathrm{Var}_p(z)
$$

です。$\beta = 1/\tau$ で $d\beta / d\tau = -1/\tau^2$ なので、合成関数の微分により

$$
\frac{dh}{d\tau} = \frac{dH}{d\beta} \cdot \frac{d\beta}{d\tau} = \Bigl(-\frac{1}{\tau} \mathrm{Var}_{p_\tau}(z)\Bigr) \Bigl(-\frac{1}{\tau^2}\Bigr) = \frac{\mathrm{Var}_{p_\tau}(z)}{\tau^3}
$$

です。分散は $\sum_i p_i (z_i - \mu)^2$ に等しいので非負です（<Ref to="mathematics/probability/random-variables#prop-variance-properties" />）。$p_i > 0$ なので、これが $0$ になるのはすべての $i$ で $z_i = \mu$、すなわち $z$ の成分がすべて等しいときに限ります。導関数が非負なら広義単調増加、正なら狭義単調増加です（<Ref to="mathematics/calculus/mean-value-and-taylor#cor-monotonicity" />）。
</Proof>

1 は「温度 $0$ は貪欲復号」という言い方の正確な意味です。最大のロジットがただ 1 つなら、$\tau \to 0+$ の極限はそのトークンに確率 $1$ を置く分布で、そこから標本を取ることは貪欲復号と同じです。$\tau = 0$ そのものは式の上で定義されないので、実装では別の分岐（最大成分を取る）として扱います。

4 は、温度が「分布の散らばり具合を 1 つのつまみで動かす」操作であることを定量的に言っています。温度を上げるとエントロピーは必ず増え、下げると必ず減ります。増え方は、ロジットの（その時点の分布での）分散が大きいほど速く、$\tau$ が大きくなると $\tau^{-3}$ で鈍ります。

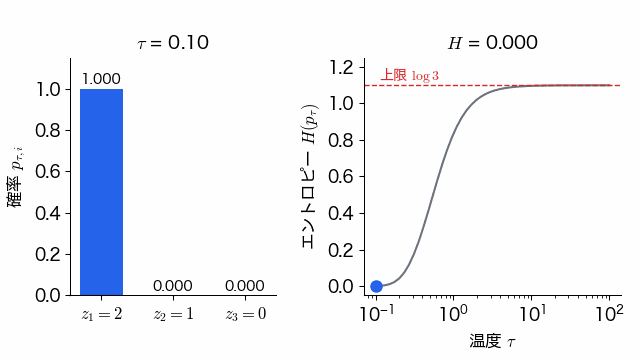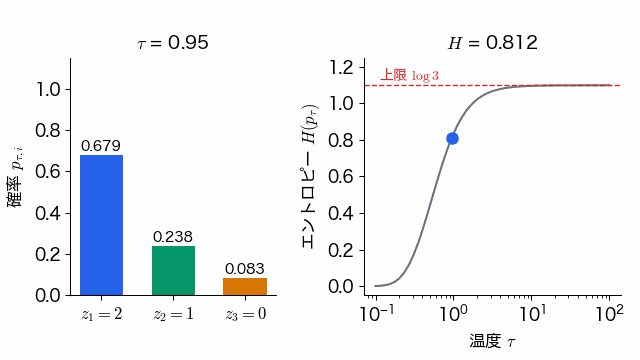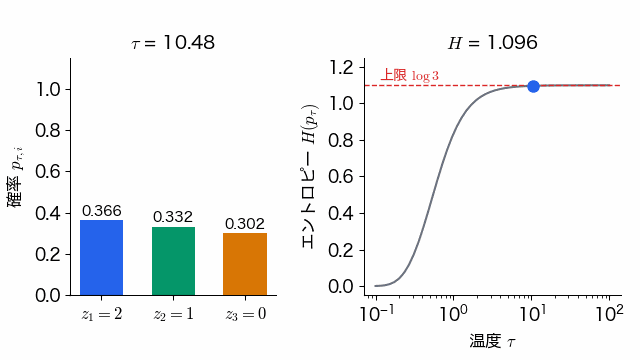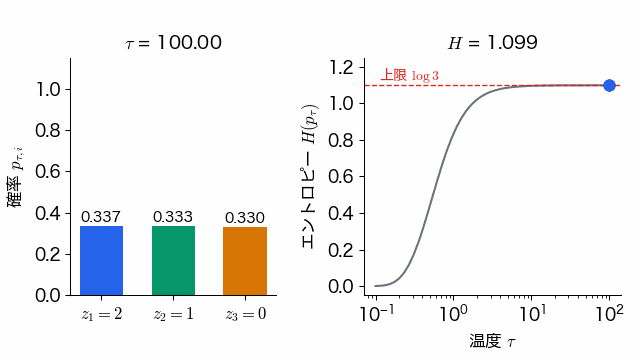
<Example id="ex-temperature" title="ロジット (2, 1, 0) の温度による変化">
$\boldsymbol{z} = (2, 1, 0)$ とします。$\tau = 1$ では $e^2 : e^1 : e^0 = 7.389 : 2.718 : 1$ で、和は $11.107$、$p_1 = (0.6652, 0.2447, 0.0900)$ です。$\tau = 0.5$ ではロジットが $(4, 2, 0)$ になったのと同じで、$\tau = 2$ では $(1, 0.5, 0)$ と同じです。

| $\tau$ | $p_\tau$ | $H(p_\tau)$ |
|---|---|---|
| $0.1$ | $(1.0000,\ 0.0000,\ 0.0000)$ | $0.0005$ |
| $0.5$ | $(0.8668,\ 0.1173,\ 0.0159)$ | $0.4411$ |
| $1$ | $(0.6652,\ 0.2447,\ 0.0900)$ | $0.8324$ |
| $2$ | $(0.5065,\ 0.3072,\ 0.1863)$ | $1.0202$ |
| $100$ | $(0.3367,\ 0.3333,\ 0.3300)$ | $1.0986$ |

（値は第 6 節のコードの出力です。）順位はどの行でも第 1・第 2・第 3 成分の順で、エントロピーは上から下へ増えています。上限は一様分布の $\log 3 \approx 1.0986$ です。
</Example>

温度を $0.1$ から $100$ まで動かすと、棒グラフと右のエントロピーの点がどう動くかを見てください。

<Figure caption="ロジット (2, 1, 0) の温度つき softmax。温度が低いと最大成分に確率が集中し、高いと一様に近づく。右の点は対応するエントロピーで、上限 log 3 に向かって単調に増える。">
<img src="/figures/temperature-softmax-sweep.gif" alt="温度を 0.1 から 100 まで上げていくと、3 本の棒グラフが、第 1 成分だけが 1 の尖った形から、3 本がほぼ同じ高さの平らな形へ変わる。右のグラフではエントロピーの点が 0 から上限 log 3 へ単調に上がる。" loading="lazy" />
</Figure>

## 5. 分布の打ち切り：top-k と top-p

温度を上げると、確率の小さいトークン（分布の裾）にも確率が回ります。裾には文脈に合わないトークンが多く含まれるので、裾を切り落としてから選ぶ方法が使われます。

<Definition id="def-top-k-top-p" title="top-k と top-p（nucleus）サンプリング">
$p$ を $V = \{1, \ldots, N\}$ 上の確率分布とします。添字を確率の降順に、同じ値は添字の昇順に並べたものを $\pi(1), \pi(2), \ldots, \pi(N)$ とし（$p_{\pi(1)} \ge p_{\pi(2)} \ge \cdots$）、累積を $c_j = \sum_{i=1}^{j} p_{\pi(i)}$ とします。

- **top-k 集合**（$1 \le k \le N$）: $S^{(k)} = \{\pi(1), \ldots, \pi(k)\}$。
- **top-p 集合**（しきい値 $0 < \rho \le 1$）: $k(\rho) = \min\{ j : c_j \ge \rho \}$ とし、$S_\rho = \{\pi(1), \ldots, \pi(k(\rho))\}$。
- 集合 $S$（$p(S) > 0$）への**制限**: $p_S(i) = p_i / p(S)$（$i \in S$）、$p_S(i) = 0$（$i \notin S$）。

$p_{S^{(k)}}$ から標本を取ることを **top-k サンプリング**、$p_{S_\rho}$ から標本を取ることを **top-p サンプリング**（nucleus サンプリング）といいます。しきい値 $\rho$ が、通称の「top-p の p」です（分布の記号 $p$ と区別するため、ここでは $\rho$ と書きます）。
</Definition>

<Proposition id="prop-truncation-renormalization" title="打ち切りは条件付き分布である">
$p$ を $V$ 上の確率分布、$S \subset V$ を $p(S) > 0$ である集合とします。

1. $p_S$ は $V$ 上の確率分布で、$p$ に従う確率変数 $X$ の、事象 $\{X \in S\}$ のもとでの条件付き分布に一致します: $p_S(i) = P(X = i \mid X \in S)$。
2. $i, j \in S$、$p_j > 0$ なら $p_S(i) / p_S(j) = p_i / p_j$ です。$S$ の中の確率の比は変わりません。
3. $p$ と $p_S$ の全変動距離は $\frac{1}{2} \sum_i |p_i - p_S(i)| = 1 - p(S)$ です。
</Proposition>

<Proof of="prop-truncation-renormalization">
**1.** 条件付き確率の定義（<Ref to="mathematics/hs-probability/finite-probability#def-conditional-hs" />）から、$i \in S$ なら $P(X = i \mid X \in S) = P(X = i) / P(X \in S) = p_i / p(S)$、$i \notin S$ なら $\{X = i\} \cap \{X \in S\}$ が空なので $0$ です。これは $p_S$ の定義と同じです。条件付き確率が確率分布であることは <Ref to="mathematics/hs-probability/finite-probability#prop-conditional-is-probability" /> です。

**2.** $p_S(i) / p_S(j) = (p_i / p(S)) / (p_j / p(S)) = p_i / p_j$ です。

**3.** $i \in S$ では $p_S(i) - p_i = p_i (1/p(S) - 1) \ge 0$、$i \notin S$ では $p_i - p_S(i) = p_i$ です。したがって

$$
\sum_i |p_i - p_S(i)| = \Bigl(\frac{1}{p(S)} - 1\Bigr) \sum_{i \in S} p_i + \sum_{i \notin S} p_i = \bigl(1 - p(S)\bigr) + \bigl(1 - p(S)\bigr)
$$

で、$\frac{1}{2}$ を掛けると $1 - p(S)$ です。
</Proof>

3 から、top-p サンプリングの意味が読み取れます。$p(S_\rho) \ge \rho$ なので、元の分布からのずれ（全変動距離。2 つの分布の各成分の差の絶対値を足して半分にした量）は $1 - \rho$ 以下です。$\rho = 0.9$ なら、元の分布を高々 $0.1$ だけ動かす操作です。top-k にはこのような保証はなく、分布が平らなときには確率の大部分を捨てることがあります。

top-p 集合の定義は、並べ方 $\pi$ を固定したうえでの「累積がしきい値に届く最小の接頭辞」でした。これが「確率の和がしきい値以上の最小の集合」という言い方とどう対応するかを確定させます。まず補題を置きます。中身は、同じ個数だけ選ぶなら確率の大きいものから順に取るのが和をいちばん大きくする、という事実で、定理の 2 と 3 の証明で使います。

<Lemma id="lem-top-k-max" title="上位 j 個は、大きさ j の集合のうち確率が最大">
<Ref to="def-top-k-top-p" /> の記号のもとで、$|T| = j$ である任意の $T \subset V$ について $p(T) \le c_j = p(S^{(j)})$ です。$p_1, \ldots, p_N$ がすべて異なるなら、等号は $T = S^{(j)}$ のときに限ります。
</Lemma>

<Proof of="lem-top-k-max">
$S = S^{(j)}$ と書きます。$|T| = |S| = j$ なので $|S \setminus T| = |T \setminus S|$ です。この個数を $m$ とし、$S \setminus T = \{a_1, \ldots, a_m\}$、$T \setminus S = \{b_1, \ldots, b_m\}$ と番号を付けます。$a_l \in S$ は並び $\pi$ の初めの $j$ 個に入り、$b_l \notin S$ は入らないので、$a_l$ は $b_l$ より前に並んでいます。並びは確率の降順なので $p_{a_l} \ge p_{b_l}$ です。共通部分 $S \cap T$ の寄与は打ち消し合うので

$$
p(S) - p(T) = \sum_{l=1}^{m} \bigl(p_{a_l} - p_{b_l}\bigr) \ge 0
$$

です。確率がすべて異なるなら各項は正で、$p(S) = p(T)$ となるのは $m = 0$、すなわち $T = S$ のときに限ります。
</Proof>

次の定理は、top-p が「確率の大きい順に取っていき、確率の和がしきい値に届いたところで止める」という操作であり、その結果が 1 通りに決まることを確かめます。たとえば確率が $(0.5, 0.3, 0.2)$、しきい値が $0.6$ なら、$0.5$ だけでは足りず、$0.5 + 0.3 = 0.8$ で届くので上位 2 個が選ばれます。

<Theorem id="thm-top-p-uniqueness" title="top-p 集合の一意性・最小性・単調性">
$p$ を $V = \{1, \ldots, N\}$ 上の確率分布、$0 < \rho \le 1$ とします。

1. （一意性）$k(\rho)$ と $S_\rho$ は一意に定まります。
2. （最小性）$k(\rho) = \min\{ |T| : T \subset V,\ p(T) \ge \rho \}$ です。すなわち $S_\rho$ は、確率の和が $\rho$ 以上である集合のうち、大きさが最小のものの 1 つです。
3. （その大きさの中での最大性）大きさ $k(\rho)$ の集合のうち、$S_\rho$ は確率の和が最大です。$p_1, \ldots, p_N$ がすべて異なるなら、最大を与える集合は $S_\rho$ だけです。
4. （単調性）$\rho \le \rho'$ なら $k(\rho) \le k(\rho')$ で、$S_\rho \subset S_{\rho'}$ です。
5. （両端）$\rho \le p_{\pi(1)}$ なら $S_\rho = \{\pi(1)\}$ で、これは貪欲復号が選ぶトークンです。$\rho = 1$ なら $S_1 = \{ i : p_i > 0 \}$ です。
</Theorem>

<Proof of="thm-top-p-uniqueness">
**1.** 「確率の降順、同じ値は添字の昇順」は添字の全順序なので、並び $\pi$ はただ 1 通りに決まり、$c_1 \le c_2 \le \cdots \le c_N = 1$ も決まります。$c_N = 1 \ge \rho$ なので集合 $\{ j : c_j \ge \rho \}$ は空でなく、自然数の空でない集合には最小元がただ 1 つあります。したがって $k(\rho)$ が、ひいては $S_\rho$ が一意に決まります。

**2.** $S_\rho$ は大きさ $k(\rho)$ で $p(S_\rho) = c_{k(\rho)} \ge \rho$ なので、右辺の最小値は $k(\rho)$ 以下です。逆に $p(T) \ge \rho$ である $T$ を取り、$j = |T|$ とすると、<Ref to="lem-top-k-max" /> により $c_j \ge p(T) \ge \rho$ です。$k(\rho)$ は $c_j \ge \rho$ となる最小の $j$ なので $k(\rho) \le j = |T|$ です。したがって最小値は $k(\rho)$ 以上です。

**3.** <Ref to="lem-top-k-max" /> を $j = k(\rho)$ で使ったものです。

**4.** $\rho \le \rho'$ なら $c_j \ge \rho'$ は $c_j \ge \rho$ を含意するので、$\{ j : c_j \ge \rho' \} \subset \{ j : c_j \ge \rho \}$ です。小さい集合の最小元は、大きい集合の最小元以上なので $k(\rho') \ge k(\rho)$ です。$S_\rho$ と $S_{\rho'}$ はどちらも同じ並び $\pi$ の接頭辞なので、長いほうが短いほうを含みます。

**5.** $c_1 = p_{\pi(1)} \ge \rho$ なら $k(\rho) = 1$ です。$\pi(1)$ は確率が最大の添字のうち最も小さいもので、<Ref to="def-greedy-beam" /> の貪欲復号の選び方と同じです。$\rho = 1$ のとき、正の確率を持つ添字の個数を $s$ とすると、降順の並びでは正の確率のものが初めの $s$ 個を占めます。$j < s$ では $c_j = 1 - \sum_{i > j} p_{\pi(i)} \le 1 - p_{\pi(s)} < 1$、$j = s$ では $c_s = 1$ なので $k(1) = s$ で、$S_1$ は正の確率を持つ添字の全体です。
</Proof>

<Remark id="rem-top-p-not-unique-set">
2 と 3 を合わせても、「大きさが最小で、和が $\rho$ 以上の集合は $S_\rho$ だけ」とは言えません。確率がすべて異なっていても成り立ちません。$p = (0.5, 0.3, 0.2)$、$\rho = 0.6$ では $k(\rho) = 2$、$S_\rho = \{1, 2\}$（和 $0.8$）ですが、$\{1, 3\}$ も大きさ $2$ で和が $0.7 \ge 0.6$ です。Holtzman らの原論文は top-p の語彙を「和がしきい値以上になる最小の集合」と述べていますが、この条件だけでは集合が 1 つに決まらないことがあり、「確率の大きい順に取る」という規則を合わせて初めて一意になります。実装は、並べ替えて累積を取る <Ref to="def-top-k-top-p" /> の形で書くのがふつうです（しきい値ちょうどの扱いや同じ値の並べ方は実装によって違いえます）。
</Remark>

<Example id="ex-top-p" title="確率 (0.5, 0.2, 0.2, 0.1) の top-p 集合">
$p = (0.5, 0.2, 0.2, 0.1)$ とします。第 2・第 3 成分が同じ値なので、添字の昇順で $\pi = (1, 2, 3, 4)$、累積は $c = (0.5, 0.7, 0.9, 1.0)$ です。

- $\rho = 0.6$: $c_1 = 0.5 < 0.6 \le c_2 = 0.7$ なので $k = 2$、$S_\rho = \{1, 2\}$。制限した分布は $(0.5, 0.2)/0.7 = (0.714, 0.286)$ です。同じ確率の第 3 成分は、添字が大きいというだけの理由で外れます。$\{1, 3\}$ も大きさ $2$ で和が $0.7$ なので、<Ref to="thm-top-p-uniqueness" /> の 3 の「最大を与える集合はただ 1 つ」は、同じ値があると成り立ちません。
- $\rho = 0.9$: $c_2 = 0.7 < 0.9 \le c_3 = 0.9$ なので $k = 3$、$S_\rho = \{1, 2, 3\}$。

top-k で $k = 2$ とすれば、分布がどうであっても 2 個です。top-p では、分布が $(0.97, 0.01, 0.01, 0.01)$ なら $\rho = 0.9$ でも 1 個、一様分布 $(0.25, 0.25, 0.25, 0.25)$ なら $\rho = 0.9$ で 4 個と、分布の形に応じて大きさが変わります。

なお、$\rho = 0.9$ の場合は浮動小数点数では別の結果になります。倍精度では $0.5 + 0.2 + 0.2$ が $0.8999999999999999$ と計算され、$0.9$ に届かないので、4 個目まで取られます（次節のコードの出力を見てください）。しきい値ちょうどの場合の集合は、丸め誤差で変わることがあります。
</Example>

## 6. 分布から 1 つ選ぶ：標本抽出と決定性

加工した分布 $q$（温度を掛け、$S$ に制限したもの）から実際に 1 つのトークンを選ぶには、一様乱数を 1 つ使います。

<Proposition id="prop-categorical-sampling" title="累積和による標本抽出の正しさ">
$q$ を $V = \{1, \ldots, N\}$ 上の確率分布、$C_j = \sum_{i \le j} q_i$（$C_0 = 0$、$C_N = 1$）とします。$U$ を区間 $(0, 1)$ 上の一様分布に従う確率変数とし、

$$
X = \min\{ j \in V : C_j \ge U \}
$$

とおくと、すべての $j$ で $P(X = j) = q_j$ です。計算に必要な比較と加算は $O(N)$ 回です。
</Proposition>

<Proof of="prop-categorical-sampling">
$C_N = 1 \ge U$ なので、最小を取る集合は空でなく、$X$ は定義されます。$X = j$ であることは、$C_j \ge U$ かつ $C_{j-1} < U$（$j = 1$ のときは $C_0 = 0 < U$ でつねに成立）と同値です。$C$ は単調非減少なので、$i < j$ のすべてで $C_i < U$ であることは $C_{j-1} < U$ と同じだからです。したがって

$$
P(X = j) = P(C_{j-1} < U \le C_j) = C_j - C_{j-1} = q_j
$$

です（一様分布では、区間 $(a, b]$ に入る確率は長さ $b - a$ です）。

これは逆関数法（<Ref to="computer-science/stochastic-computation/sampling-from-distributions#thm-inverse-transform" />）の離散の場合です。$q$ の分布関数 $F(x) = \sum_{i \le x} q_i$ の一般化逆関数（<Ref to="computer-science/stochastic-computation/sampling-from-distributions#def-quantile" />）は $F^{-}(u) = \inf\{x : F(x) \ge u\} = \min\{ j : C_j \ge u \}$ で、$X = F^{-}(U)$ です。累積和の計算に $N - 1$ 回の加算、最小の $j$ の探索に高々 $N$ 回の比較を使います。
</Proof>

<Remark id="rem-alias-not-useful">
同じ分布から何度も標本を取るなら、$O(N)$ の前処理のあと 1 回あたり $O(1)$ で取れる別名法（<Ref to="computer-science/stochastic-computation/sampling-from-distributions#thm-alias-method" />）があります。しかし言語モデルの生成では、分布は 1 ステップごとに変わり、同じ分布から取る標本は 1 個だけです。前処理が毎回必要になるので、別名法の利点は生きません。そもそも分布を作る softmax の計算が $O(N)$ で、top-p の並べ替えは $O(N \log N)$ なので、標本抽出の $O(N)$ は全体の中で支配的ではありません。
</Remark>

次のコードは、温度・top-k・top-p・制限・標本抽出をそれぞれ数行で実装し、<Ref to="ex-temperature" /> と <Ref to="ex-top-p" /> の値、および標本の経験分布が <Ref to="prop-truncation-renormalization" /> の条件付き分布に近づくことを確かめます。

```python
# Python 3.12.14, NumPy 2.5.2
import numpy as np

def softmax(z, tau=1.0):
    z = np.asarray(z, dtype=float) / tau
    e = np.exp(z - z.max()); return e / e.sum()

def top_k_set(p, k):
    return np.argsort(-p, kind="stable")[:k]           # 降順、同じ値は添字の昇順

def top_p_set(p, top_p):
    order = np.argsort(-p, kind="stable")
    c = np.cumsum(p[order])
    return order[: int(np.searchsorted(c, top_p, side="left")) + 1]   # c_j >= top_p となる最小の j

def restrict(p, S):                                    # S に制限して正規化
    q = np.zeros_like(p); q[S] = p[S] / p[S].sum(); return q

def sample(p, rng):                                    # 累積和と一様乱数
    return int(np.searchsorted(np.cumsum(p), rng.random(), side="right"))

H = lambda p: float(-(p[p > 0] * np.log(p[p > 0])).sum())
for tau in (0.1, 0.5, 1.0, 2.0, 100.0):
    p = softmax([2.0, 1.0, 0.0], tau)
    print(f"tau={tau:6.1f}  p={np.round(p, 4)}  H={H(p):.4f}")
print(f"log 3 = {np.log(3):.4f}")

p = np.array([0.5, 0.2, 0.2, 0.1])
for tp in (0.3, 0.6, 0.9, 1.0):
    print(f"top-p={tp}: set={top_p_set(p, tp).tolist()}", end="   ")
print()
print("cumsum:", np.cumsum(p).tolist())
print("top-k=2:", top_k_set(p, 2).tolist())

z = np.array([3.0, 2.5, 1.0, 0.2, -1.0, -2.0]); p = softmax(z, 0.8)
S = top_p_set(p, 0.95); q = restrict(p, S)
rng = np.random.default_rng(20261010); N = 200000
counts = np.bincount([sample(q, rng) for _ in range(N)], minlength=len(p))
print("p        :", np.round(p, 4))
print("top-p set:", S.tolist(), " mass:", round(float(p[S].sum()), 4))
print("target q :", np.round(q, 4))
print("empirical:", np.round(counts / N, 4))
print("TV(p, q) :", round(0.5 * float(np.abs(p - q).sum()), 4), " 1 - p(S):", round(1 - float(p[S].sum()), 4))
```

```text
tau=   0.1  p=[1. 0. 0.]  H=0.0005
tau=   0.5  p=[0.8668 0.1173 0.0159]  H=0.4411
tau=   1.0  p=[0.6652 0.2447 0.09  ]  H=0.8324
tau=   2.0  p=[0.5065 0.3072 0.1863]  H=1.0202
tau= 100.0  p=[0.3367 0.3333 0.33  ]  H=1.0986
log 3 = 1.0986
top-p=0.3: set=[0]   top-p=0.6: set=[0, 1]   top-p=0.9: set=[0, 1, 2, 3]   top-p=1.0: set=[0, 1, 2, 3]
cumsum: [0.5, 0.7, 0.8999999999999999, 0.9999999999999999]
top-k=2: [0, 1]
p        : [0.6038 0.3232 0.0496 0.0182 0.0041 0.0012]
top-p set: [0, 1, 2]  mass: 0.9765
target q : [0.6183 0.331  0.0508 0.     0.     0.    ]
empirical: [0.6173 0.3322 0.0505 0.     0.     0.    ]
TV(p, q) : 0.0235  1 - p(S): 0.0235
```

コードの添字は $0$ 始まりです。`sample` は $C_j > U$ となる最小の $j$ を返す実装で、<Ref to="prop-categorical-sampling" /> の $C_j \ge U$ とは $U$ がちょうど $C_j$ に等しい場合だけ違いますが、その確率は $0$ です。$20$ 万個の標本の経験分布は目標の条件付き分布と小数第 3 位まで合い、全変動距離は $1 - p(S)$ に一致しています。`top-p=0.9` の行は、<Ref to="ex-top-p" /> で述べた丸め誤差の例です。

この最後の点は、生成の再現性にかかわります。次の命題は、乱数の種を固定すれば出力が決まること（1）と、それでも実行環境によって結果が変わりうる理由（2、3）を述べます。3 に出てくる $u$ は 1 回の演算で生じる誤差の割合の上限（単位丸め）、$\gamma_k$ は $k$ 回の演算を重ねたときの誤差の割合の上限を表す記号です。3 の内容は、足し算の誤差の幅より大きい差がついていれば、足す順序を変えても大小関係は入れ替わらない、ということです。

<Proposition id="prop-sampling-determinism" title="生成の決定性と、浮動小数点演算の順序">
1. 重み、プロンプト、復号の設定（温度、$k$、$\rho$、最大長）、一様乱数の列 $u_1, u_2, \ldots$ を固定し、ロジットの計算が入力の決定的な関数であるとします。このとき自己回帰生成（<Ref to="def-autoregressive-generation" />）の出力は一意に決まります。[擬似乱数生成器](/computer-science/research-computing/reproducible-experiments#def-prng)は種の決定的な関数なので、種を固定すれば出力は再現されます。
2. 浮動小数点数の加算は結合法則を満たしません。倍精度で $(0.1 + 0.2) + 0.3$ は $0.6000000000000001$、$0.1 + (0.2 + 0.3)$ は $0.6$ と計算されます。したがって、和を取る順序が変わると、同じ重みと同じ入力でもロジットの値が変わりえます。
3. あるトークンのロジットが $n$ 個の浮動小数点数 $x_1, \ldots, x_n$ の逐次和として計算され、比べる相手のロジット $z'$ は固定されているとします。ある順序での計算値 $\hat{s}$ が $|\hat{s} - z'| > 2\gamma_{n-1} \sum_i |x_i|$ を満たすなら、$x_1, \ldots, x_n$ をどの順序に並べ替えて逐次和を取っても $z'$ との大小は変わりません（$\gamma_k = ku/(1 - ku)$、$u$ は単位丸め、$(n-1)u < 1$ で、オーバーフローとアンダーフローは起きないとします）。
</Proposition>

<Proof of="prop-sampling-determinism">
**1.** ステップ数についての帰納法です。$x_{<t}$ が決まっていれば、ロジット $\boldsymbol{z}_t$ はその決定的な関数、加工した分布 $q_t$ は $\boldsymbol{z}_t$ と設定の関数（<Ref to="def-temperature" />、<Ref to="def-top-k-top-p" />。<Ref to="thm-top-p-uniqueness" /> の 1 により top-p 集合も一意）、$x_t$ は $q_t$ と $u_t$ の関数（<Ref to="prop-categorical-sampling" /> の $X$ の定義）です。したがって $x_{\le t}$ が決まります。停止の条件も $x_{\le t}$ だけで決まります。

**2.** 倍精度の $0.1$、$0.2$、$0.3$ はどれも 2 進で有限桁に表せない数を丸めたもので、加算のたびに結果が最も近い浮動小数点数に丸められます（<Ref to="mathematics/numerical-analysis/floating-point-arithmetic#def-correct-rounding" />）。丸めが入る位置が 2 つの順序で違うので、結果が違いえます。実際の値は Python で `(0.1 + 0.2) + 0.3` と `0.1 + (0.2 + 0.3)` を評価して確かめられ、前者は `0.6000000000000001`、後者は `0.6` です。

**3.** $s = \sum_i x_i$ を真の和とします。逐次和の誤差の定理（<Ref to="mathematics/numerical-analysis/floating-point-arithmetic#thm-recursive-sum" />）は、足す順序によらず、計算値と $s$ の差が $\gamma_{n-1} \sum_i |x_i|$ 以下であることを与えます（定理を並べ替えた列に使います。$\sum_i |x_i|$ は順序に依りません）。別の順序での計算値を $\hat{s}'$ とすると、三角不等式から $|\hat{s} - \hat{s}'| \le |\hat{s} - s| + |s - \hat{s}'| \le 2\gamma_{n-1} \sum_i |x_i|$ です。$\hat{s} - z' > 2\gamma_{n-1}\sum_i |x_i|$ なら $\hat{s}' - z' \ge (\hat{s} - z') - |\hat{s} - \hat{s}'| > 0$ で、符号は変わりません。$\hat{s} - z'$ が負の場合も同様です。
</Proof>

<Example id="ex-argmax-flip" title="和の順序で最大成分が入れ替わる">
トークン A のロジットが $0.1, 0.2, 0.3$ の和として計算され、トークン B のロジットがちょうど $0.6$（倍精度の値）で、B のほうが添字が小さいとします。

- $(0.1 + 0.2) + 0.3$ の順に足すと A は $0.6000000000000001$ で、B の $0.6$ より大きく、貪欲復号は A を選びます。
- $0.1 + (0.2 + 0.3)$ の順に足すと A は $0.6$ で B と同じ値になり、同じ値は添字の小さいほうを取る規則により B が選ばれます。

2 つの計算値の差は約 $1.1 \times 10^{-16}$ で、<Ref to="prop-sampling-determinism" /> の 3 の幅 $2\gamma_2 \times 0.6 \approx 2.7 \times 10^{-16}$ に収まっています。差がこの幅より大きければ入れ替わりは起きません。入れ替わるのは、上位の 2 つがほぼ同じ値のときだけです。ただし自己回帰生成では、1 か所でトークンが変わると、それ以降の入力が変わり、列全体が別のものになりえます。
</Example>

和の順序は、並列計算のスレッド数、バッチの中での位置、使うハードウェアやライブラリの版によって変わりえます。したがって「種を固定したのに出力が再現しない」ことは、1 の仮定（ロジットの計算が決定的）が実行環境をまたいでは成り立たない、ということで説明がつきます。

## 7. KV キャッシュ

<Ref to="def-autoregressive-generation" /> をそのまま実装すると、1 トークン足すたびに、列全体をモデルに入れ直すことになります。因果マスクつきの注意では、その大部分が前のステップと同じ計算の繰り返しです。

この節では、デコーダの 1 層を次の形に書きます（1 ヘッドの場合。マルチヘッドは同じものをヘッドごとに並べるだけです）。位置 $t$ の層 $\ell$ の出力を $\boldsymbol{h}^{(\ell)}_t \in \mathbb{R}^d$ とし、$\boldsymbol{h}^{(0)}_t$ はトークン $x_t$ の埋め込みと位置 $t$ の符号化から決まるベクトルとします。層 $\ell$ は、行ごとに働く写像 $\kappa_\ell, \nu_\ell, \chi_\ell$（[層正規化](/computer-science/llm-architecture/transformer-block#def-layer-norm)のあとに $W_K, W_V, W_Q$ を掛ける）と $G_\ell$（出力の射影、残差の和、MLP）によって

$$
\boldsymbol{k}^{(\ell)}_s = \kappa_\ell\bigl(\boldsymbol{h}^{(\ell-1)}_s\bigr), \quad
\boldsymbol{v}^{(\ell)}_s = \nu_\ell\bigl(\boldsymbol{h}^{(\ell-1)}_s\bigr), \quad
\boldsymbol{q}^{(\ell)}_t = \chi_\ell\bigl(\boldsymbol{h}^{(\ell-1)}_t\bigr),
$$

$$
\boldsymbol{h}^{(\ell)}_t = G_\ell\Bigl(\boldsymbol{h}^{(\ell-1)}_t,\ \sum_{s=1}^{t} \alpha^{(\ell)}_{ts}\, \boldsymbol{v}^{(\ell)}_s\Bigr), \qquad
\alpha^{(\ell)}_{ts} = \frac{\exp\bigl(\langle \boldsymbol{q}^{(\ell)}_t, \boldsymbol{k}^{(\ell)}_s \rangle / \sqrt{d}\bigr)}{\sum_{s'=1}^{t} \exp\bigl(\langle \boldsymbol{q}^{(\ell)}_t, \boldsymbol{k}^{(\ell)}_{s'} \rangle / \sqrt{d}\bigr)}
$$

と定まります。和が $s \le t$ だけにわたることが因果マスクです（<Ref to="computer-science/llm-architecture/self-attention#prop-mask-as-limit" />）。これは前章の Pre-LN のブロックを位置ごとに書き下したものです。

記号が多いですが、1 層でしていることは 3 つです。(1) 各位置の入力 $\boldsymbol{h}$ から、キー・バリュー・クエリを作ります（$\kappa_\ell, \nu_\ell, \chi_\ell$）。(2) 位置 $t$ のクエリと、位置 $t$ 以前のキーの内積から重み $\alpha$ を作り、バリューを重みつきで足します。(3) その結果を元の $\boldsymbol{h}$ と合わせ、出力の射影・残差・MLP を通して次の層への入力にします（$G_\ell$）。

<Definition id="def-kv-cache" title="KV キャッシュ">
各層 $\ell = 1, \ldots, L$ について、これまでに処理した位置のキーとバリューの列 $\bigl(\boldsymbol{k}^{(\ell)}_s, \boldsymbol{v}^{(\ell)}_s\bigr)_{s \le t}$ を保存したものを **KV キャッシュ**といいます。**キャッシュつきの生成**は、新しいトークン $x_t$ が決まるたびに、$\ell = 1, \ldots, L$ の順に次を行います。

1. $\boldsymbol{h}^{(\ell-1)}_t$ から $\boldsymbol{k}^{(\ell)}_t, \boldsymbol{v}^{(\ell)}_t, \boldsymbol{q}^{(\ell)}_t$ を計算し、$\boldsymbol{k}^{(\ell)}_t, \boldsymbol{v}^{(\ell)}_t$ を層 $\ell$ のキャッシュの末尾に足す。
2. キャッシュにある $s \le t$ のキーとバリューを使って $\alpha^{(\ell)}_{ts}$ と $\boldsymbol{h}^{(\ell)}_t$ を計算する。

位置 $t$ の 1 行だけを計算し、過去の位置の $\boldsymbol{h}^{(\ell)}_s$（$s < t$）は計算し直しません。
</Definition>

<Figure caption="位置 t のトークンを処理するとき、新しく計算するのは注意の重みの第 t 行（色つき）だけである。それより上の行は過去のステップで計算済みで、キーとバリューだけがキャッシュに残っている。">

<svg viewBox="0 0 720 230" width="100%" role="img" aria-label="因果マスクつき注意の重み行列と KV キャッシュ">
  <g fill="none" stroke="currentColor" stroke-width="1.2">
    <path d="M 60 30 L 60 190 L 220 190 Z" />
    <path d="M 60 62 L 92 62 M 60 94 L 124 94 M 60 126 L 156 126 M 60 158 L 188 158" stroke-dasharray="3 3" />
    <rect x="60" y="158" width="160" height="32" stroke="var(--sl-color-accent)" stroke-width="2.2" />
    <rect x="330" y="40" width="150" height="150" rx="6" />
    <path d="M 330 70 L 480 70 M 330 100 L 480 100 M 330 130 L 480 130 M 330 160 L 480 160" />
    <rect x="330" y="160" width="150" height="30" stroke="var(--sl-color-accent)" stroke-width="2.2" />
    <rect x="540" y="40" width="150" height="150" rx="6" />
    <path d="M 540 70 L 690 70 M 540 100 L 690 100 M 540 130 L 690 130 M 540 160 L 690 160" />
    <rect x="540" y="160" width="150" height="30" stroke="var(--sl-color-accent)" stroke-width="2.2" />
  </g>
  <g fill="currentColor" font-size="13" text-anchor="middle">
    <text x="140" y="212">注意の重み（下三角）</text>
    <text x="405" y="212">キーのキャッシュ（t 行）</text>
    <text x="615" y="212">バリューのキャッシュ（t 行）</text>
    <text x="405" y="22">過去の行は保存済み</text>
    <text x="615" y="22">過去の行は保存済み</text>
    <text x="405" y="180">位置 t で追加</text>
    <text x="615" y="180">位置 t で追加</text>
    <text x="34" y="180">t</text>
    <text x="34" y="52">1</text>
  </g>
</svg>

</Figure>

次の定理は、キャッシュを使っても答えが変わらないことを保証します。方針は、因果マスクのおかげで位置 $t$ の値は $t$ 以前のトークンだけで決まる、つまり過去の位置の値は新しいトークンが来ても変わらないので、保存したものを使い回せる、というものです。証明では、層の番号と位置の番号についての帰納法でこれを確かめます。

<Theorem id="thm-kv-cache-correct" title="KV キャッシュの正しさ">
上の形の層を $L$ 個重ねたモデルを考えます。

1. （因果性）各 $\ell$ と $t$ について、$\boldsymbol{h}^{(\ell)}_t$、$\boldsymbol{k}^{(\ell)}_t$、$\boldsymbol{v}^{(\ell)}_t$ は $x_1, \ldots, x_t$ だけの関数です。$t$ より後のトークンにも、列の全体の長さにも依りません。
2. （一致）キャッシュつきの生成が位置 $t$ で計算する $\boldsymbol{h}^{(\ell)}_t$（$\ell = 0, \ldots, L$）は、列 $x_{\le t}$ の全体を入力して計算し直したときの第 $t$ 行と一致します。したがって位置 $t$ のロジットと次のトークンの分布も一致します。
</Theorem>

<Proof of="thm-kv-cache-correct">
**1.** $\ell$ についての帰納法で、「すべての $t$ で $\boldsymbol{h}^{(\ell)}_t$ は $x_{\le t}$ の関数である」ことを示します。$\ell = 0$ では、$\boldsymbol{h}^{(0)}_t$ は $x_t$ と $t$ だけで決まります。$\ell - 1$ で成り立つとします。$\boldsymbol{k}^{(\ell)}_s, \boldsymbol{v}^{(\ell)}_s$ は $\boldsymbol{h}^{(\ell-1)}_s$ の関数なので $x_{\le s}$ の関数です。層の定義の式で $\boldsymbol{h}^{(\ell)}_t$ を与える右辺に現れるのは、$\boldsymbol{h}^{(\ell-1)}_t$ と、$s \le t$ についての $\boldsymbol{k}^{(\ell)}_s, \boldsymbol{v}^{(\ell)}_s$ だけです。これらはすべて $x_{\le t}$ の関数なので、$\boldsymbol{h}^{(\ell)}_t$ もそうです。式に $t$ より大きい添字も列の長さも現れないので、後のトークンにも長さにも依りません。これは因果マスクの定理（<Ref to="computer-science/llm-architecture/self-attention#thm-causal-mask" />）と、それがブロック全体で保たれること（<Ref to="computer-science/llm-architecture/transformer-block#prop-block-equivariance-causality" />）を、位置ごとの式で言い直したものです。

**2.** $t$ についての帰納法で示します。位置 $t$ より前のすべての位置 $s < t$ について、キャッシュに保存された $\boldsymbol{k}^{(\ell)}_s, \boldsymbol{v}^{(\ell)}_s$ が、列 $x_{\le s}$ を入力して計算し直したときの値と一致すると仮定します（$t = 1$ ではキャッシュは空で、仮定は自明に成り立ちます）。1 により、それらは列 $x_{\le t}$ を入力して計算し直したときの第 $s$ 行のキーとバリューとも一致します。

位置 $t$ について、$\ell$ についての帰納法を使います。$\boldsymbol{h}^{(0)}_t$ はどちらの計算でも同じ式（$x_t$ の埋め込みと位置 $t$ の符号化）です。$\boldsymbol{h}^{(\ell-1)}_t$ が一致するなら、それから計算する $\boldsymbol{k}^{(\ell)}_t, \boldsymbol{v}^{(\ell)}_t, \boldsymbol{q}^{(\ell)}_t$ も一致します。キャッシュの $s < t$ の成分は上の仮定により一致しているので、$\alpha^{(\ell)}_{ts}$（$s \le t$）と $\sum_{s \le t} \alpha^{(\ell)}_{ts} \boldsymbol{v}^{(\ell)}_s$ が一致し、$G_\ell$ を通した $\boldsymbol{h}^{(\ell)}_t$ も一致します。同時に、位置 $t$ で新しくキャッシュに足した $\boldsymbol{k}^{(\ell)}_t, \boldsymbol{v}^{(\ell)}_t$ も計算し直した値と一致するので、帰納法の仮定が $t + 1$ に引き継がれます。ロジットは $\boldsymbol{h}^{(L)}_t$ の関数なので、一致します。
</Proof>

証明が使ったのは「層の式に $t$ より後の添字が現れない」ことだけです。逆に、これが崩れるとキャッシュは使えません。双方向の注意（各位置が後ろも見るもの）では、トークンを足すたびに過去の位置の出力がすべて変わります。また、プロンプトの途中のトークンを 1 つ書き換えると、その位置以降のキャッシュはすべて無効になります。有効なまま残るのは、書き換えた位置より前の部分だけです。

次の定理では、スカラーの乗算の回数を数えます。数え方は、$a \times b$ 行列と $b \times c$ 行列の積が $abc$ 回、という 1 つの規則だけです。たとえば位置 $t$ の 1 行（$1 \times d$）に $d \times d$ の行列 $W_Q, W_K, W_V, W_O$ を掛けると、1 つあたり $d^2$ 回で、4 つ合わせて $4d^2$ 回になります。これが式に出てくる $4d^2$ の由来です。

<Theorem id="thm-kv-cache-cost" title="KV キャッシュの計算量と記憶量">
1 ヘッドの層（$W_Q, W_K, W_V, W_O$ は $d \times d$、MLP は $d \to d_{\mathrm{ff}} \to d$）で、スカラーの乗算の回数を数えます（層正規化、活性化関数、softmax の指数は数えません）。$n$ 個の位置 $t = 1, \ldots, n$ を順に処理するとします。

1. キャッシュつきでは、位置 $t$ の 1 層の乗算は $2td + 4d^2 + 2d\, d_{\mathrm{ff}}$ 回で、$n$ 個の合計は
$$
C_{\mathrm{cache}}(n) = d\, n(n+1) + n\,(4d^2 + 2d\, d_{\mathrm{ff}})
$$
です。
2. キャッシュなしで、位置 $t$ のたびに長さ $t$ の列全体を計算し直すと、1 層の乗算は $2t^2 d + t(4d^2 + 2d\, d_{\mathrm{ff}})$ 回で、合計は
$$
C_{\mathrm{full}}(n) = \frac{d\, n(n+1)(2n+1)}{3} + \frac{n(n+1)}{2}(4d^2 + 2d\, d_{\mathrm{ff}})
$$
です。
3. $d_{\mathrm{ff}} = 4d$ のとき、$C_{\mathrm{cache}}(n) = d\,n(n+1) + 12 n d^2 = O(n^2 d + n d^2)$、$C_{\mathrm{full}}(n) = \frac{1}{3} d\,n(n+1)(2n+1) + 6 d^2 n(n+1) = O(n^3 d + n^2 d^2)$ です。
4. キャッシュが保存する数の個数は、$L$ 層・$n$ 位置で $2 L n d$ です。
</Theorem>

<Proof of="thm-kv-cache-cost">
$a \times b$ 行列と $b \times c$ 行列の積は $abc$ 回の乗算を使います。

**1.** 位置 $t$ の 1 行（$1 \times d$）について、$W_Q, W_K, W_V$ を掛けるのに $3d^2$ 回、$\boldsymbol{q}_t$ とキャッシュの $t$ 個のキーとの内積に $td$ 回、重み $\alpha_{ts}$ と $t$ 個のバリューの積の和に $td$ 回、$W_O$ に $d^2$ 回、MLP の 2 つの行列に $d\,d_{\mathrm{ff}} + d_{\mathrm{ff}}\,d$ 回です。合計は $2td + 4d^2 + 2d\,d_{\mathrm{ff}}$ です。$t = 1, \ldots, n$ について足すと、$\sum_{t=1}^{n} t = n(n+1)/2$ から $2d \cdot n(n+1)/2 + n(4d^2 + 2d\,d_{\mathrm{ff}})$ です。

**2.** 長さ $t$ の列全体（$t \times d$）では、$W_Q, W_K, W_V$ に $3td^2$ 回、$t \times t$ の内積の行列に $t^2 d$ 回、重みの行列（$t \times t$）とバリュー（$t \times d$）の積に $t^2 d$ 回、$W_O$ に $td^2$ 回、MLP に $2td\,d_{\mathrm{ff}}$ 回で、合計 $2t^2 d + t(4d^2 + 2d\,d_{\mathrm{ff}})$ です。$\sum_{t=1}^{n} t^2 = n(n+1)(2n+1)/6$ と $\sum_{t=1}^{n} t = n(n+1)/2$ を使うと主張の式になります。

2 つの和の公式は $n$ についての帰納法で確かめられます。$n = 1$ ではどちらも $1$ です。$n$ で成り立つとすると、$\frac{n(n+1)}{2} + (n+1) = \frac{(n+1)(n+2)}{2}$、また

$$
\frac{n(n+1)(2n+1)}{6} + (n+1)^2 = \frac{(n+1)\bigl(2n^2 + n + 6n + 6\bigr)}{6} = \frac{(n+1)(n+2)(2n+3)}{6}
$$

で、$n + 1$ でも成り立ちます。

**3.** $d_{\mathrm{ff}} = 4d$ を入れると $4d^2 + 2d\,d_{\mathrm{ff}} = 12d^2$ です。$n(n+1) \le 2n^2$、$n(n+1)(2n+1) \le 6n^3$ なので、$C_{\mathrm{cache}}(n) \le 2n^2 d + 12nd^2$、$C_{\mathrm{full}}(n) \le 2n^3 d + 12 n^2 d^2$ で、$O$ 記法の定義（<Ref to="computer-science/algorithms/complexity-and-big-o#def-big-o" />）と和の規則（<Ref to="computer-science/algorithms/complexity-and-big-o#prop-calculus" />）から主張が従います。

**4.** 各層は位置ごとにキー $d$ 個とバリュー $d$ 個の数を保存するので、1 層・1 位置あたり $2d$ 個、全体で $2Lnd$ 個です。
</Proof>

マルチヘッド（$h$ ヘッド、ヘッドあたりの次元 $d/h$）でも、内積と重みつき和の乗算はヘッドごとに $t \cdot d/h$ 回、合わせて $td$ 回ずつで、同じ数になります。

<Example id="ex-kv-cache-numbers" title="n = 1000, d = 1000 での演算回数">
$n = d = 1000$、$d_{\mathrm{ff}} = 4d$ とします。1 層あたり

$$
C_{\mathrm{cache}} = 1000 \times 1000 \times 1001 + 12 \times 1000 \times 10^6 = 1.001 \times 10^9 + 1.2 \times 10^{10} \approx 1.30 \times 10^{10},
$$

$$
C_{\mathrm{full}} = \frac{1000 \times 1000 \times 1001 \times 2001}{3} + 6 \times 10^6 \times 1000 \times 1001 \approx 6.68 \times 10^{11} + 6.01 \times 10^{12} \approx 6.67 \times 10^{12}
$$

で、比は約 $513$ です。キャッシュつきの場合、$n = d$ では注意の項（$1.0 \times 10^9$）は線形写像と MLP の項（$1.2 \times 10^{10}$）の $1/12$ 程度にすぎません。$n$ が $12d$ を超えたあたりで、注意の項のほうが大きくなります。

記憶量は 1 層あたり $2nd = 2 \times 10^6$ 個で、$L$ 層なら $2L \times 10^6$ 個です。文脈長 $n$ に比例して増えます。
</Example>

$C_{\mathrm{cache}}(n) = d\,n(n+1) + 12nd^2$ は、長さ $n$ の列を 1 回だけ順伝播する回数 $2n^2 d + 12 n d^2$（2 の $t = n$ の場合）と同じオーダーです（線形写像と MLP の項は同じで、注意の項は約半分です。2 の数え方は因果マスクで捨てる上三角の対も計算しているためです）。キャッシュつきの生成全体の計算量は、できあがった列を 1 回読むのと同じ程度だということになります。プロンプトの部分は、実際には 1 回の順伝播でまとめて処理し、その過程でキャッシュを満たします。

次のコードは、小さなモデル（乱数の重み、$L = 2$、$d = 32$）で貪欲復号を 2 通りに実行し、ロジットが一致することと、乗算の回数が <Ref to="thm-kv-cache-cost" /> の式に一致することを確かめます。

```python
# Python 3.12.14, NumPy 2.5.2
import numpy as np
rng = np.random.default_rng(20261010)
V, d, dff, L, n_max = 50, 32, 128, 2, 64
E = rng.normal(0, 0.5, (V, d)); pos = rng.normal(0, 0.5, (n_max, d))
W = [{k: rng.normal(0, d ** -0.5, s) for k, s in
      [("q", (d, d)), ("k", (d, d)), ("v", (d, d)), ("o", (d, d)), ("1", (d, dff)), ("2", (dff, d))]}
     for _ in range(L)]
count = 0

def mm(a, b):                      # 行列積。スカラーの乗算の回数を数える
    global count
    count += a.shape[0] * a.shape[1] * b.shape[1]
    return a @ b

def ln(h):
    return (h - h.mean(axis=1, keepdims=True)) / np.sqrt(h.var(axis=1, keepdims=True) + 1e-5)

def softmax_rows(S):
    A = np.exp(S - S.max(axis=1, keepdims=True)); return A / A.sum(axis=1, keepdims=True)

def forward_full(ids):             # キャッシュなし: t 個の位置を全部計算し直す
    t = len(ids); h = E[ids] + pos[:t]
    mask = np.triu(np.full((t, t), -np.inf), 1)
    for w in W:
        a = ln(h); q, k, v = mm(a, w["q"]), mm(a, w["k"]), mm(a, w["v"])
        A = softmax_rows(mm(q, k.T) / np.sqrt(d) + mask)
        h = h + mm(mm(A, v), w["o"])
        h = h + mm(np.maximum(mm(ln(h), w["1"]), 0), w["2"])
    return ln(h)[-1] @ E.T         # 最後の位置のロジット

def forward_cached(tok, t, cache):  # キャッシュあり: 位置 t の 1 行だけ計算する
    h = (E[tok] + pos[t])[None, :]
    for w, c in zip(W, cache):
        a = ln(h); q = mm(a, w["q"])
        c["k"].append(mm(a, w["k"])[0]); c["v"].append(mm(a, w["v"])[0])
        K, Vm = np.array(c["k"]), np.array(c["v"])
        A = softmax_rows(mm(q, K.T) / np.sqrt(d))          # 過去と自分だけ。マスクは不要
        h = h + mm(mm(A, Vm), w["o"])
        h = h + mm(np.maximum(mm(ln(h), w["1"]), 0), w["2"])
    return ln(h)[0] @ E.T

for n in (8, 16, 32, 64):
    ids = [7]; count = 0; logits_full = []
    for t in range(n):                                     # 貪欲復号で n 個の位置を処理
        z = forward_full(np.array(ids)); logits_full.append(z); ids.append(int(z.argmax()))
    c_full = count
    ids2 = [7]; count = 0; cache = [{"k": [], "v": []} for _ in range(L)]; diff = 0.0
    for t in range(n):
        z = forward_cached(ids2[-1], t, cache); diff = max(diff, float(np.abs(z - logits_full[t]).max()))
        ids2.append(int(z.argmax()))
    c_cache = count
    f_cache = L * (d * n * (n + 1) + 12 * n * d * d)
    f_full = L * (d * n * (n + 1) * (2 * n + 1) // 3 + 6 * d * d * n * (n + 1))
    print(f"n={n:3d} same tokens={ids == ids2} max|dlogit|={diff:.1e} "
          f"mults full={c_full:>10,} cached={c_cache:>9,} ratio={c_full / c_cache:6.2f} "
          f"formula ok={c_full == f_full and c_cache == f_cache}")
print("cache size (numbers):", sum(len(c["k"]) * d + len(c["v"]) * d for c in cache), "= 2*L*n*d =", 2 * L * 64 * d)
```

```text
n=  8 same tokens=True max|dlogit|=8.9e-15 mults full=   910,848 cached=  201,216 ratio=  4.53 formula ok=True
n= 16 same tokens=True max|dlogit|=8.9e-15 mults full= 3,533,824 cached=  410,624 ratio=  8.61 formula ok=True
n= 32 same tokens=True max|dlogit|=8.9e-15 mults full=14,440,448 cached=  854,016 ratio= 16.91 formula ok=True
n= 64 same tokens=True max|dlogit|=8.9e-15 mults full=62,566,400 cached=1,839,104 ratio= 34.02 formula ok=True
cache size (numbers): 8192 = 2*L*n*d = 8192
```

生成されたトークンは 2 通りで同じで、ロジットの差は $10^{-14}$ 程度です。数学的には一致する（<Ref to="thm-kv-cache-correct" />）2 つの計算が、ぴったり $0$ の差にならないのは、行列全体で計算するときと 1 行ずつ計算するときとで、浮動小数点演算の順序が違うからです（<Ref to="prop-sampling-determinism" /> の 2）。乗算の回数は式と完全に一致し、比は $n$ にほぼ比例して大きくなっています。

## 8. 量子化

学習済みの重みは、ふつう 32 ビットか 16 ビットの浮動小数点数で保存されます。これをより少ないビット数の整数に丸めて、記憶量と計算量を減らすのが量子化です。

<Definition id="def-uniform-quantization" title="一様量子化">
$a > 0$、整数 $b \ge 1$ に対して、刻みを $\Delta = \dfrac{2a}{2^b - 1}$ とし、区間 $[-a, a]$ の上の $2^b$ 個の**水準** $\ell_j = -a + j\Delta$（$j = 0, 1, \ldots, 2^b - 1$）を取ります。$w \in [-a, a]$ を、最も近い水準（同じ距離のものが 2 つあるときはどちらか）に移す写像 $Q$ を **$b$ ビットの一様量子化**、$w - Q(w)$ を**量子化誤差**といいます。行列には成分ごとに適用します。保存するのは番号 $j$（$b$ ビットの整数）と、行列ごとの $a$ だけです。
</Definition>

次の命題は、重みを丸めたときの誤差がどれだけになりうるかの最悪値を与えます。2 に出てくるフロベニウスノルム $\|W\|_F$ は、行列の全成分の二乗和の平方根のことです。2 の 2 番目の不等式は、丸めた行列を掛けたときの出力ベクトルのずれも、同じ量で上から押さえられることを言っています。

<Proposition id="prop-quantization-error" title="一様量子化の誤差の上界">
<Ref to="def-uniform-quantization" /> の記号のもとで、次が成り立ちます。

1. すべての $w \in [-a, a]$ で $|w - Q(w)| \le \Delta / 2$ です。
2. 成分がすべて $[-a, a]$ に入る $W \in \mathbb{R}^{m \times n}$ について $\|W - Q(W)\|_F \le \dfrac{\Delta}{2} \sqrt{mn}$ で、任意の $\boldsymbol{x} \in \mathbb{R}^n$ について $\|(W - Q(W))\boldsymbol{x}\| \le \dfrac{\Delta}{2} \sqrt{mn}\, \|\boldsymbol{x}\|$ です。
3. $b$ ビットの刻みを $\Delta_b$ と書くと、$\dfrac{\Delta_{b+1}}{\Delta_b} = \dfrac{2^b - 1}{2^{b+1} - 1} < \dfrac{1}{2}$ で、$b \to \infty$ のとき $\dfrac{1}{2}$ に収束します。
4. 量子化誤差 $e$ が区間 $[-\Delta/2, \Delta/2]$ 上の一様分布に従うという模型のもとでは、$\mathbb{E}[e] = 0$、$\mathrm{Var}(e) = \Delta^2 / 12$ です。
</Proposition>

<Proof of="prop-quantization-error">
**1.** $\ell_0 = -a$、$\ell_{2^b - 1} = -a + (2^b - 1)\Delta = a$ なので、水準は $[-a, a]$ を長さ $\Delta$ の $2^b - 1$ 個の小区間 $[\ell_j, \ell_{j+1}]$ に分けます。$w$ はそのどれかに入ります。$w - \ell_j$ と $\ell_{j+1} - w$ は非負で和が $\Delta$ なので、小さいほうは $\Delta/2$ 以下です。$Q(w)$ は最も近い水準なので、$|w - Q(w)| \le \min(w - \ell_j, \ell_{j+1} - w) \le \Delta/2$ です。

**2.** $E = W - Q(W)$ とおくと、1 から各成分は $|E_{ij}| \le \Delta/2$ です。$\|E\|_F^2 = \sum_{i,j} E_{ij}^2 \le mn\, \Delta^2 / 4$ で、平方根を取れば最初の不等式です。$E$ の第 $i$ 行を $\boldsymbol{e}_i$ とすると、$(E\boldsymbol{x})_i = \langle \boldsymbol{e}_i, \boldsymbol{x} \rangle$ で、コーシー・シュワルツの不等式（<Ref to="mathematics/linear-algebra/inner-product-spaces#thm-cauchy-schwarz" />）から $(E\boldsymbol{x})_i^2 \le \|\boldsymbol{e}_i\|^2 \|\boldsymbol{x}\|^2$ です。$i$ について足すと $\|E\boldsymbol{x}\|^2 \le \sum_i \|\boldsymbol{e}_i\|^2\, \|\boldsymbol{x}\|^2 = \|E\|_F^2 \|\boldsymbol{x}\|^2$ で、最初の不等式と合わせて 2 番目の不等式です。

**3.** $\Delta_{b+1} / \Delta_b = \dfrac{2a}{2^{b+1} - 1} \cdot \dfrac{2^b - 1}{2a} = \dfrac{2^b - 1}{2^{b+1} - 1}$ です。$2(2^b - 1) = 2^{b+1} - 2 < 2^{b+1} - 1$ なので、この比は $1/2$ より小さくなります。分子と分母を $2^b$ で割ると $\dfrac{1 - 2^{-b}}{2 - 2^{-b}}$ で、$b \to \infty$ のとき $1/2$ に収束します。

**4.** 一様分布の密度は $1/\Delta$ です。密度が原点について対称なので $\mathbb{E}[e] = \int_{-\Delta/2}^{\Delta/2} \frac{e}{\Delta}\, de = 0$ で、

$$
\mathrm{Var}(e) = \mathbb{E}[e^2] = \int_{-\Delta/2}^{\Delta/2} \frac{e^2}{\Delta}\, de = \frac{1}{\Delta} \cdot \frac{2}{3} \Bigl(\frac{\Delta}{2}\Bigr)^3 = \frac{\Delta^2}{12}
$$

です（分散の定義は <Ref to="mathematics/probability/random-variables#def-variance-covariance" />）。
</Proof>

1〜3 は仮定のない上界です。4 は模型の中での計算で、誤差が一様に分布するという仮定は、重みの分布が刻みに比べてなだらかなときの近似です。この模型では $\mathbb{E}\|W - Q(W)\|_F^2 = mn\Delta^2/12$ となり、典型的な誤差 $\Delta\sqrt{mn/12}$ は 2 の上界の $1/\sqrt{3} \approx 0.58$ 倍です。

<Example id="ex-quantization-bits" title="8 ビットと 4 ビットの誤差の上界">
$a = 1$ とします。

- $b = 8$: 水準は $256$ 個、$\Delta = 2/255 \approx 0.00784$、1 成分の誤差は $\Delta/2 \approx 0.0039$ 以下。
- $b = 4$: 水準は $16$ 個、$\Delta = 2/15 \approx 0.133$、誤差は $0.067$ 以下。
- $b = 2$: 水準は $4$ 個（$-1, -1/3, 1/3, 1$）、$\Delta = 2/3$、誤差は $0.33$ 以下。

ビット数を半分にすると、上界は $2$ 分の $1$ ではなく、$8 \to 4$ で $17$ 倍、$4 \to 2$ で $5$ 倍になります。1 ビット減らすごとに約 $2$ 倍なので、4 ビット減らせば約 $2^4$ 倍です。

水準の数 $2^b$ は偶数で、水準は原点について対称に並ぶので、$0$ は水準になりません（$-a + j\Delta = 0$ は $j = (2^b - 1)/2$ を要求しますが、これは整数ではありません）。$0$ に最も近い水準は $\pm\Delta/2$ です。実際の方式には、$0$ を正確に表せるように水準をずらすもの（Jacob らの方式はその 1 つです）があります。
</Example>

```python
# Python 3.12.14, NumPy 2.5.2
import numpy as np
rng = np.random.default_rng(20261010)

def quantize(W, a, b):
    """[-a, a] を 2^b 個の等間隔の水準に分け、最も近い水準に丸める。"""
    delta = 2 * a / (2 ** b - 1)
    j = np.clip(np.round((W + a) / delta), 0, 2 ** b - 1)     # 水準の番号（b ビットの整数）
    return -a + j * delta, delta

m, n = 64, 48
W = rng.normal(0, 0.05, (m, n)); x = rng.normal(size=n)
a = float(np.abs(W).max())
print(f"a = max|W| = {a:.4f}")
print(" b     delta   max|err|  delta/2   ||W-Q||_F    bound   delta*sqrt(mn/12)  ||(W-Q)x||  bound")
for b in (8, 4, 2):
    Q, delta = quantize(W, a, b); Err = W - Q
    print(f"{b:2d}  {delta:8.5f}  {np.abs(Err).max():8.5f} {delta/2:8.5f}  {np.linalg.norm(Err):9.5f} "
          f"{delta/2*np.sqrt(m*n):8.5f}  {delta*np.sqrt(m*n/12):12.5f}  {np.linalg.norm(Err@x):12.5f} "
          f"{delta/2*np.sqrt(m*n)*np.linalg.norm(x):8.5f}")

# 外れ値が 1 つあると、範囲 a が広がって刻みが粗くなる
W2 = W.copy(); W2[0, 0] = 1.0
for a2 in (float(np.abs(W2).max()), a):
    Q2, delta2 = quantize(W2, a2, 4); Err2 = W2 - Q2
    print(f"b=4, a={a2:.4f}: delta={delta2:.5f}  ||W-Q||_F={np.linalg.norm(Err2):.5f}  "
          f"distinct levels used={len(np.unique(Q2))}  error at outlier={abs(Err2[0, 0]):.4f}")
```

```text
a = max|W| = 0.1753
 b     delta   max|err|  delta/2   ||W-Q||_F    bound   delta*sqrt(mn/12)  ||(W-Q)x||  bound
 8   0.00137   0.00069  0.00069    0.02211  0.03810       0.02200       0.02166  0.28016
 4   0.02337   0.01168  0.01169    0.37493  0.64773       0.37397       0.41510  4.76279
 2   0.11687   0.05842  0.05843    1.90140  3.23866       1.86984       2.34504 23.81393
b=4, a=1.0000: delta=0.13333  ||W-Q||_F=2.21452  distinct levels used=5  error at outlier=0.0000
b=4, a=0.1753: delta=0.02337  ||W-Q||_F=0.90588  distinct levels used=16  error at outlier=0.8247
```

読み取れることは次のとおりです。

- 1 成分の誤差の最大値は、どのビット数でも $\Delta/2$ にほぼ届いていて、<Ref to="prop-quantization-error" /> の 1 の上界はこれ以上改善できません。
- フロベニウスノルムの実測値は、上界 $\frac{\Delta}{2}\sqrt{mn}$ の約 $0.58$ 倍で、一様分布の模型の値 $\Delta\sqrt{mn/12}$ とよく合っています。
- $\|(W - Q)\boldsymbol{x}\|$ の上界は実測の $10$ 倍以上で、かなり緩い評価です。上界は誤差の符号がすべて $\boldsymbol{x}$ と揃う最悪の場合を想定していますが、実際の誤差は符号がばらばらで、打ち消し合うからです。
- 最後の 2 行は範囲 $a$ の選び方の例です。$1.0$ という外れ値が 1 つ入った行列を、$a = \max |W| = 1$ で 4 ビットに量子化すると、$16$ 個の水準のうち $5$ 個しか使われず、誤差は $2.21$ になります。$a$ を外れ値を除いた最大値 $0.175$ にして外れ値を切り詰めると、外れ値 1 つに $0.82$ の誤差が出る代わりに、全体の誤差は $0.91$ に減ります。範囲の決め方は誤差に大きく効きますが、どの決め方が良いかは重みの分布に依ります。

量子化したモデルの出力がどれだけ変わるかは、この上界を層の数だけ重ねても良い評価になりません（誤差が非線形の層を通って伝わるため）。何ビットまで落として実用になるかは、モデルと課題ごとに測るしかない経験的な問いです。

## 9. この章で扱わなかった復号の工夫

<Remark id="rem-other-decoding">
実際の生成では、ここまでの操作のほかに次のようなものが使われます。いずれも「ロジットか候補の集合を加工してから選ぶ」という同じ枠の中にあります。

- **繰り返しへのペナルティ**: すでに出力したトークンのロジットを下げます。<Ref to="thm-softmax-temperature-limit" /> の 3 と違い、成分の順位を変える操作です。
- **長さの正規化**: ビーム探索で、列の確率の対数を長さで割って比べます。確率は因子を掛けるほど小さくなるので、正規化しないと短い列が有利になります。
- **制約つき復号**: 出力が決まった書式（たとえばある文法）に従うように、その時点で文法上許されるトークンの集合 $S$ に分布を制限します。<Ref to="prop-truncation-renormalization" /> がそのまま当てはまり、$S$ の中の確率の比は保たれます。
- **投機的復号**: 小さなモデルで数トークン先まで下書きし、大きなモデルで検証して受け入れるか決める方法です。

これらの既定値や組み合わせは実装ごとに違い、変わりうるので、ここでは挙げません。
</Remark>

## 10. 演習

<Exercise id="exr-temperature-two" difficulty="易">
ロジットが $\boldsymbol{z} = (1, 0)$ の 2 トークンの分布を考えます。温度 $\tau$ の分布で第 1 成分の確率がちょうど $0.9$ になる $\tau$ を求めてください。また $\tau = 1$ のときの確率とエントロピーを求め、求めた $\tau$ でのエントロピーと比べてください。
<Solution>
$p_{\tau,1} = \dfrac{e^{1/\tau}}{e^{1/\tau} + 1} = 0.9$ から $e^{1/\tau} = 9$、$\tau = 1/\log 9 \approx 0.455$ です。

$\tau = 1$ では $p = (e/(e+1), 1/(e+1)) \approx (0.731, 0.269)$ で、$H = -0.731 \log 0.731 - 0.269 \log 0.269 \approx 0.229 + 0.353 = 0.582$ です。$\tau = 0.455$ では $p = (0.9, 0.1)$ で、$H = -0.9 \log 0.9 - 0.1 \log 0.1 \approx 0.095 + 0.230 = 0.325$ です。温度を下げたのでエントロピーは減っていて、<Ref to="thm-softmax-temperature-limit" /> の 4 と合います。
</Solution>
</Exercise>

<Exercise id="exr-top-p-compute" difficulty="標準">
$p = (0.4, 0.3, 0.15, 0.1, 0.05)$ とします。$\rho = 0.5, 0.8, 0.95$ のそれぞれについて top-p 集合 $S_\rho$ を求めてください。$\rho = 0.8$ について、制限した分布と、元の分布との全変動距離を求めてください。
<Solution>
確率はすでに降順で、累積は $c = (0.4, 0.7, 0.85, 0.95, 1.0)$ です。

- $\rho = 0.5$: $c_1 = 0.4 < 0.5 \le c_2$ なので $S_\rho = \{1, 2\}$。
- $\rho = 0.8$: $c_2 = 0.7 < 0.8 \le c_3 = 0.85$ なので $S_\rho = \{1, 2, 3\}$。
- $\rho = 0.95$: $c_3 = 0.85 < 0.95 \le c_4 = 0.95$ なので $S_\rho = \{1, 2, 3, 4\}$。

$\rho = 0.8$ では $p(S_\rho) = 0.85$ で、制限した分布は $(0.4, 0.3, 0.15)/0.85 \approx (0.471, 0.353, 0.176)$、残りは $0$ です。全変動距離は <Ref to="prop-truncation-renormalization" /> の 3 から $1 - 0.85 = 0.15$ で、$1 - \rho = 0.2$ 以下です。
</Solution>
</Exercise>

<Exercise id="exr-kv-cache-memory" difficulty="標準">
$L = 12$、$d = 768$、$d_{\mathrm{ff}} = 4d$ のモデルで、$n = 1024$ 個の位置を処理したとします。(1) KV キャッシュが保存する数の個数と、1 個を 4 バイトで持つときのバイト数を求めてください。(2) キャッシュつきで $t = 1024$ 番目の位置を処理するときの 1 層の乗算の回数を求め、そのうち注意（内積と重みつき和）が占める割合を答えてください。
<Solution>
(1) <Ref to="thm-kv-cache-cost" /> の 4 から $2Lnd = 2 \times 12 \times 1024 \times 768 = 18{,}874{,}368$ 個で、4 バイトずつなら $75{,}497{,}472$ バイト（約 $75.5$ MB）です。

(2) <Ref to="thm-kv-cache-cost" /> の 1 から $2td + 12d^2 = 2 \times 1024 \times 768 + 12 \times 768^2 = 1{,}572{,}864 + 7{,}077{,}888 = 8{,}650{,}752$ 回です。注意の部分は $1{,}572{,}864$ 回で、約 $18\%$ です。この大きさの $n$ と $d$ では、1 ステップの計算の大部分は線形写像と MLP です。
</Solution>
</Exercise>

<Exercise id="exr-quantization-3bit" difficulty="標準">
$a = 1$、$b = 3$ の一様量子化の水準をすべて書き、$Q(0.2)$ と $Q(0.5)$ を求めてください。また、$|w - Q(w)| = \Delta/2$ となる $w$ を 1 つ挙げ、<Ref to="prop-quantization-error" /> の 1 の上界が達成されることを確かめてください。
<Solution>
$\Delta = 2/7$ で、水準は $-1, -5/7, -3/7, -1/7, 1/7, 3/7, 5/7, 1$ の $8$ 個です。

$0.2$ は $1/7 \approx 0.143$ と $3/7 \approx 0.429$ の間にあり、$1/7$ までの距離は $0.057$、$3/7$ までは $0.229$ なので $Q(0.2) = 1/7$ です。$0.5$ は $3/7 \approx 0.429$ と $5/7 \approx 0.714$ の間で、距離は $0.071$ と $0.214$ なので $Q(0.5) = 3/7$ です。

$w = 0$ は $-1/7$ と $1/7$ のちょうど中間で、どちらに丸めても $|w - Q(w)| = 1/7 = \Delta/2$ です。<Ref to="ex-quantization-bits" /> で見たとおり $0$ は水準でなく、上界がちょうど達成される点になっています。
</Solution>
</Exercise>

## 参考文献

- A. Holtzman, J. Buys, L. Du, M. Forbes, Y. Choi, "The Curious Case of Neural Text Degeneration", ICLR 2020, [arXiv:1904.09751](https://arxiv.org/abs/1904.09751) — nucleus（top-p）サンプリングの定義と、確率を最大化する復号についての観察。
- A. Fan, M. Lewis, Y. Dauphin, "Hierarchical Neural Story Generation" (2018), [arXiv:1805.04833](https://arxiv.org/abs/1805.04833) — top-k サンプリングを使った生成。
- I. Sutskever, O. Vinyals, Q. V. Le, "Sequence to Sequence Learning with Neural Networks" (2014), [arXiv:1409.3215](https://arxiv.org/abs/1409.3215) — ビーム探索による復号。
- A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, Ł. Kaiser, I. Polosukhin, "Attention Is All You Need" (2017), [arXiv:1706.03762](https://arxiv.org/abs/1706.03762) — 因果マスクつきのデコーダ。
- B. Jacob, S. Kligys, B. Chen, M. Zhu, M. Tang, A. Howard, H. Adam, D. Kalenichenko, "Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference" (2017), [arXiv:1712.05877](https://arxiv.org/abs/1712.05877) — 整数演算だけで推論するための量子化。